Sebastian Raschka 详解现代大模型位置编码:从 RoPE 原理到架构演进趋势
Understanding Positional Embeddings in Modern LLMs
Sebastian Raschka 发布长文,系统梳理现代大语言模型编码 token 位置信息的核心机制与最新演进趋势。文章对比了 GPT-2 的绝对位置嵌入与正弦位置编码,并通过几何图解和 PyTorch 代码深入推导了 RoPE 的成对特征旋转与相对偏移不变性原理。
文章通过几何图解与 PyTorch 代码拆解了 RoPE 的运算机制,并系统梳理了主流模型采用 Partial RoPE 与 NoPE 混合架构的演进趋势。
本文将系统讲解大语言模型(LLM)如何编码和处理 token 的位置信息,涵盖从经典方案到 RoPE 等现代方法。我们将通过直观的图解、少许数学推导和一个小巧的 PyTorch 实现,一步步拆解其内部机制。当然,最后我们还会探讨现代模型架构如何改进或干脆省去显式位置编码。
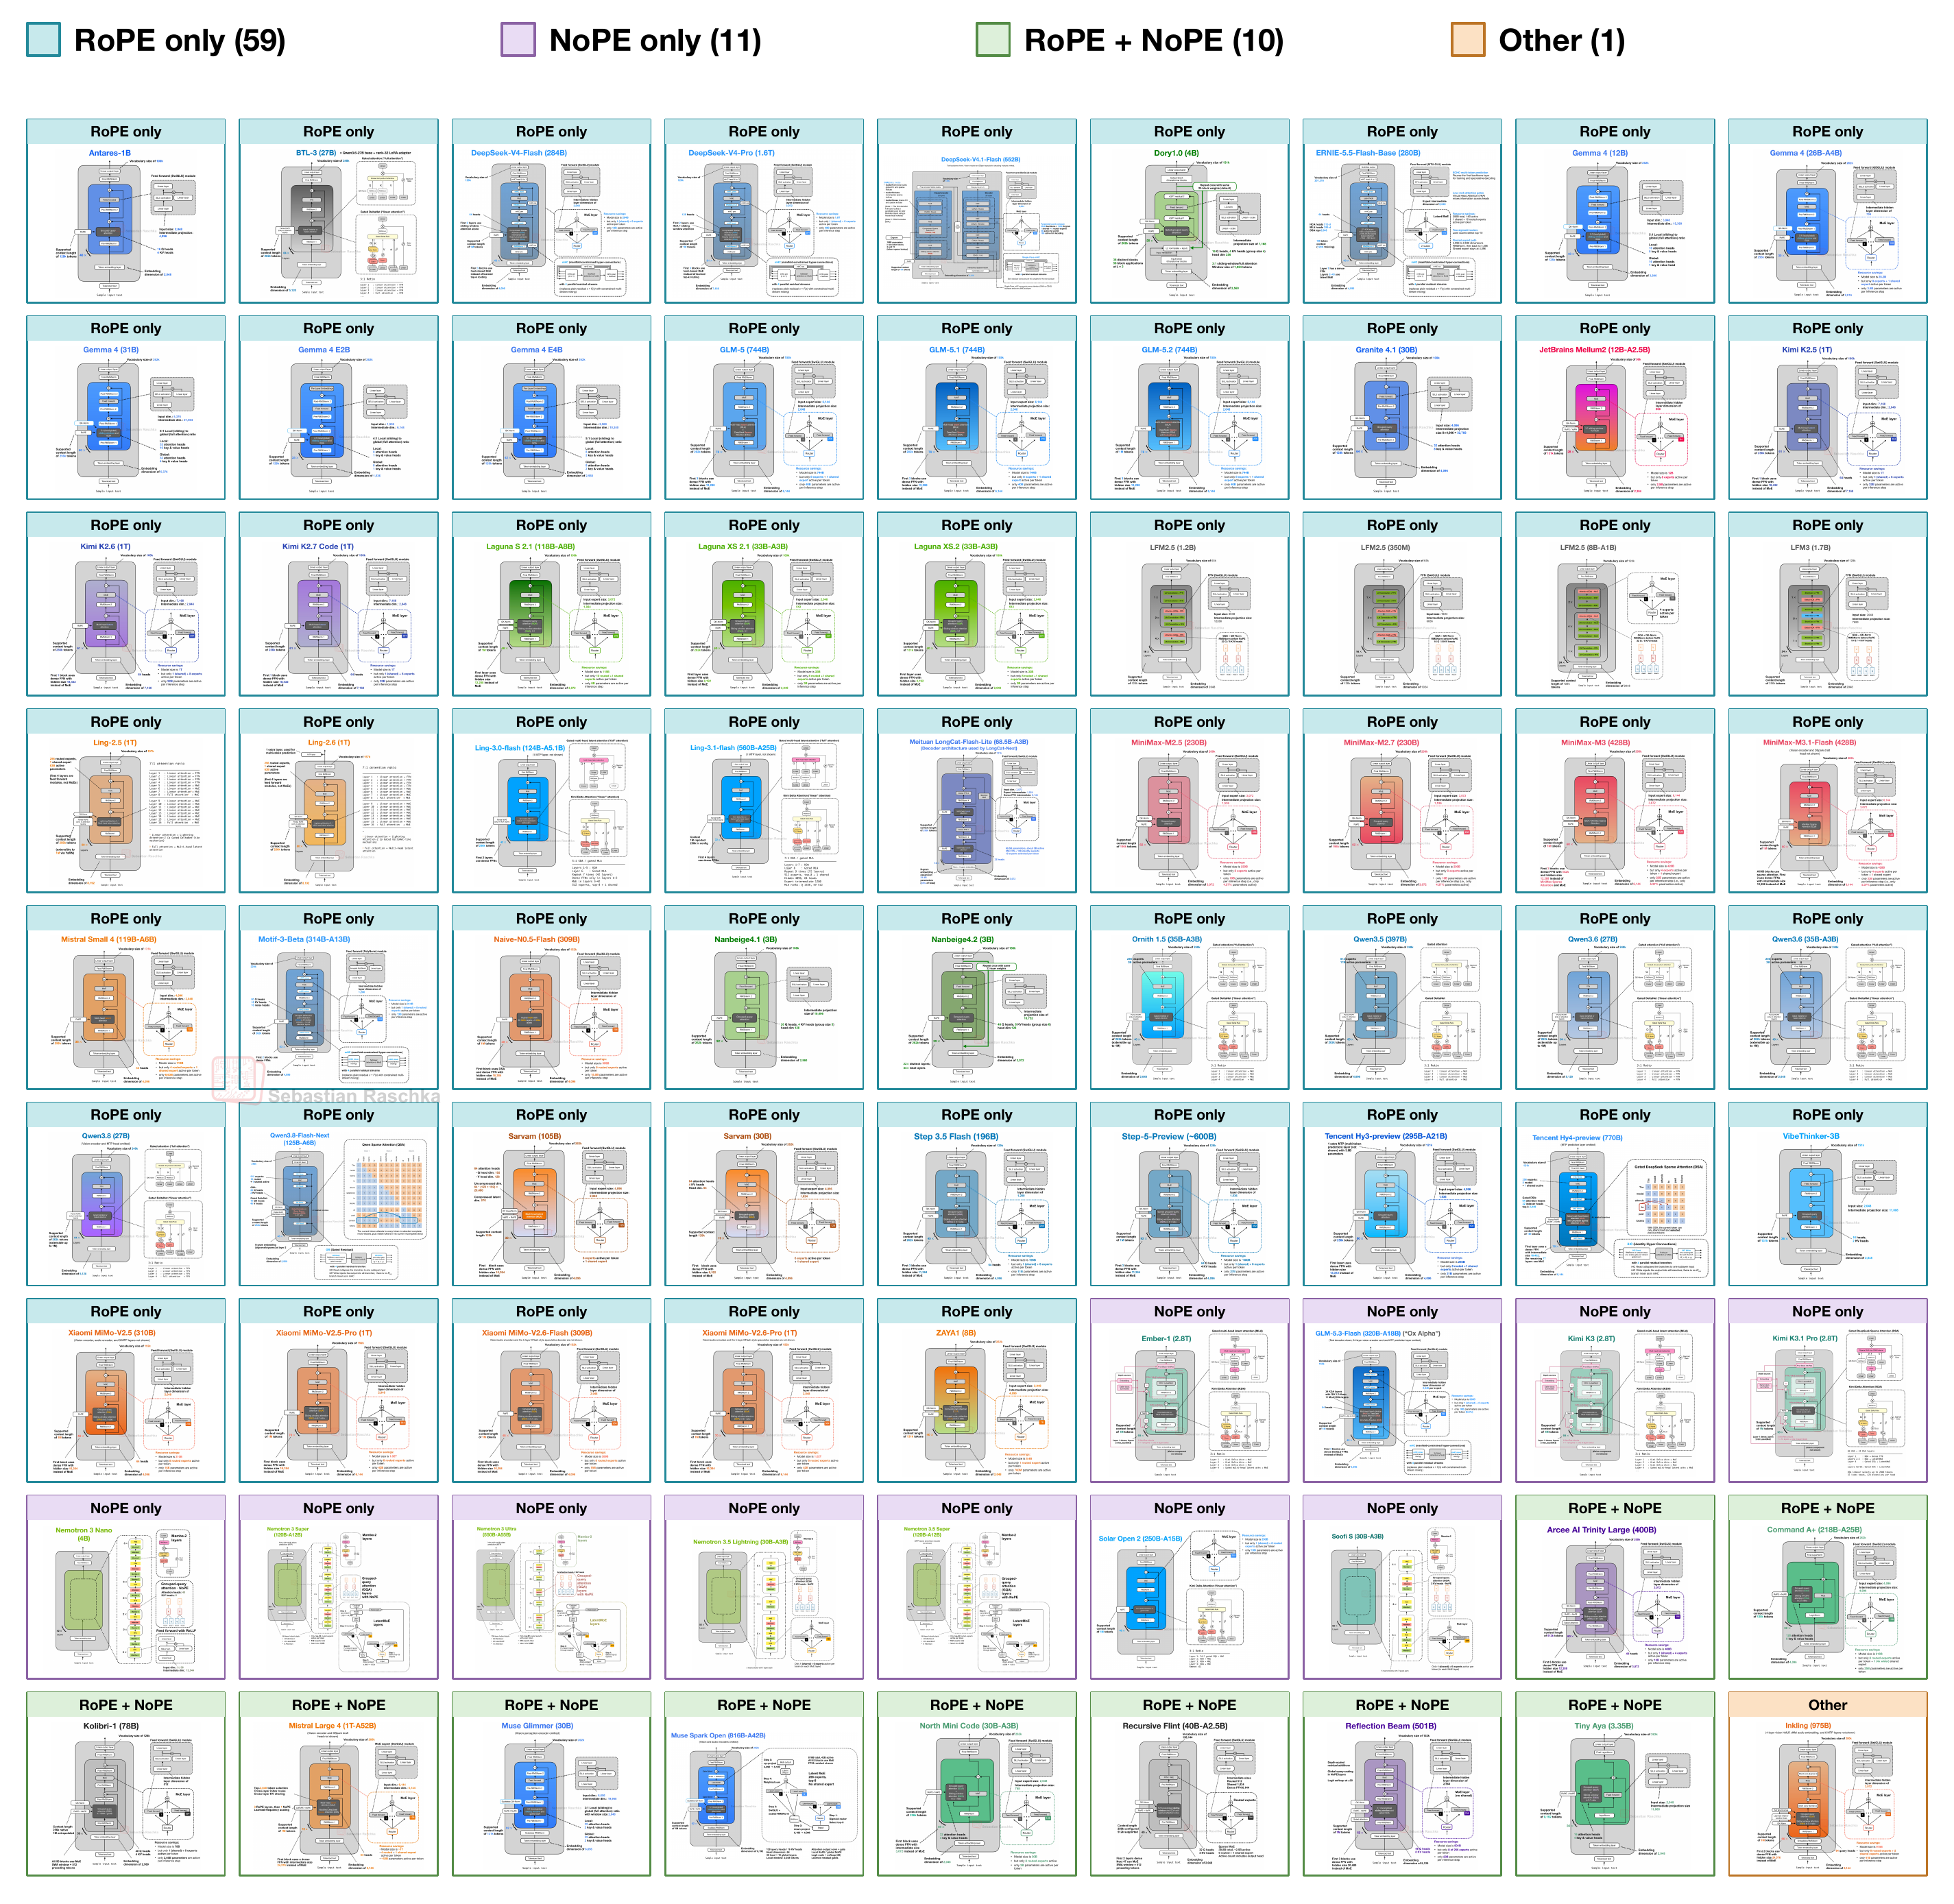
下图预览了 2026 年各类开源权重模型所采用的位置嵌入方案。等讲完底层机制后,我们再详细讨论这些架构选型。
不过,为什么要花这么多时间来写/读这个看似不起眼的积木块?大语言模型一直在演进,今年我在筹备一篇关于最新 LLM 架构趋势的文章时,意识到自己之前从未系统写过 LLM 中的位置信息编码方法。与其让那篇趋势分析篇幅过长、枝蔓丛生,不如把位置编码单独拎出来写一篇基础构件解析,为接下来的架构趋势分析铺路。
此外,这些年来很多读者一直希望我继 GPT 使用的可学习绝对位置嵌入之后,再写一篇关于相对位置嵌入(即 RoPE)的教程。这个选题在我的待办清单里躺了很久,这次我终于翻出旧草稿整理成了这篇详解,内容涵盖:
LLM 中使用的各类位置编码方法;
(千呼万唤始出来的)RoPE 运作原理;
近期开源 LLM 采用的具体方案。
需要说明的是,本文默认读者对基础 LLM 架构有一定了解,非常适合作为《从零构建大语言模型》(Build a Large Language Model (From Scratch))的进阶阅读。如果你对注意力机制的内部概念与计算过程(尤其是 Query、Key、Value 向量)有些生疏,建议先看看我的这篇 自注意力机制详解 温习一下:
本文技术性很强,对部分读者来说细节可能有些偏多。但我确实希望把这块基石彻底讲透,方便后续文章直接引用。不用担心,下一篇会回归更轻松易读的风格。
附注:我最近开始试用 Substack 新推出的“福利”(perks)系统。为了感谢大家的支持,我提供了架构图集的 高清图片导出与元数据,方便你在自己的分析中使用。
又及:如果你已经很清楚位置嵌入的原理,可以直接跳到第 6 节:现代架构中的位置编码选型。
另外提醒一下,本文在网页浏览器中的阅读体验会优于邮件客户端。建议通过这里的 网页版阅读,左侧还配有导航栏。
1. 位置信息在 LLM 中的切入点
我们先从整体架构切入。分词器(tokenizer)首先将输入文本编码为 token ID;接着,LLM 的输入词嵌入层将每个 ID 映射为一个数值向量,这些向量中的每个数值通常被称为“特征”(与传统机器学习类似)。随后,LLM 内部的 Transformer 块利用注意力和前馈层对这些向量进行变换;最后,模型的输出层生成下一个 token 的对数几率(logits,随后转换为概率)。
下图展示了这一路径在 GPT-2(相对经典的 LLM)与 MiniMax-M3(今年发布的较新 LLM,可代表近期绝大多数主流 LLM)中的实现方式。可以看到,两者的架构差异并不大。在深入探讨位置信息之前,我们先重点关注橙色区块(Token 嵌入层)以及其上方的 Transformer 模块;其他架构差异对本文的解释并不重要。
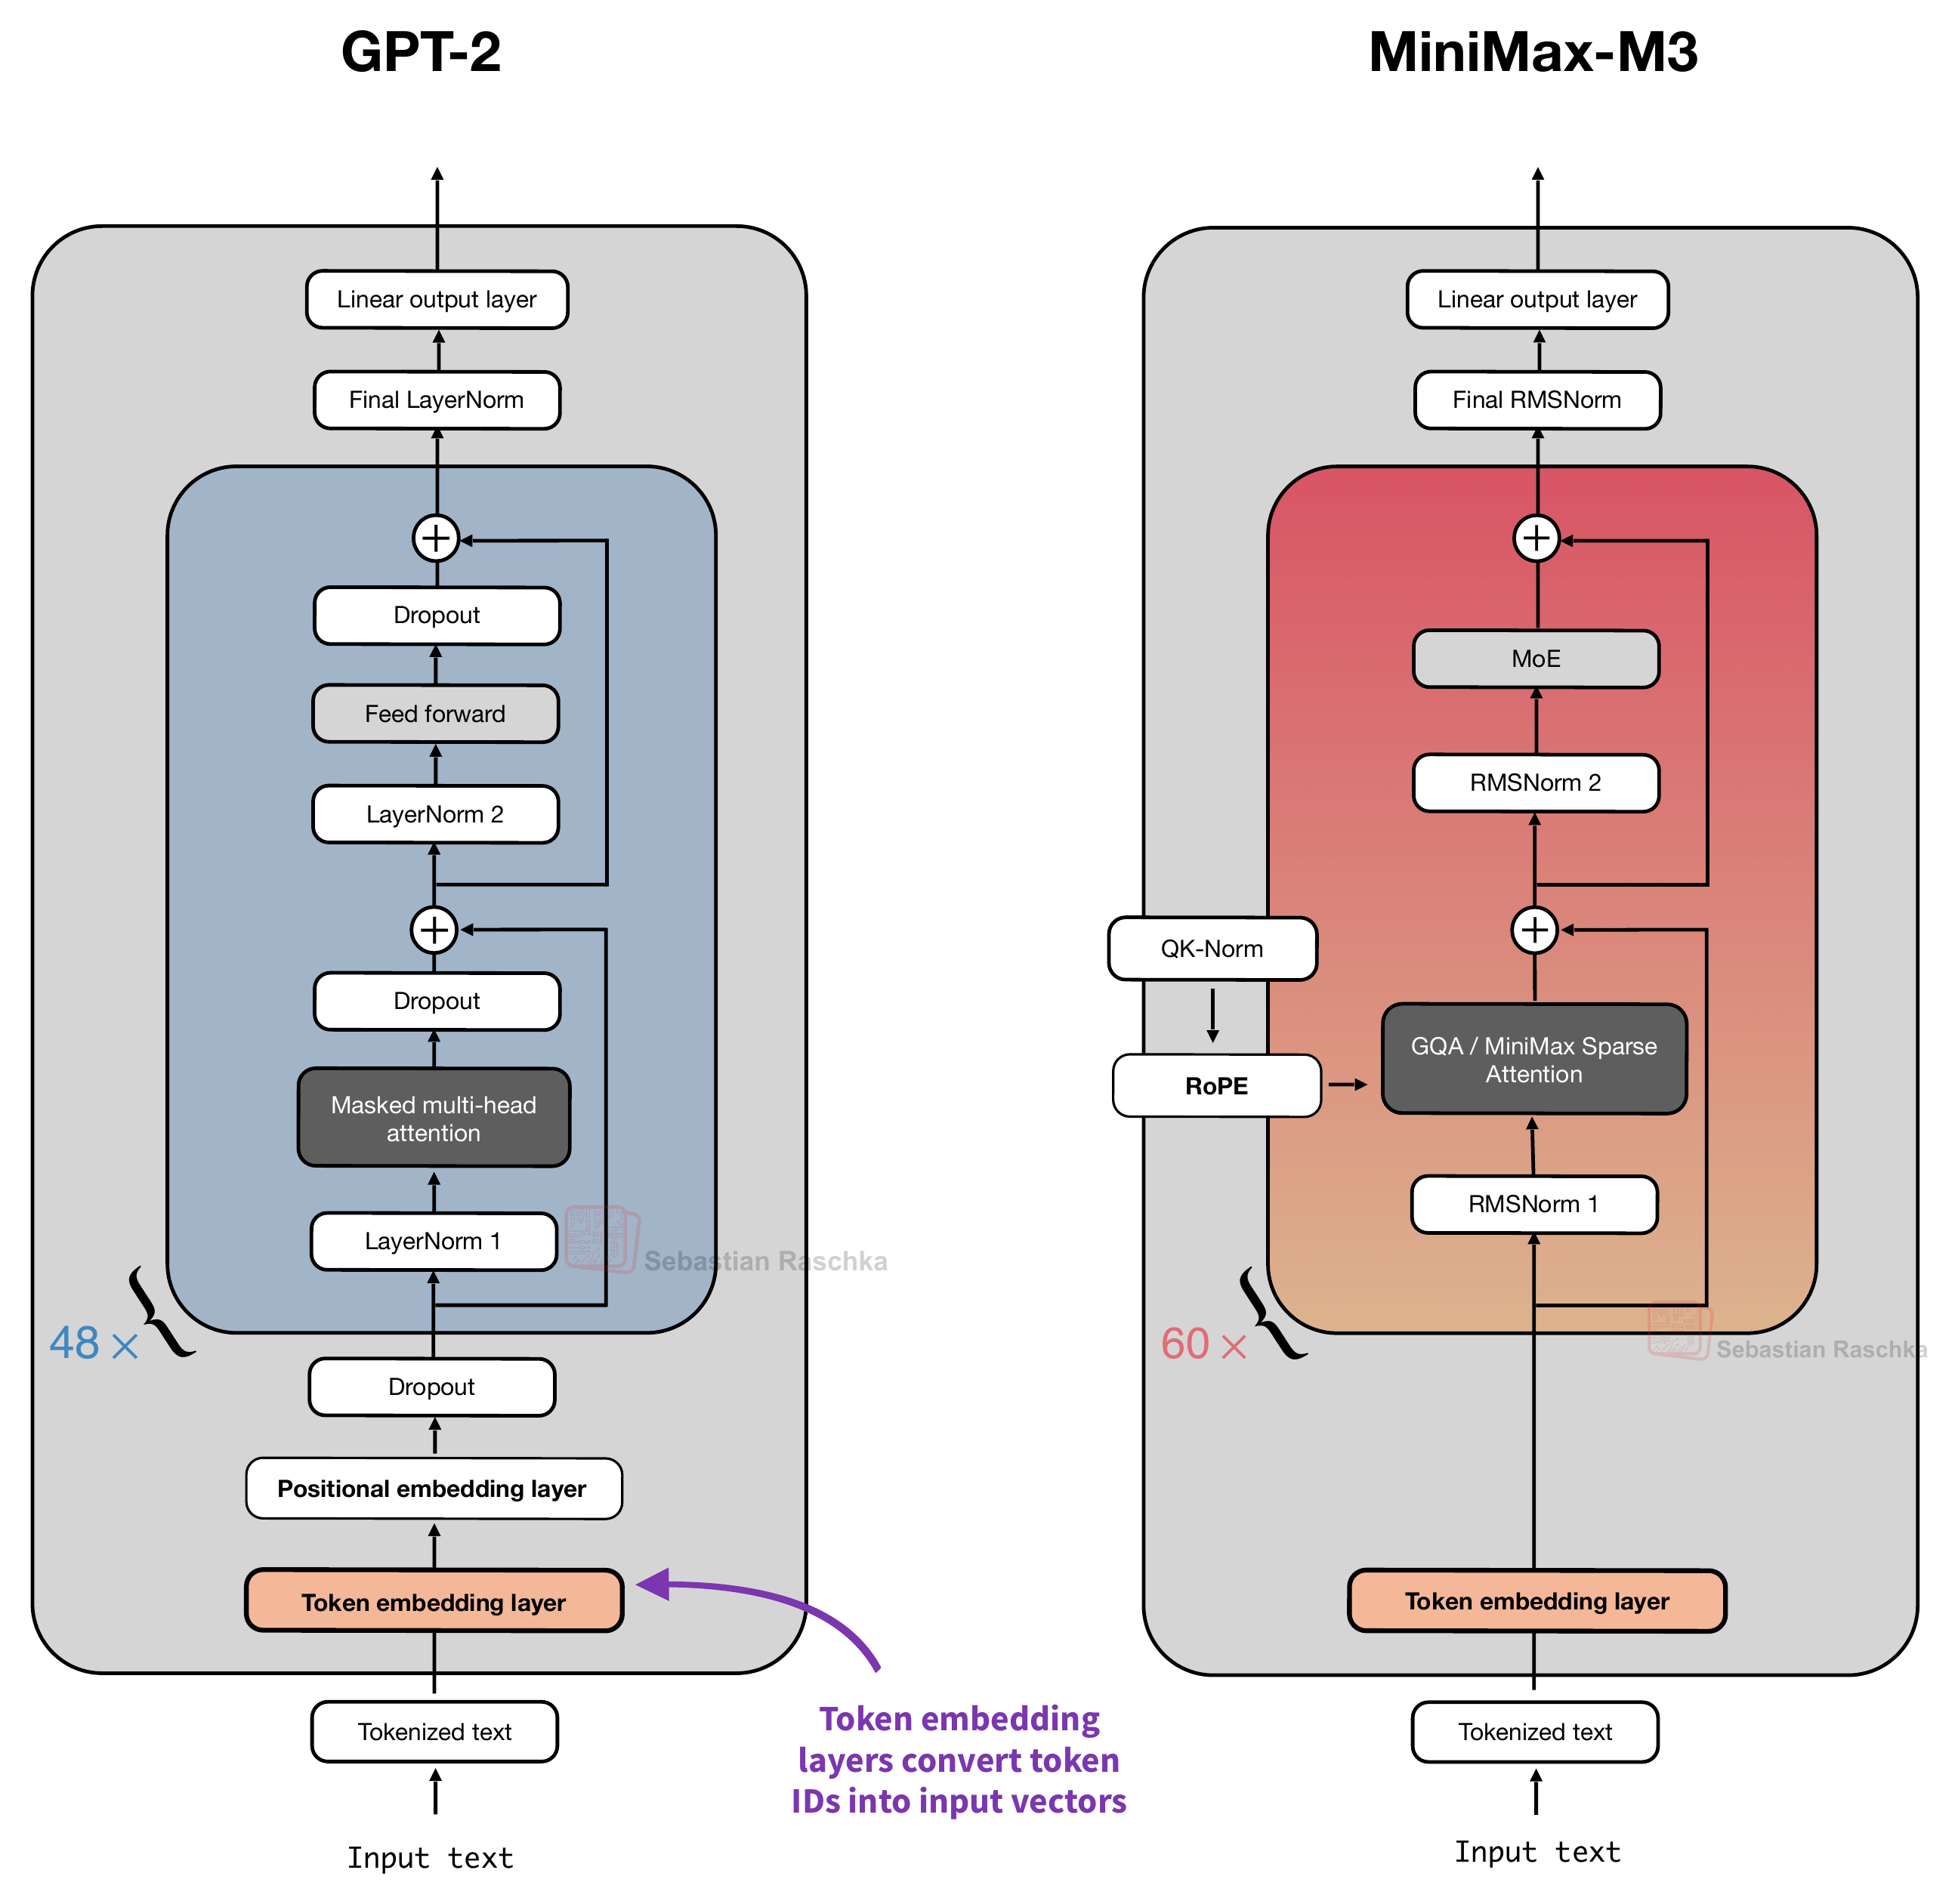
如上图所示,Token 嵌入层负责将每个 Token ID 映射为一个向量,随后再加入位置信息。具体而言(后文还会详细探讨),GPT-2 会在修改后的词嵌入进入第一个 Transformer 模块之前,给每个 Token 嵌入加上一个位置向量;而 MiniMax-M3 则是在每个 Transformer 模块的注意力机制内部,通过 RoPE 方法注入位置信息。
稍后我们会更深入地探讨这些方法,但首先,我们先退一步看看全局背景:为什么需要(或必须加入)显式的位置信息?
1.1 为什么要加入位置信息?
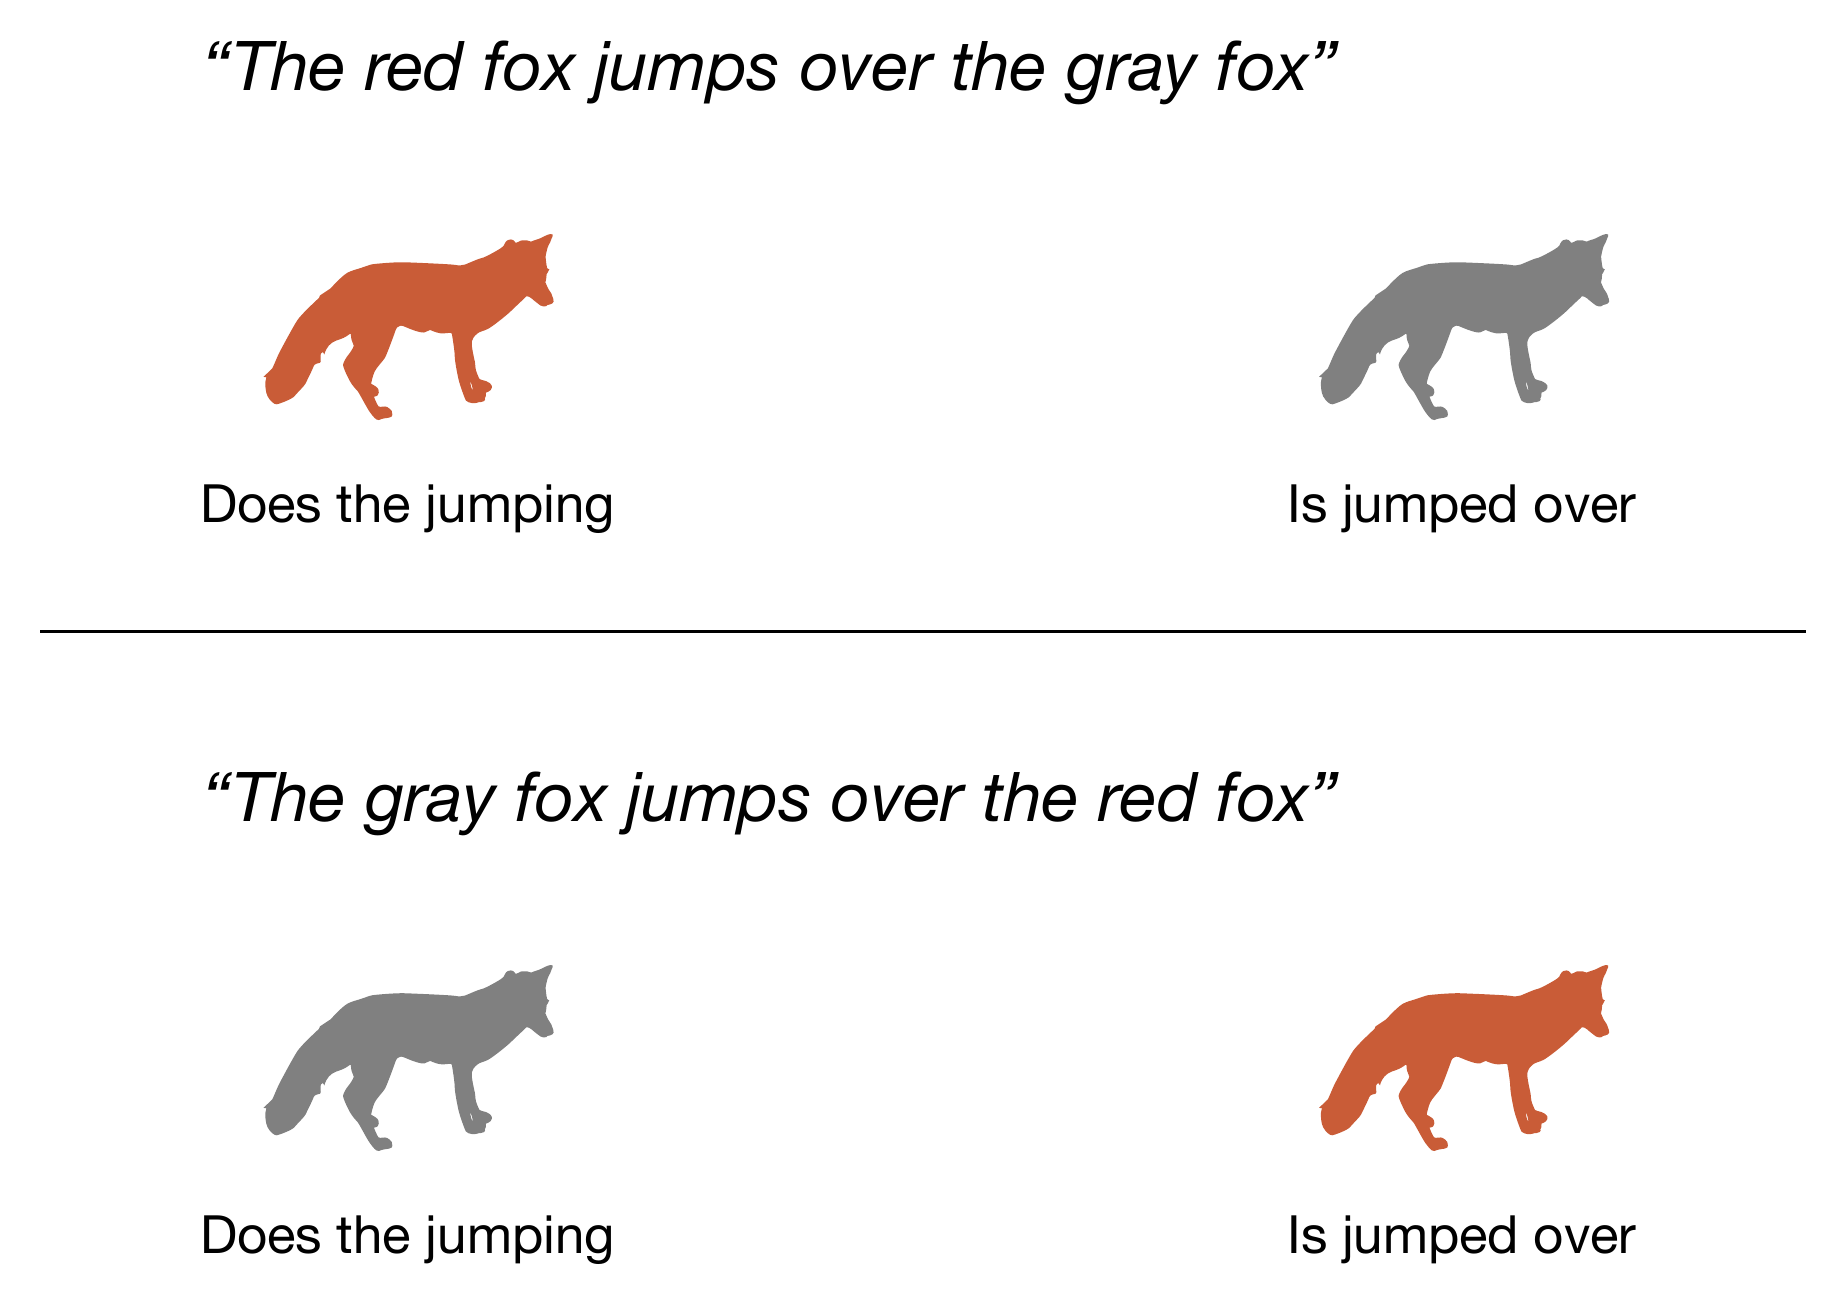
来看一个简单的示例,假设有以下两个输入句子:
“The red fox jumps over the gray fox.”
“The gray fox jumps over the red fox.”
如下图所示,调换语序会直接改变到底是哪只狐狸在跳跃。
为简化讨论,本文示例中默认一个单词对应一个 Token。(当然大家知道,实际分词器往往会将单词拆分成更小的子词 Token。)这样一来,第一个句子就包含从 0 到 7 共 8 个 Token 位置。

# Assume the following small vocabulary.
# Real vocabularies typically have 50k to 200k entries
vocab = {
    "The": 0,
    "red": 1,
    "fox": 2,
    "jumps": 3,
    "gray": 4,
    "over": 5,
    "the": 6,
}
(如果你对词表的构建方式感兴趣,可以参考我在 GitHub 上的分词器学习资料。)
需要注意的是,“fox”在输入句子中出现了两次,两次分配到的 Token ID 都是 2。由于两者的 Token ID 完全一致,无论它们在句子中的具体位置为何,嵌入层输出给它们的向量都是完全相同的。
现在,我们来看一个不带位置编码(也没有因果掩码)的标准自注意力机制。在这种情况下,输入的每个 Token 都可以关注序列中的任意其他 Token。此时若调换“red”和“gray”等任意两个词的位置,两两 Token 之间的嵌入表示和注意力分数都不会发生任何改变。
GPT 类模型采用了因果(自回归)掩码,限制每个 Token 只能关注自身及排在前面的 Token。有趣的是,这种因果掩码在计算过程中带来了一定的隐式顺序信息。在我们的例子中,“jumps”在第一句中可以关注到“red”,在第二句中关注到的则是“gray”。因此从理论上讲,因果 LLM 哪怕没有显式的位置嵌入,也已经能够区分这两个句子了。(后文探讨“NoPE”概念时我们还会回到这一点。)
尽管如此,GPT-2 和大多数较新的 LLM 依然会引入显式位置信息,以便直接向注意力机制提供明确的位置信号。这是因为因果掩码虽然限定了 Token 的可见范围并提供了隐式的先后顺序,却无法区分两个 Token 到底相隔 1 个位置还是相距 10 个位置。因此,能够补充这一信息的显式位置方法依然非常实用,甚至不可或缺。
如果上面这些内容听起来让人有点摸不着头脑,别担心,这里只是先做个总体概述。在接下来的文章中,我们会放慢节奏,逐步拆解这些概念。
2. 为每个 Token 嵌入添加位置向量
前面我们简单提到了通过因果注意力掩码实现的隐式位置信息(后面我们还会更详细地回顾这点)。不过现在我们换个方向,来聊聊注入位置信息的显式方法。
这类方法中最简单、最直接(但也并非最“划算”)的,或许就是为序列中的每个位置分配一个独立的向量。将该向量与 Token 嵌入相加后,得到的合成嵌入向量会被传给第一个 Transformer 块。接下来的小节将详细讨论这一具体过程。
2.1 GPT-2 中的可学习绝对位置嵌入
为了具体说明如何在输入嵌入中加入显式、可学习的位置向量,我们以 GPT-2 为例。GPT-2 在训练过程中会学习一张位置向量表。下图展示了这些向量在模型架构中的具体应用位置:紧跟在 Token 嵌入查表之后、第一个 Transformer 块之前。
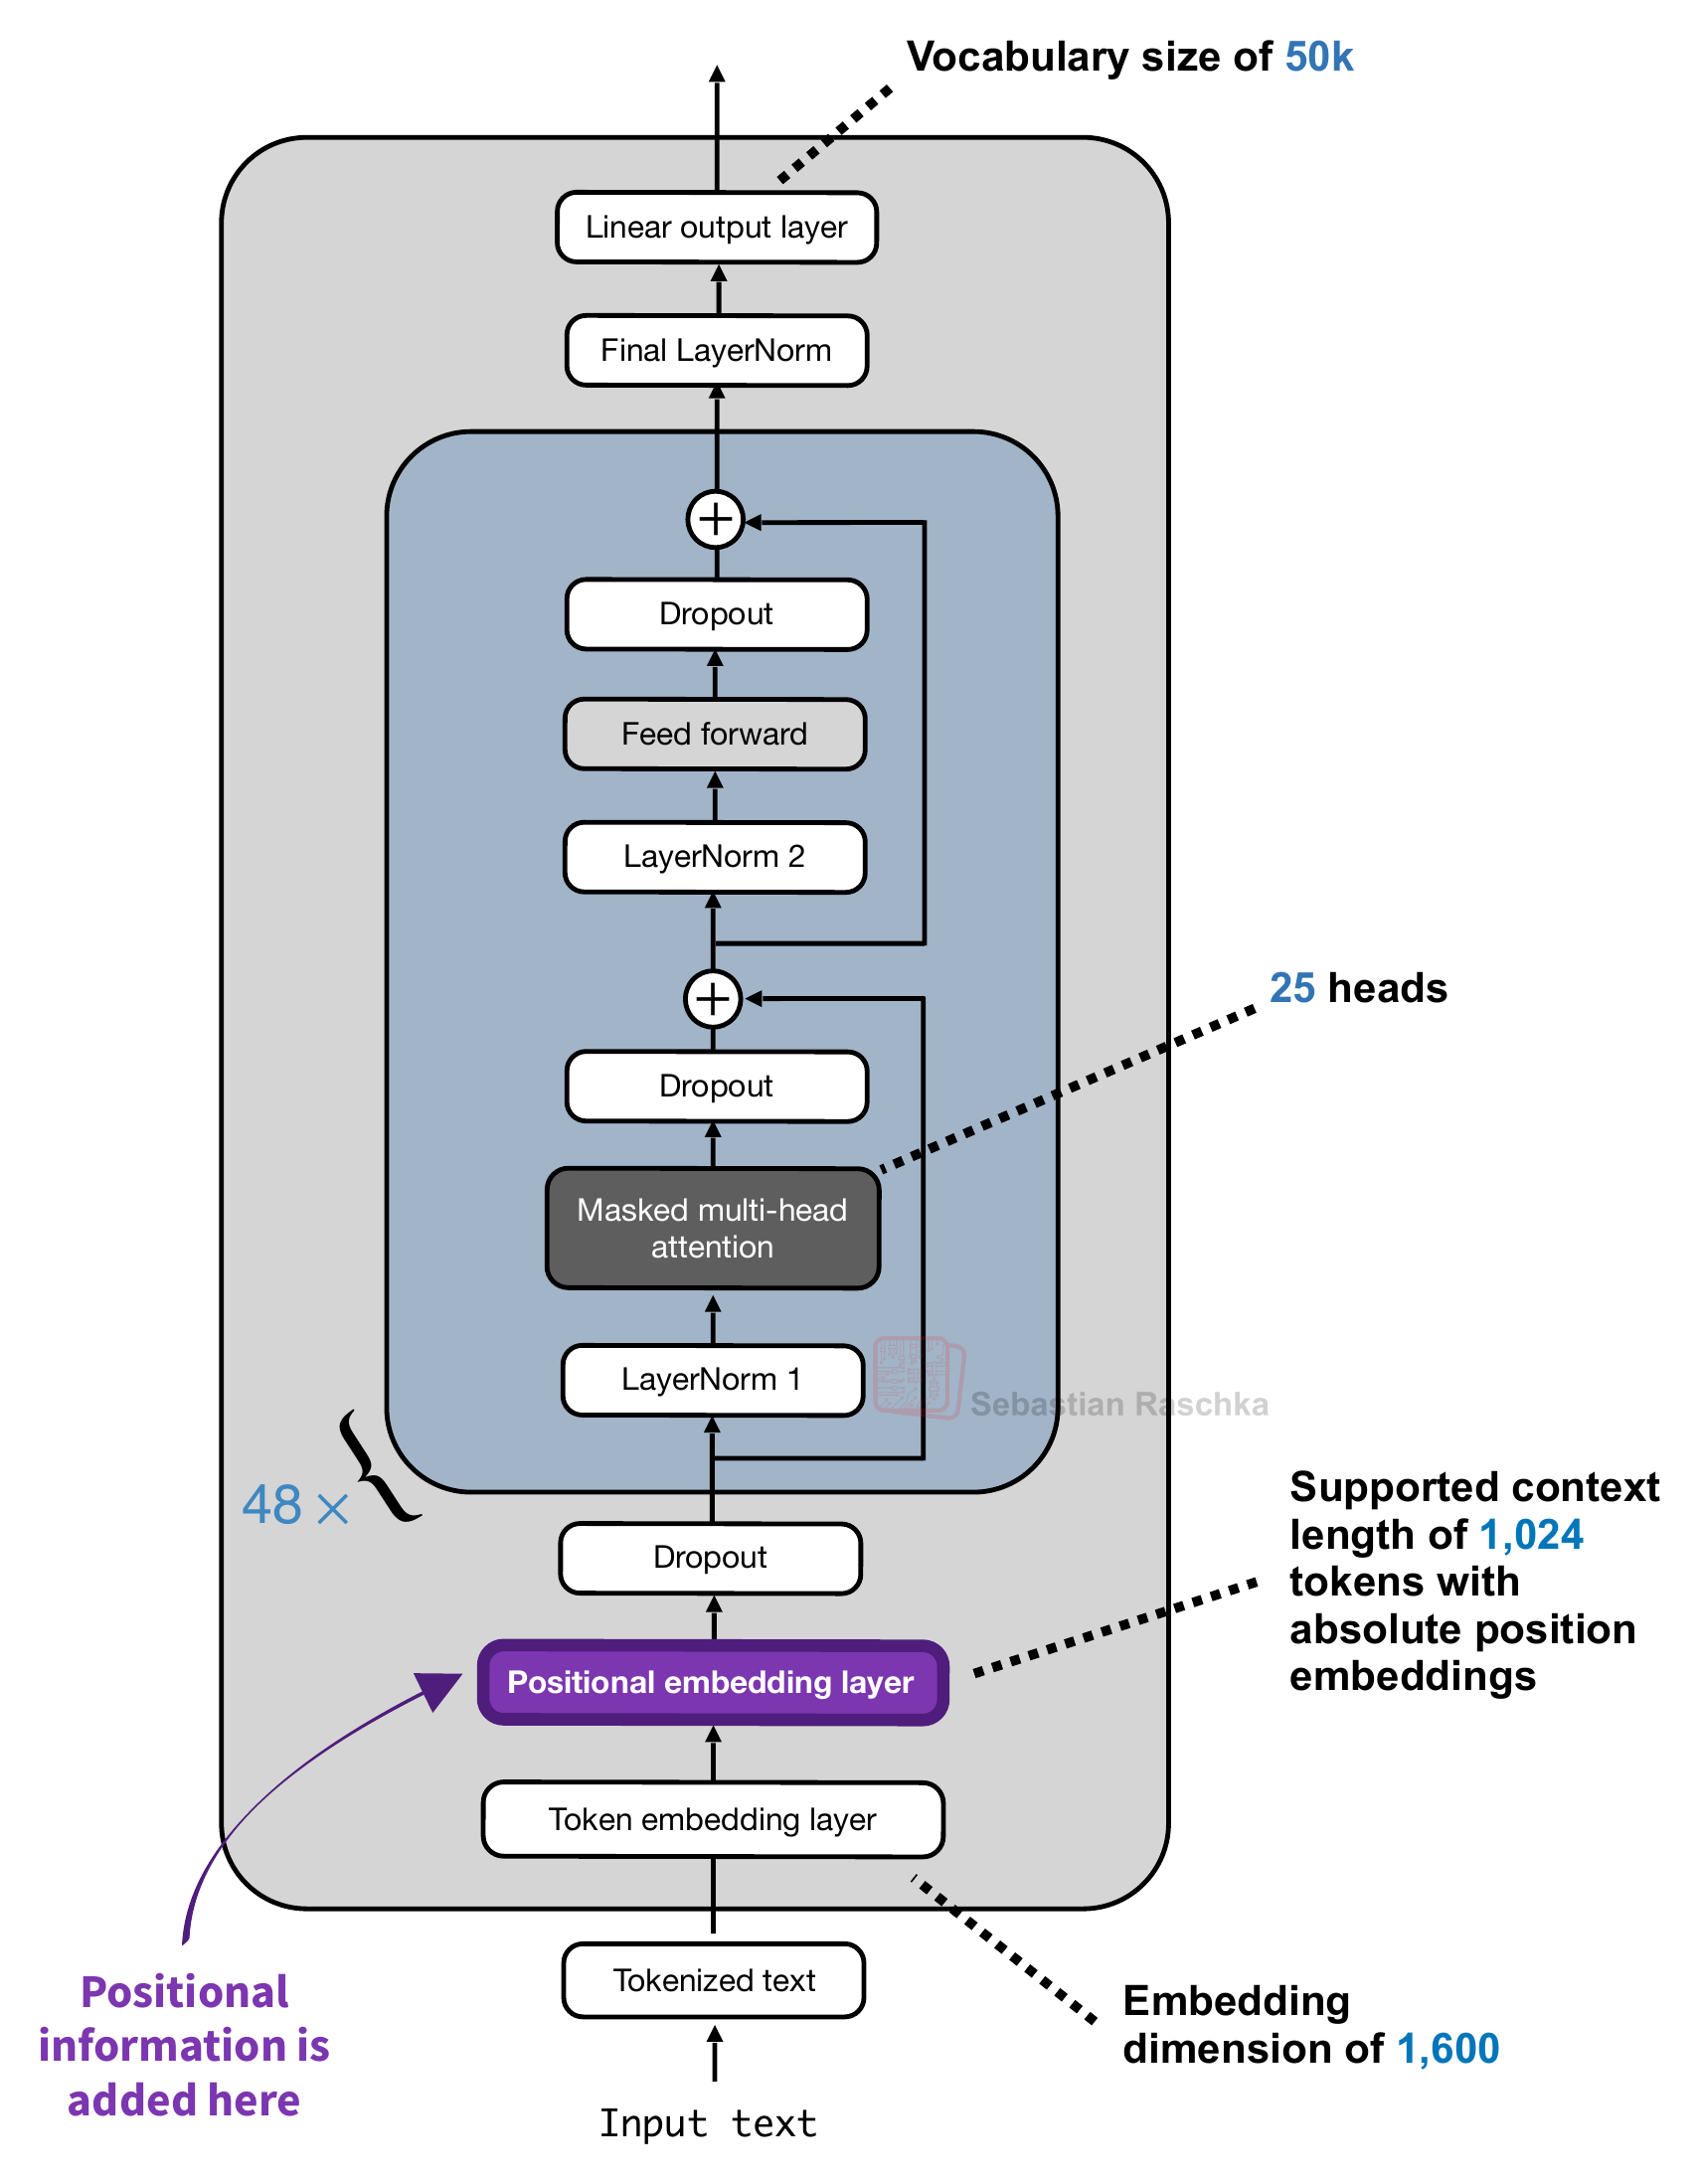
上图中的位置嵌入层在实现上与 Token 嵌入层完全一致,即两者的输出维度完全相同,这样得到的输入向量才能直接相加。以下 GPT-2 代码片段展示了这一过程:
class GPTModel(nn.Module):
    def __init__(self, cfg):
        super().__init__()
        self.tok_emb = nn.Embedding(cfg["vocab_size"], cfg["emb_dim"])
        self.pos_emb = nn.Embedding(cfg["context_length"], cfg["emb_dim"])
        self.drop_emb = nn.Dropout(cfg["drop_rate"])

        self.trf_blocks = nn.Sequential(
            *[TransformerBlock(cfg) for _ in range(cfg["n_layers"])])

        self.final_norm = LayerNorm(cfg["emb_dim"])
        self.out_head = nn.Linear(
            cfg["emb_dim"], cfg["vocab_size"], bias=False
        )

    def forward(self, in_idx):
        batch_size, seq_len = in_idx.shape
        tok_embeds = self.tok_emb(in_idx)
        pos_embeds = self.pos_emb(torch.arange(seq_len, device=in_idx.device))
        x = tok_embeds + pos_embeds  # Shape [batch_size, num_tokens, emb_size]
        x = self.drop_emb(x)
        x = self.trf_blocks(x)
        x = self.final_norm(x)
        logits = self.out_head(x)
        return logits
用数学公式可以表示如下。设 m 为位置索引,xm 为该位置上的 Token ID。进入第一个块的输入为:

其中,
Etoken 为嵌入层,
Pm 是由 m 选出的位置信息向量,
hm 则是嵌入向量与位置向量相加后得到的结果。
由于这两个向量维度相同,我们将其逐元素(element-wise)相加。下面的图 6 通过一个简单的具体数值示例直观展示了这一过程。
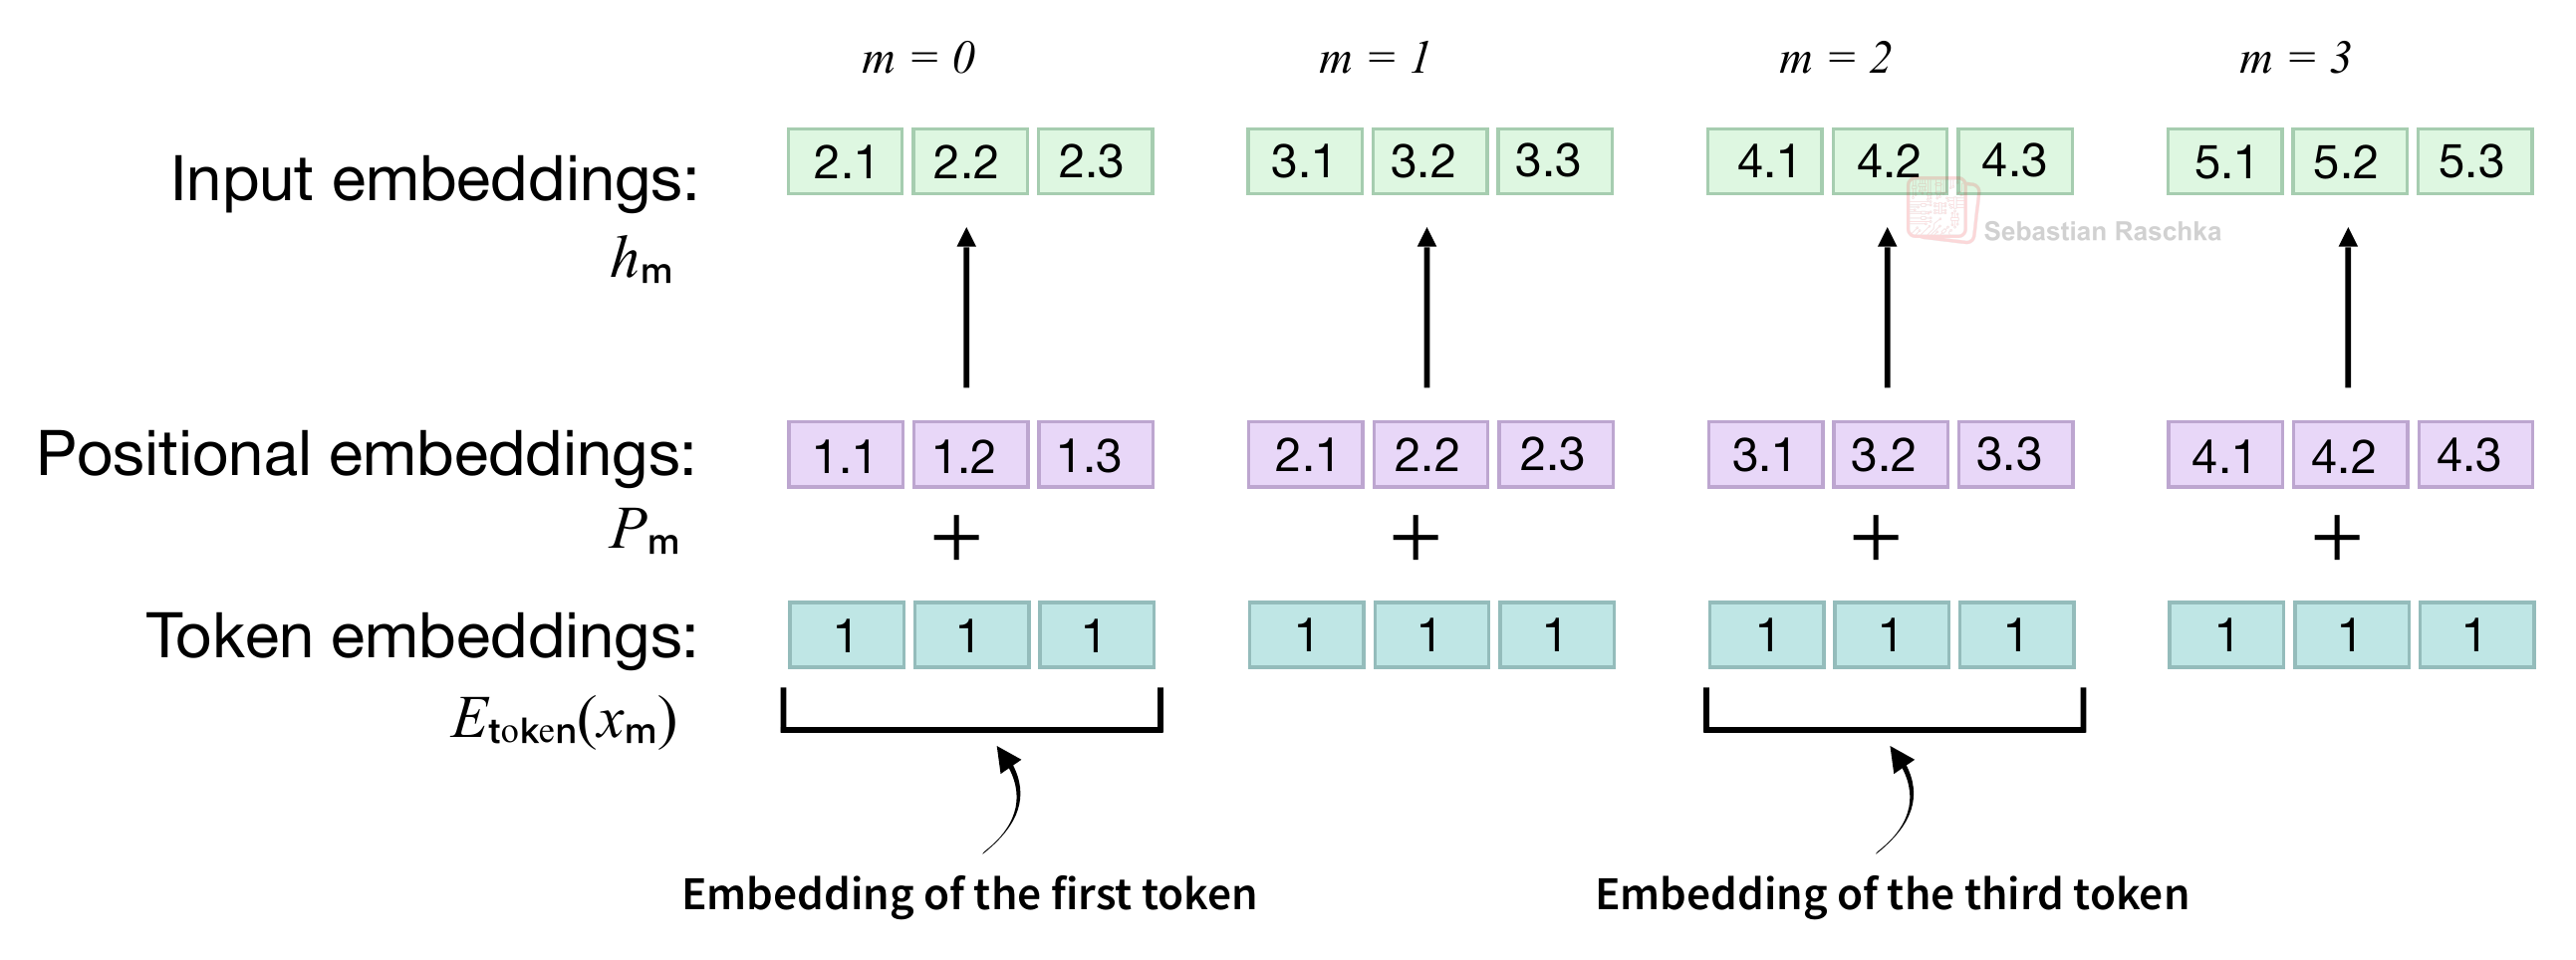
在上图中,位置 0 处的 Token 嵌入 [1, 1, 1] 与位置嵌入 [1.1, 1.2, 1.3] 相加得到 [2.1, 2.2, 2.3]。顺便提一句,图中的数值只是为了演示简便;在实际场景中,两个嵌入层(嵌入表)都会初始化为较小的随机值,并在训练过程中通过学习不断更新。
因此,我们在本节讨论的方法属于所谓的绝对位置编码方法,因为位置嵌入 Pm 仅取决于 Token 自身所处的位置 m。在前面的例句中,两个“fox” Token 起初拥有完全相同的 Token 嵌入,但在分别加上不同的位置向量 P2 和 P7 之后,它们在送入第一个 Transformer 块之前就具备了不同的数值。正因如此,注意力机制内部的 Query、Key 和 Value 向量所接收到的输入表征,就已经包含了位置信息。
需要注意的是,原版 GPT-2 的实现中包含 1024 个可学习的位置向量。这意味着它只能处理不超过 1024 个 token 的输入。如果想要扩展上下文窗口,就必须扩大这张嵌入表。由于嵌入表(层)在训练期间会像其他层一样更新权重,因此上下文长度必须在训练开始前就确定下来。
而扩大上下文的代价非常高,因为这张表会变得极其庞大。以 GPT-2 Medium 为例,在 1024 个位置时,位置嵌入层的权重仅占总权重的 0.30%。但如果将上下文长度扩展到如今常见的 100k 级别,位置嵌入就会占到整个模型权重的 22% 以上,这显然非常不划算。
2.2 原版 Transformer 中的固定正弦位置编码
早于 GPT 问世的 2017 年原版 《Attention Is All You Need》 Transformer 也采用了同样的相加机制,但它是用固定的正弦和余弦函数来计算位置向量的。下面的图 7 展示了在进入编码器和解码器堆叠层之前进行的这种相加操作。其中编码器负责处理输入序列,解码器则生成输出序列。(之所以在这里介绍它,是因为后面讨论 RoPE 时还会用到正余弦函数。)
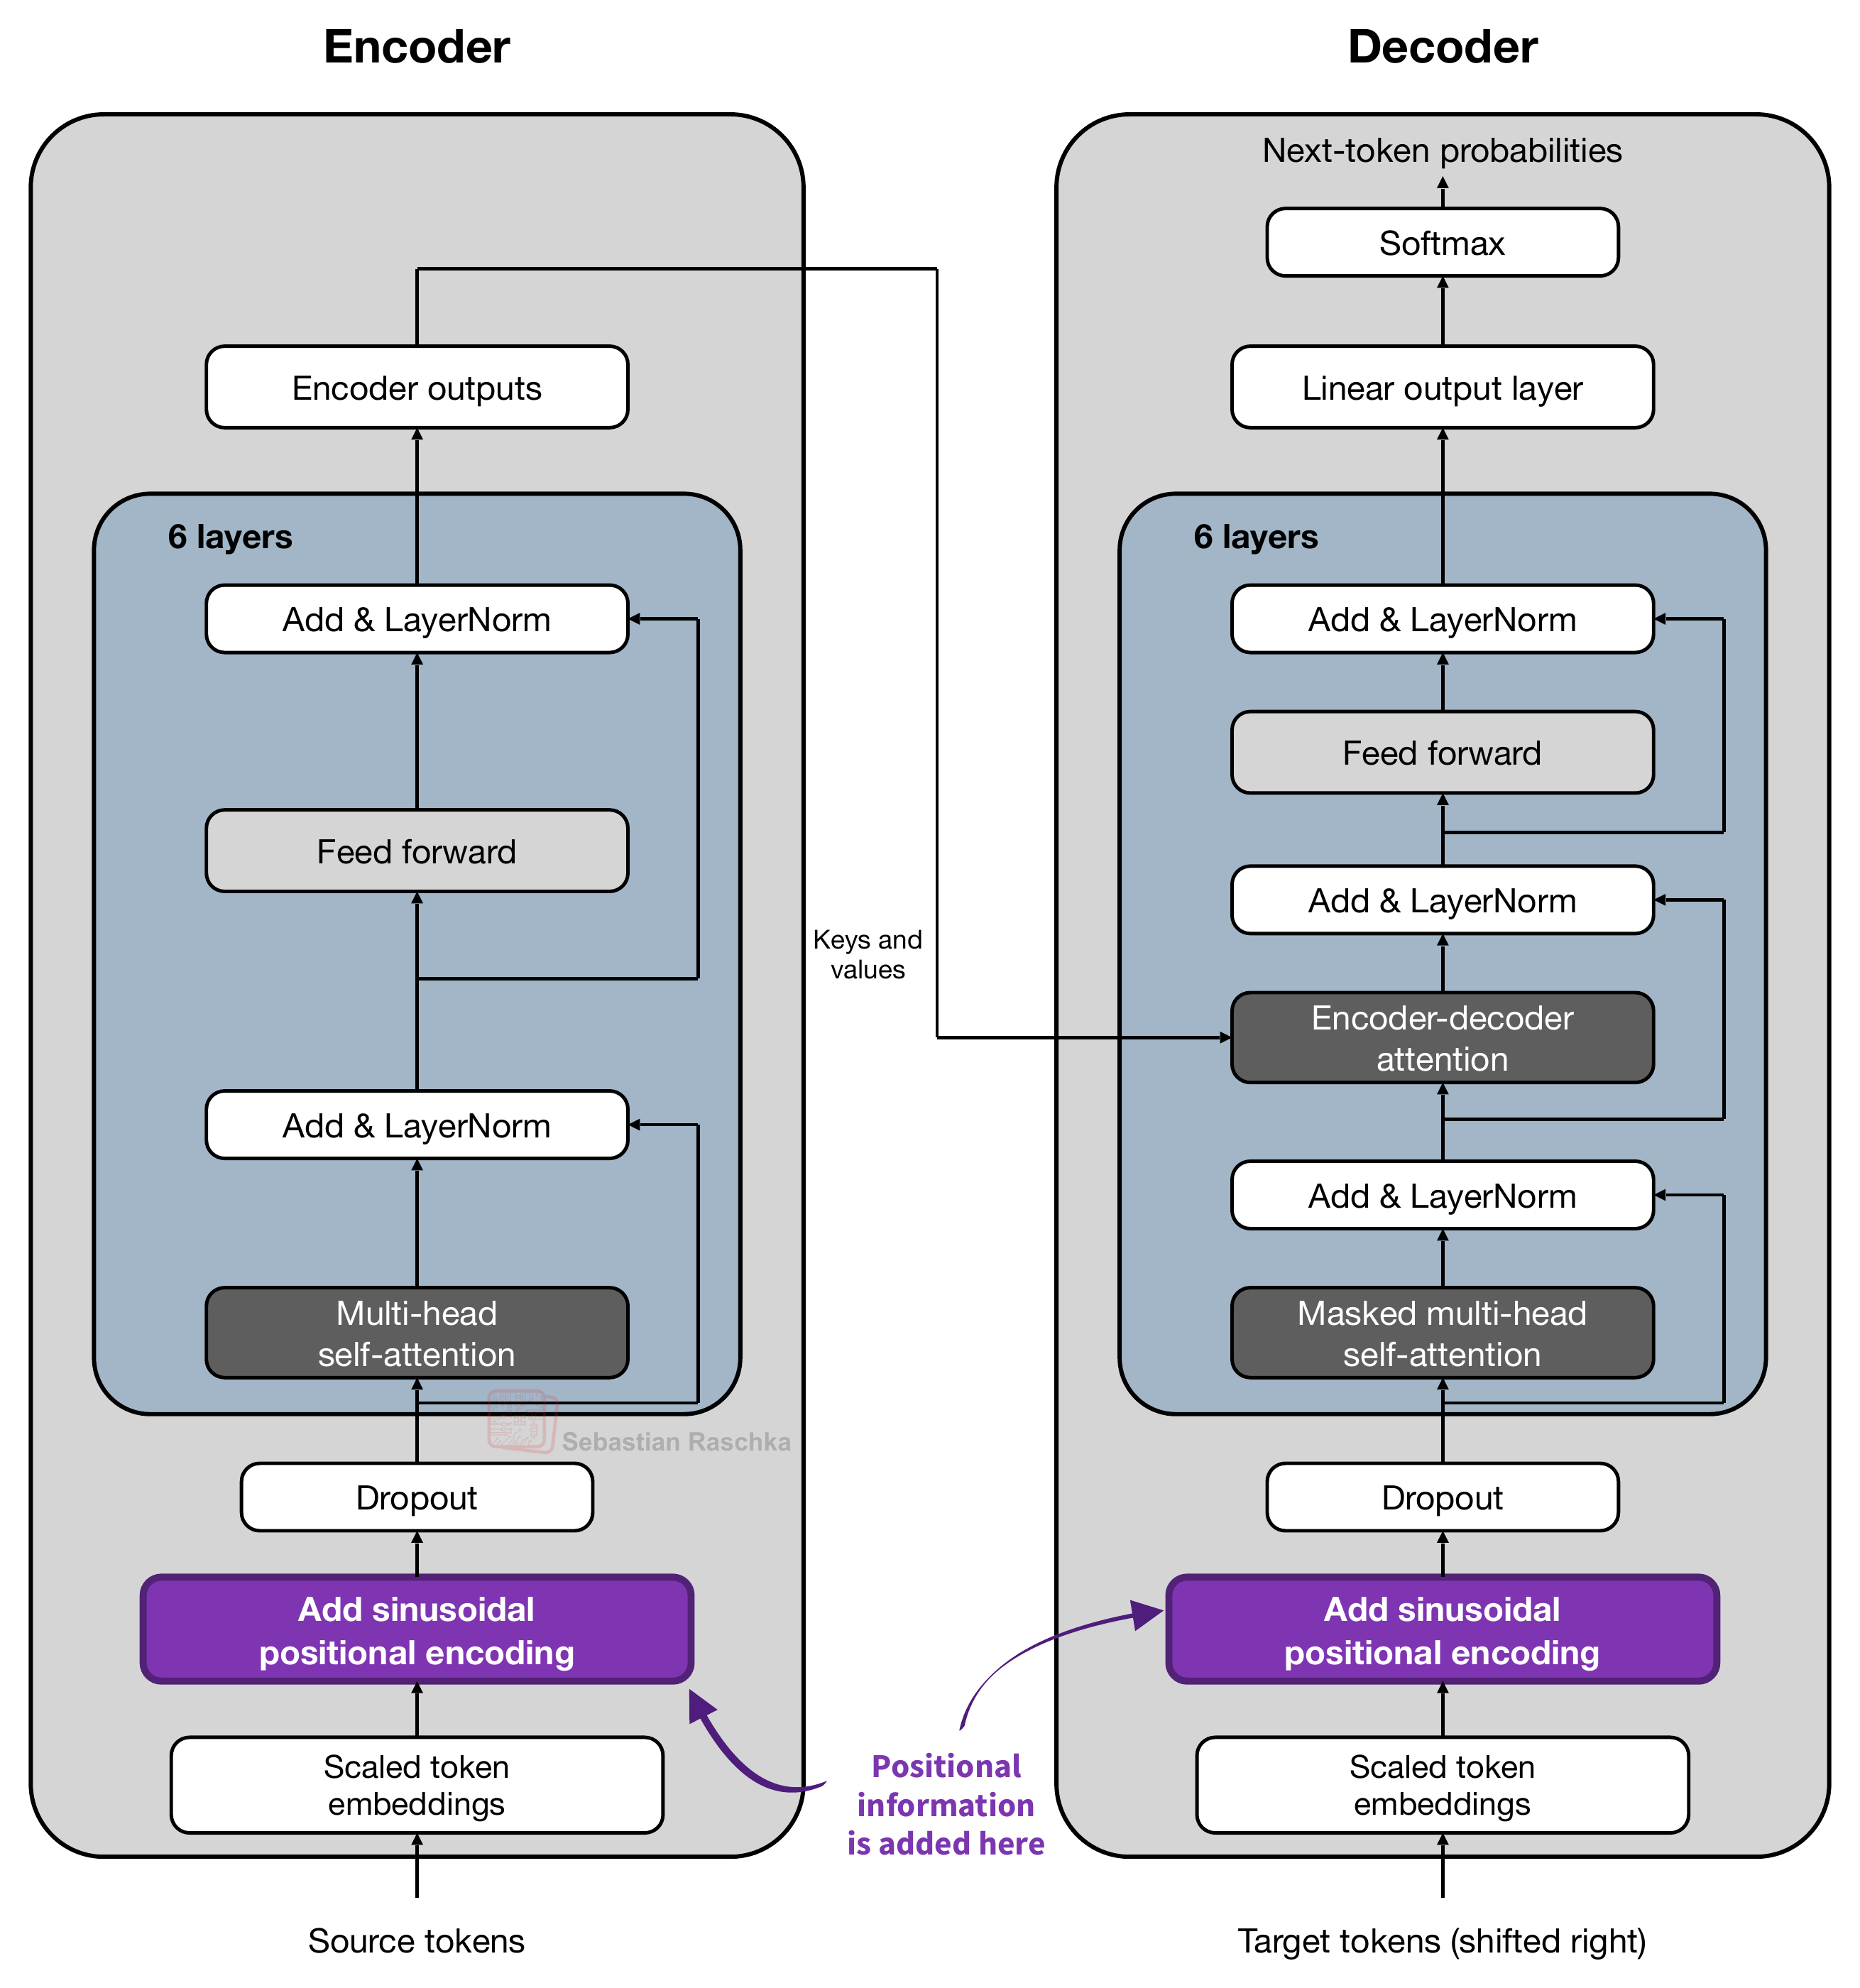
原版 Transformer 在加上位置向量之前,还会将 token 嵌入乘以 √(dmodel) 进行缩放,其中 dmodel 代表嵌入维度。
因此,上一节中 GPT-2 的公式为:
而原版 Transformer(如图 7 所示)所使用的公式则是:

乘以 √(dmodel) 的缩放操作只是一个技术细节。不过对于好奇的读者来说,Transformer 原论文并没有解释引入这一缩放因子的动机;但我多年前在 Twitter 上与同行讨论过,这很可能是为了在初始化时让 token 嵌入和正弦位置编码处于相当的数值尺度,避免相加时位置向量在总和中占据主导地位。
在 GPT-2 中就不需要做这种缩放,因为原版 GPT-2 代码在初始化时,将 token 嵌入的标准差设为 0.02,位置嵌入的标准差设为 0.01,两者在量级上本来就大体相当。
现在,更有意思的部分来了:位置嵌入 Pm 究竟是如何计算的?
具体来说,每个位置向量包含以下各项:

和前面一样,m 表示位置,索引 i 则对应向量中的一对特征。
这里的“特征”指位置向量中的一个数值。举个例子,假设我们有一个包含 8 个数值(dmodel = 8)的小向量,其元素编号为 0 到 7。(原论文中小模型的这一数值是 512,大模型是 1024,而不是 8,但如果用那么大就很难直观展示了。)我们将这 8 个数分成 4 对,这样 i 的取值范围就是 0 到 3。
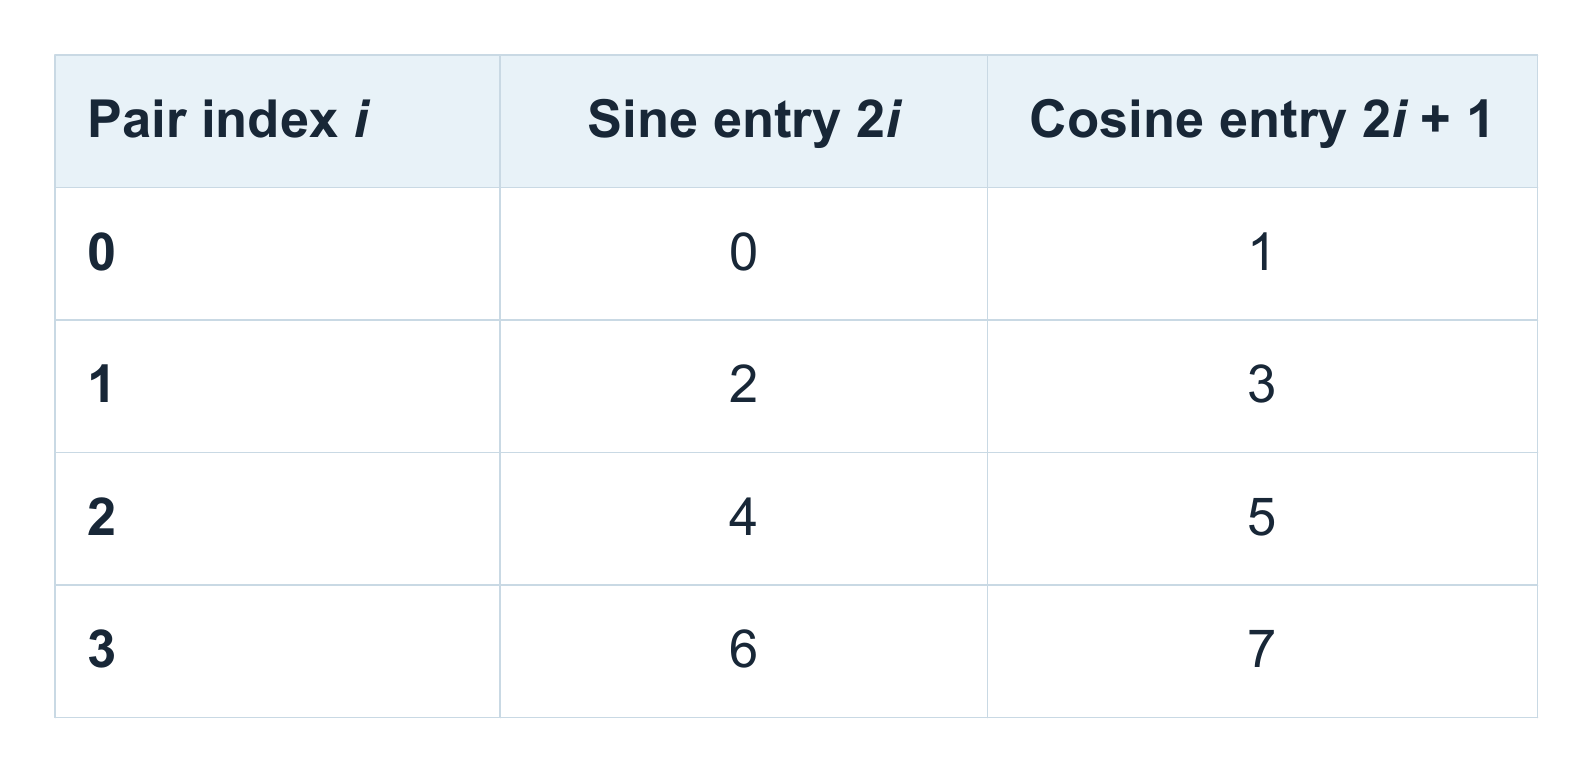
其中,索引 2i 和 2i + 1 分别选出与第 i 对特征对应的两个元素。
如前文公式所示,位置 m 处的角度计算如下;该角度随后分别输入正弦和余弦函数,得出 Pm, 2i 和 Pm, 2i + 1:

图 10 展示了在位置 m = 2 时,我们这个 8 维特征示例中全部 4 对维度的具体计算。
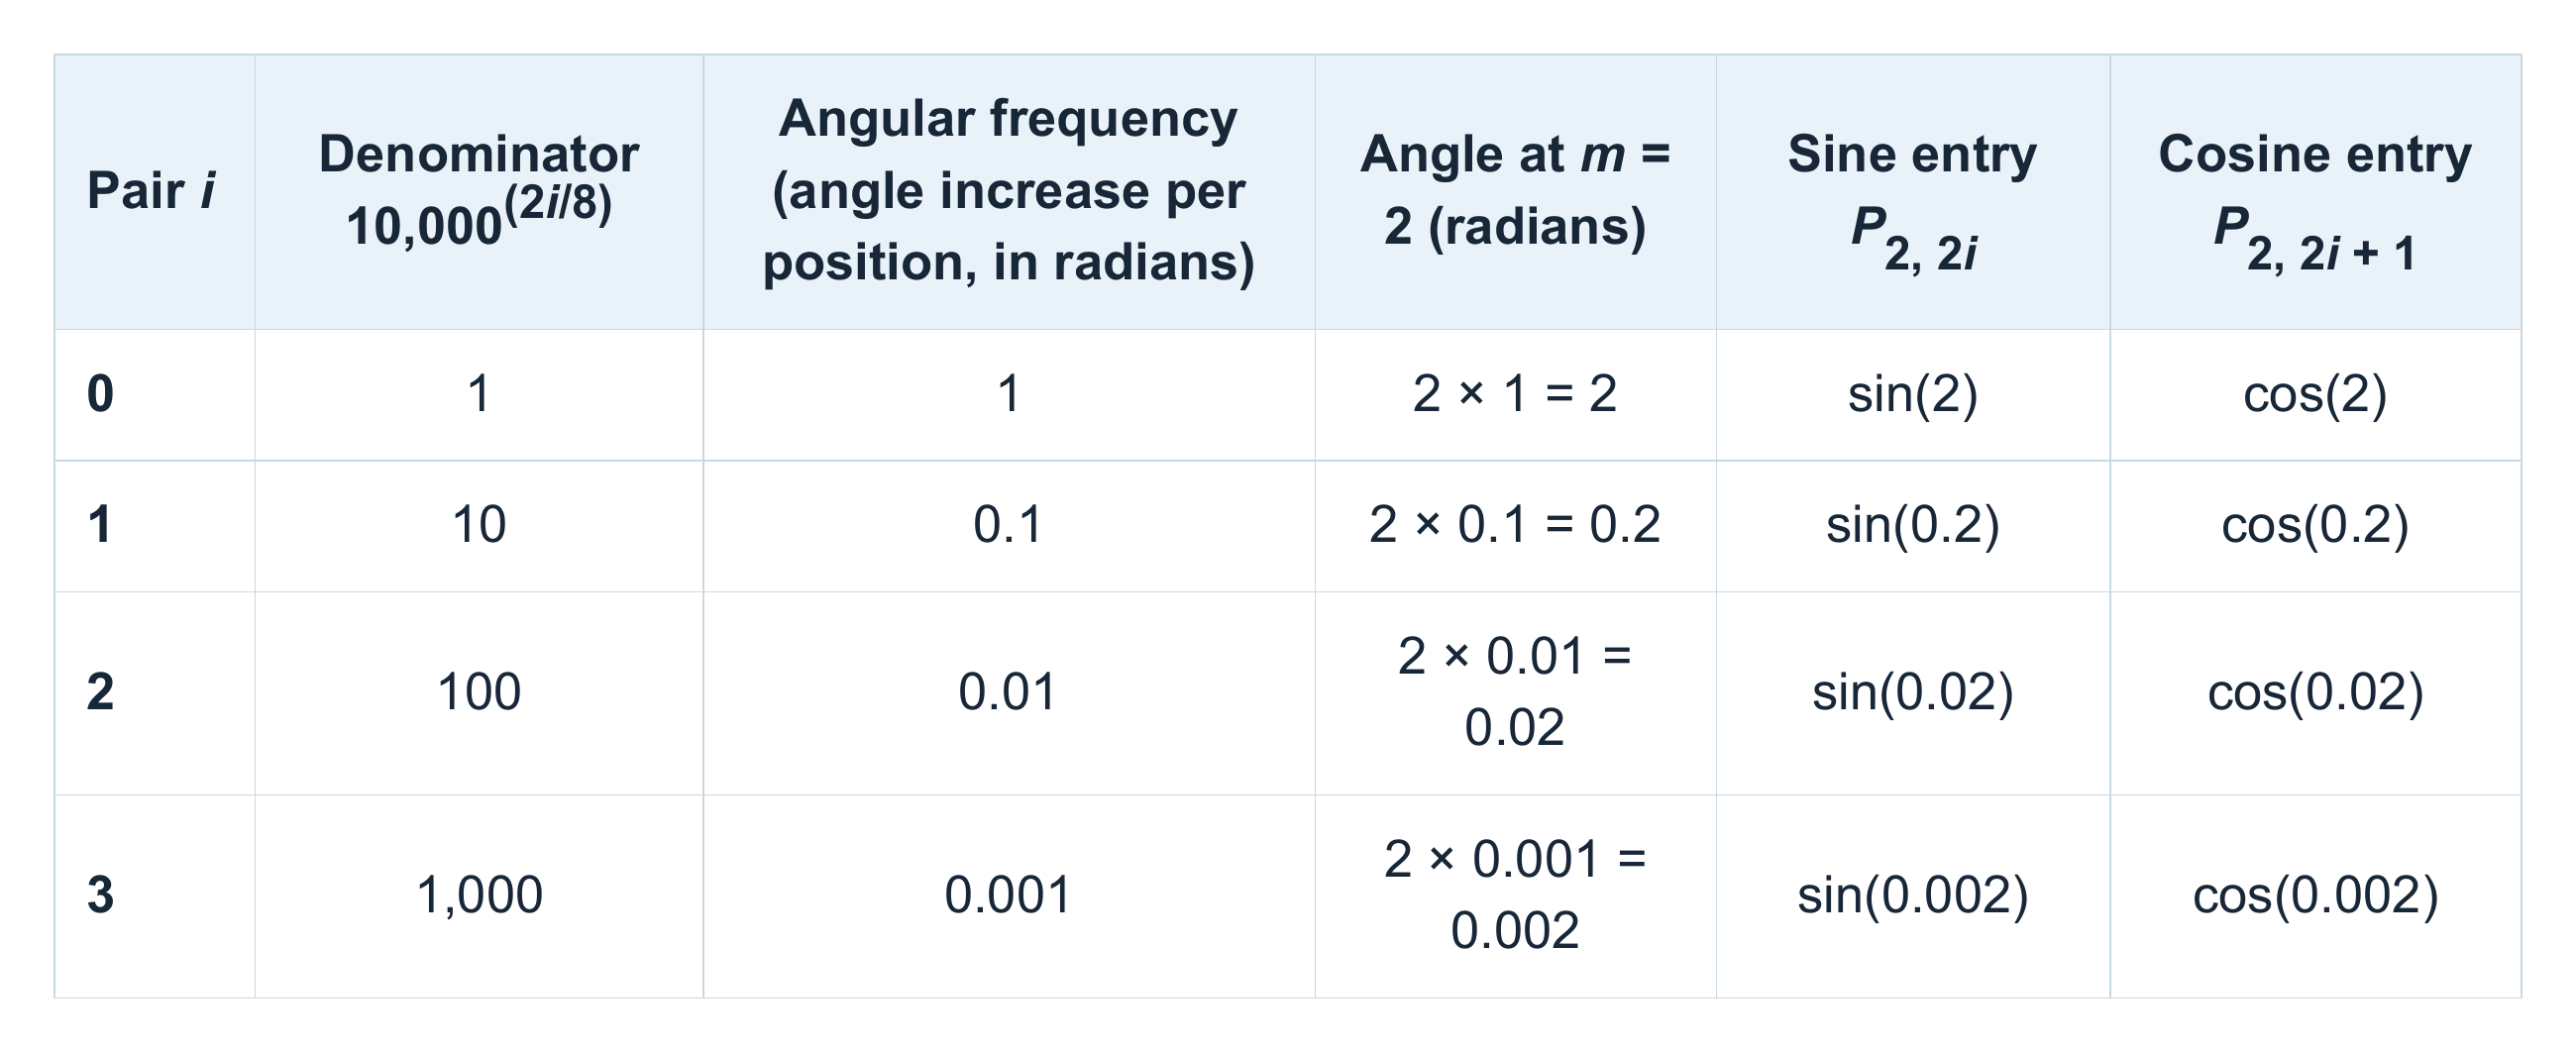
对于 8 维特征嵌入,4 个频率分别为每个位置 1、0.1、0.01 和 0.001 弧度。在位置 2,第 1 行的第一对值为 (sin 2, cos 2) ≈ (0.909, −0.416)。
第 2 行的第二对变化得更慢,结果为 (sin 0.2, cos 0.2) ≈ (0.199, 0.980)。
下图直观展示了不同维度对的正弦与余弦计算过程,计算结果随后汇集为一个位置向量。
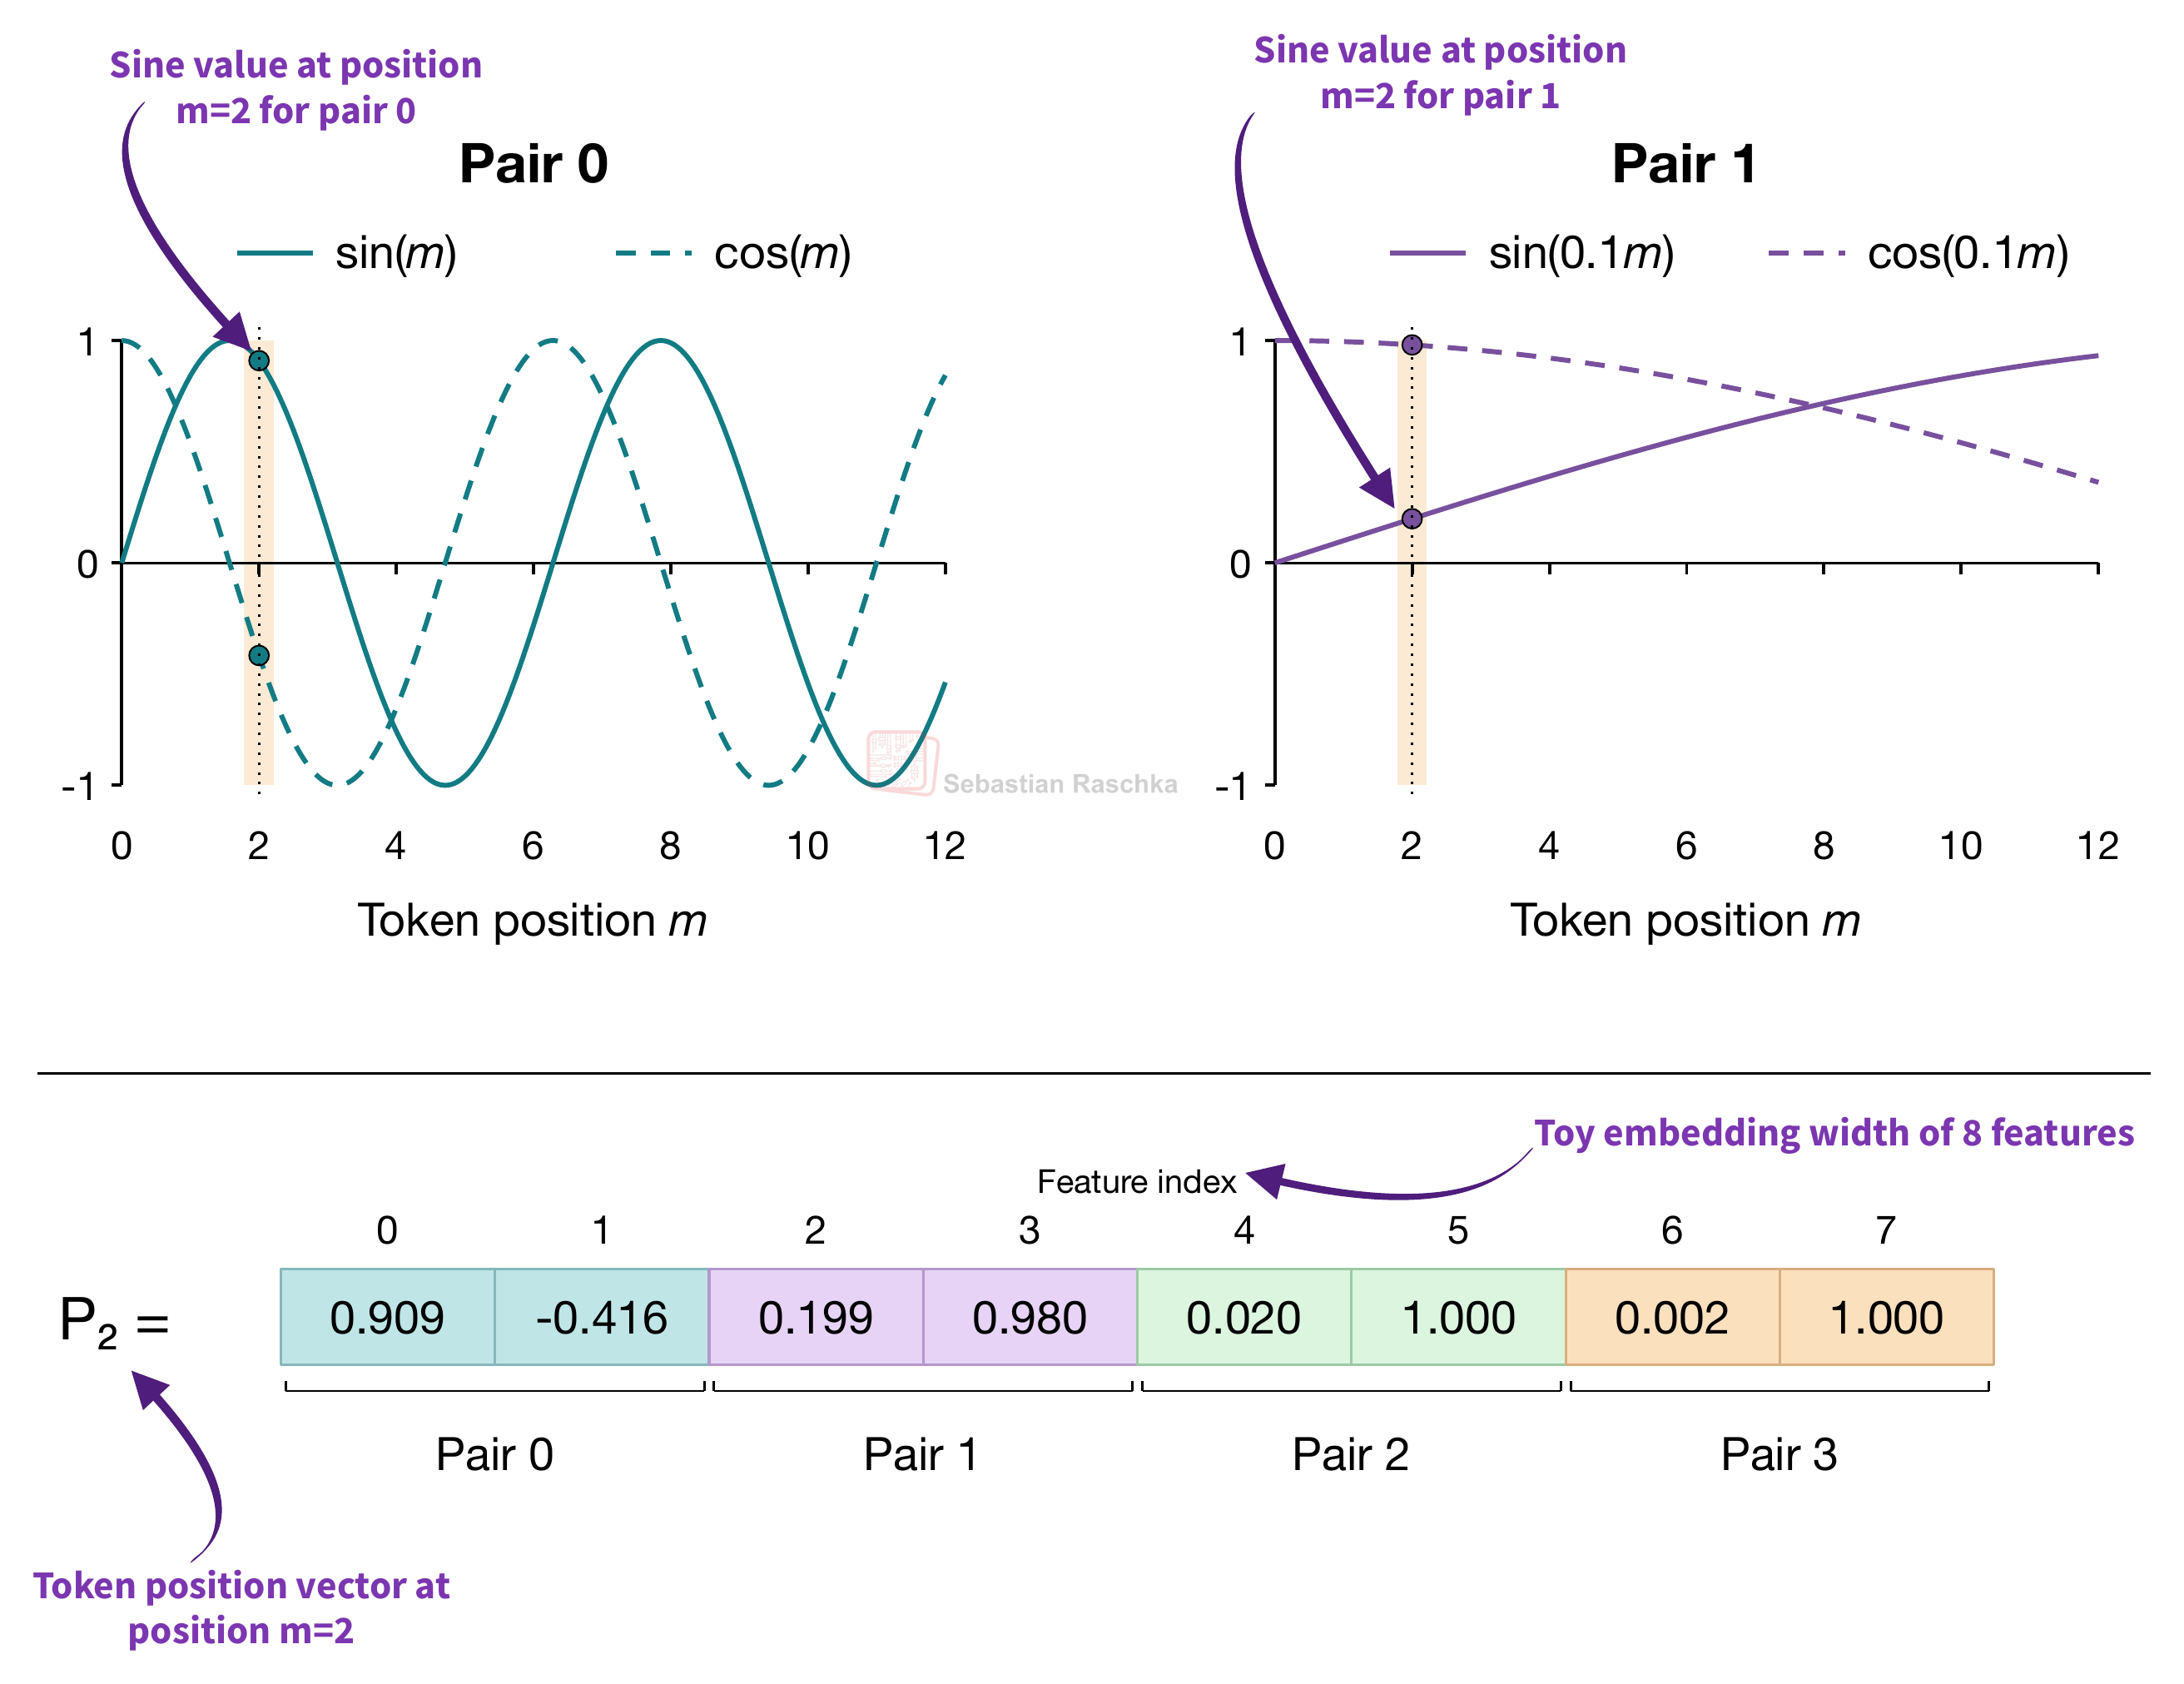
简而言之,与前面讨论的 GPT-2 方案相比,这种方法是获取位置嵌入向量的一种替代方案(尽管更为复杂)。
与 GPT-2 嵌入类似,这也是一种绝对位置嵌入,因为每个向量都由其自身的位置直接计算得出。不过与 GPT-2 的方法不同,正余弦函数在训练过程中保持固定不变。(此外,它们还可以外推到训练位置之外进行评估,例如突破 1024 的上下文长度;当然,仅凭这一点并不能保证模型在更长序列上表现良好,毕竟模型在训练中从未见过那些位置。)
总结一下,下图 12 对比了我们目前讨论过的两种获取位置向量的方式。
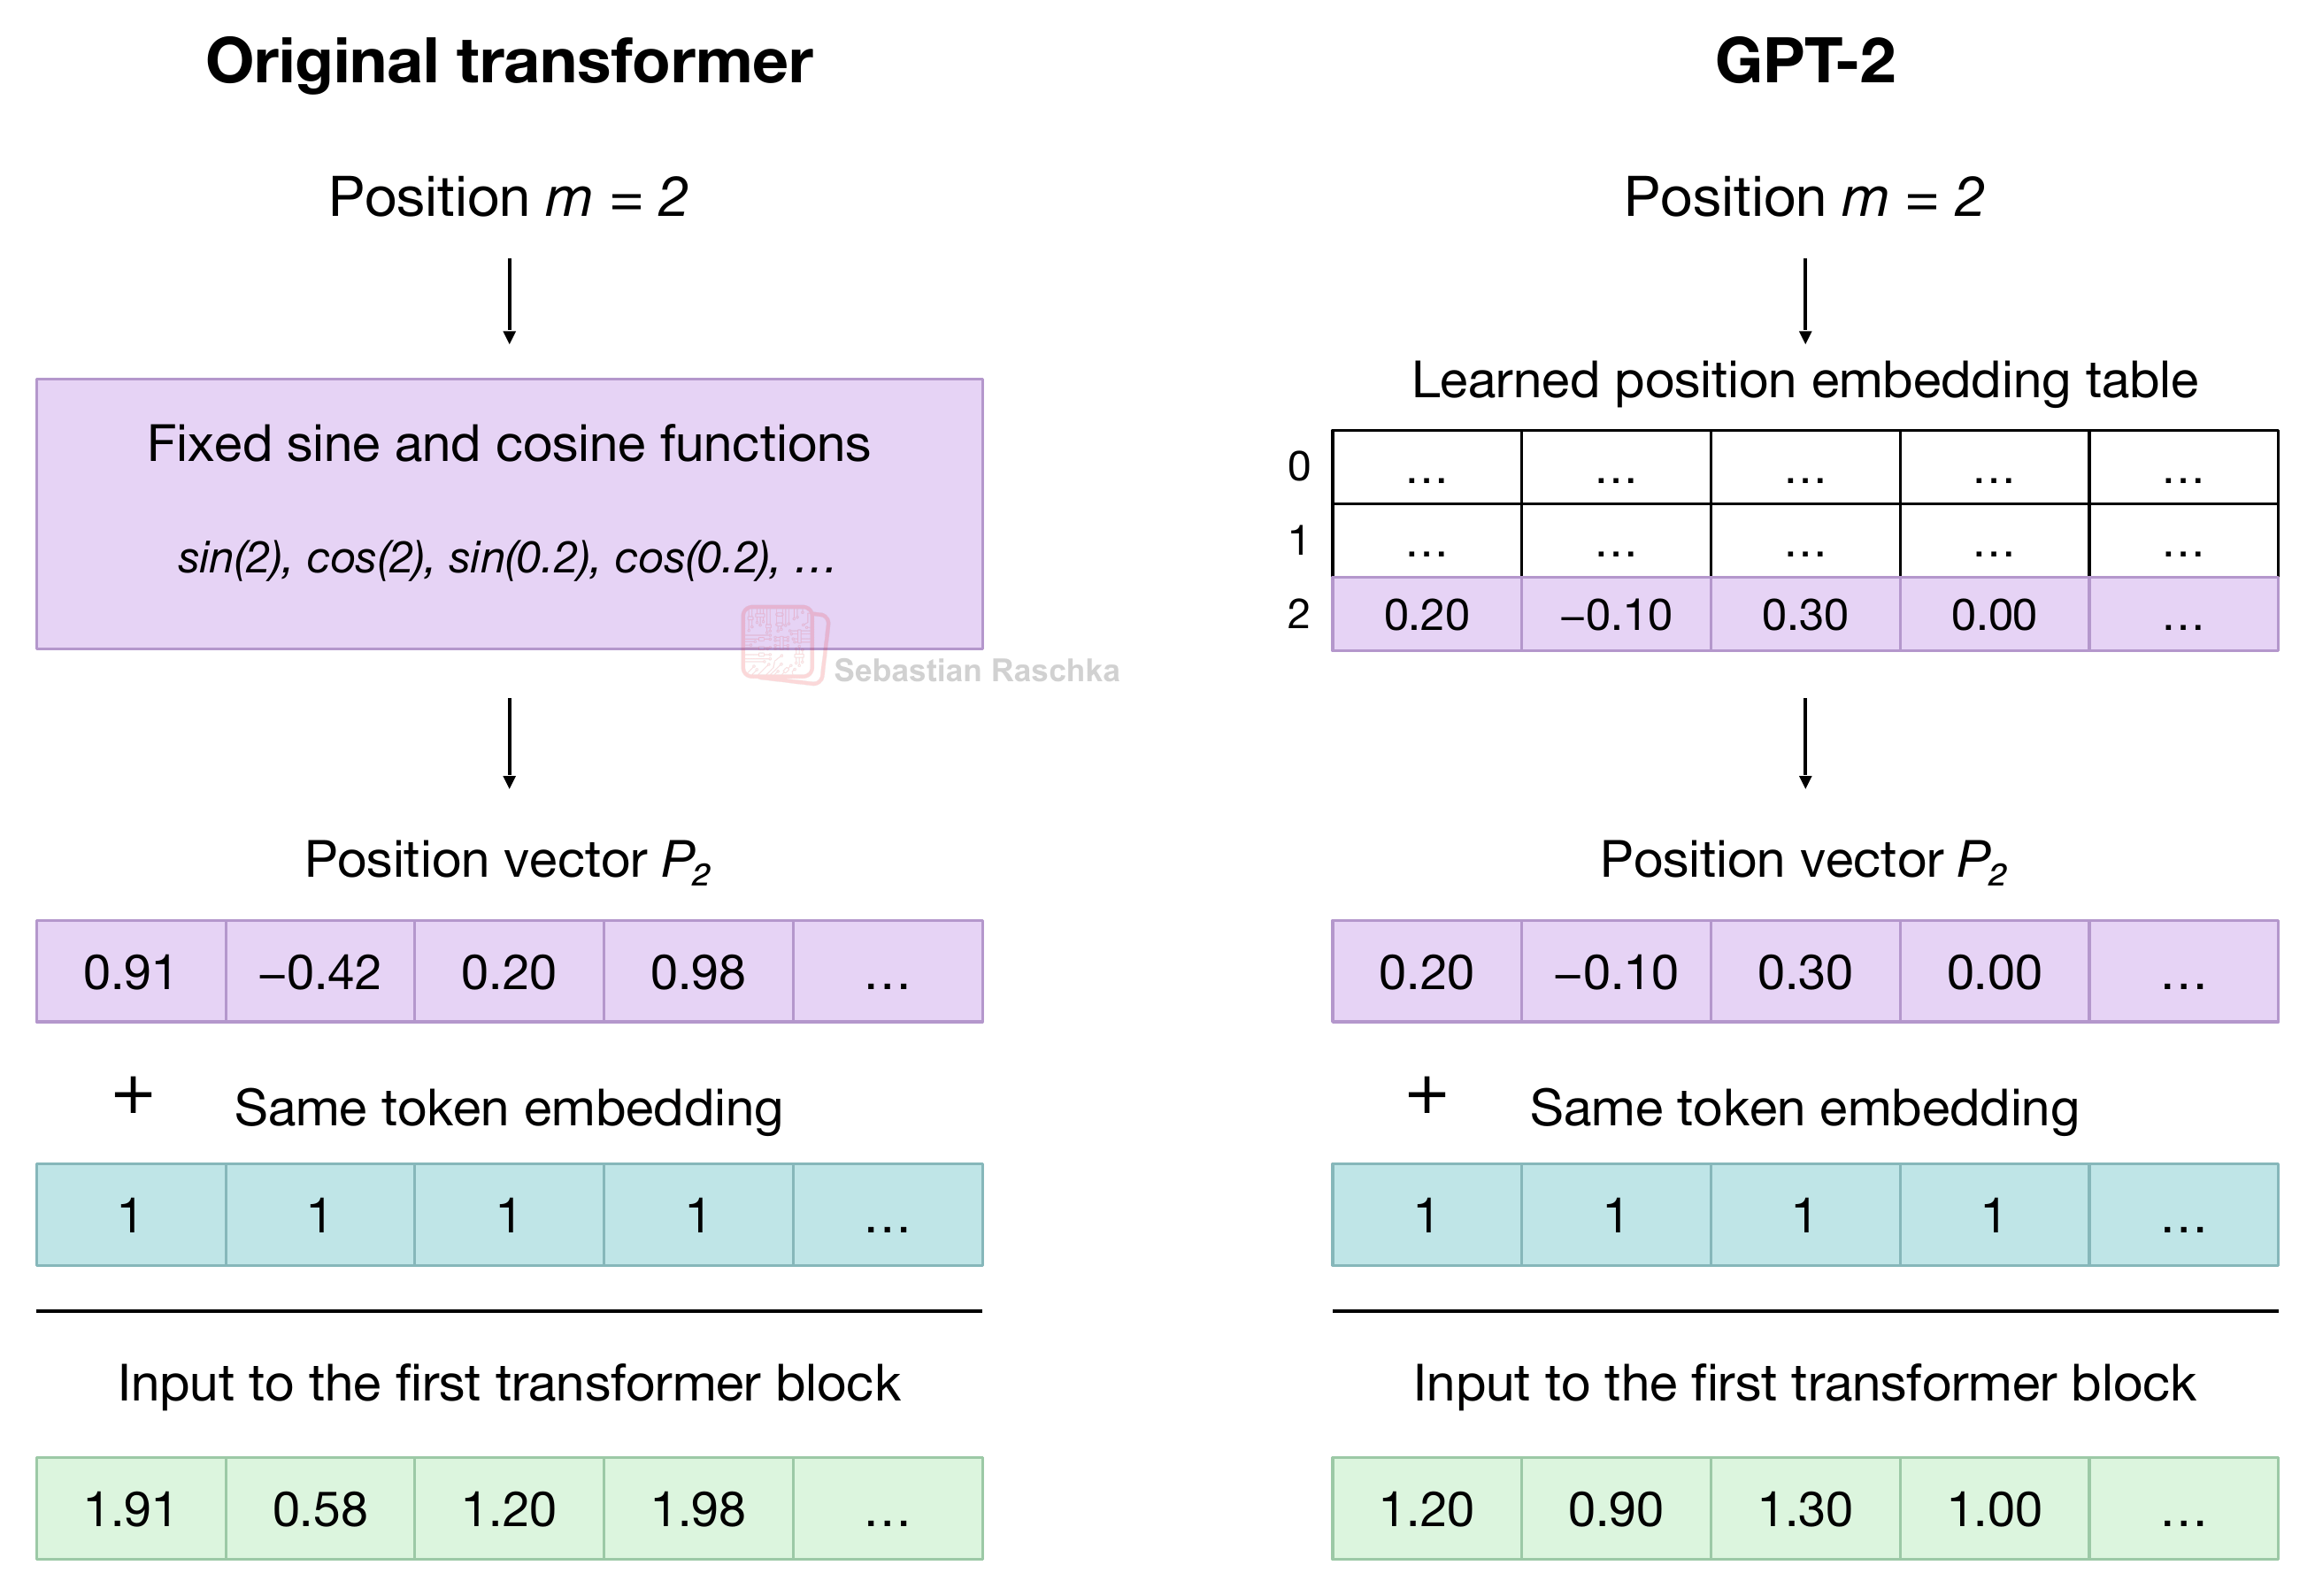
这种正弦函数方法看起来可能有些过于复杂,但理解它对下一节探讨 RoPE 大有裨益。
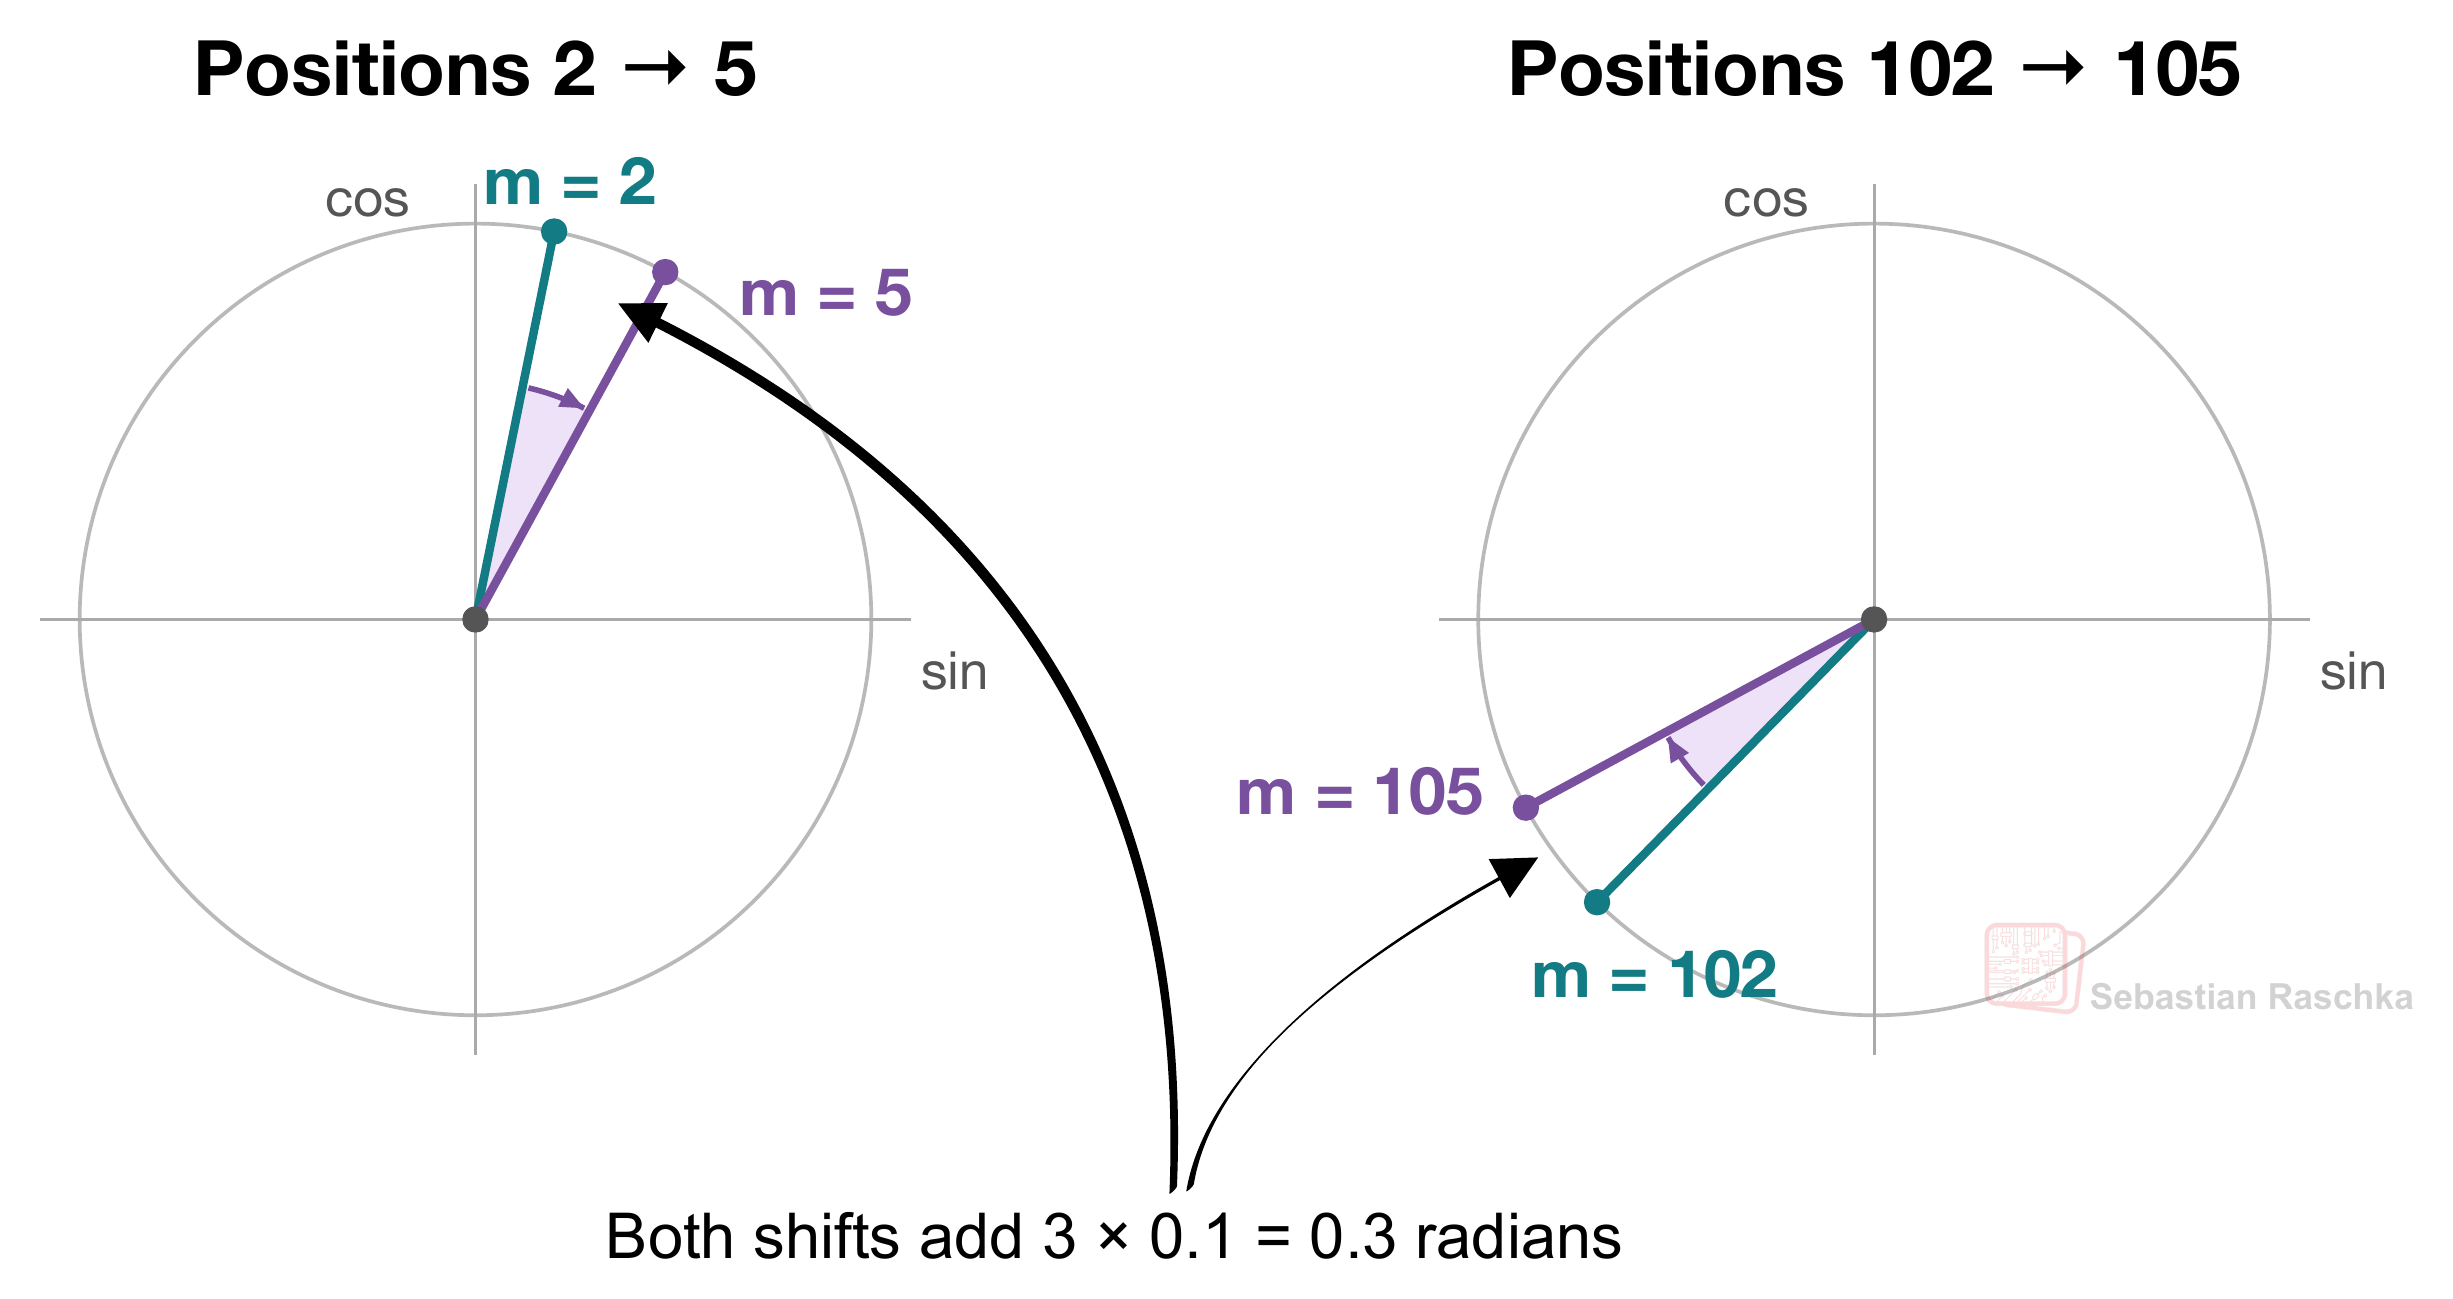
而且,这种设计背后也有其合理性。作者之所以选择正弦和余弦,是因为平移一定偏移量会产生确定性的差异。例如,位置 2 到 5 的差值与位置 102 到 105 的差值都是 3,从而对应完全相同的旋转。
正如论文《Attention Is All You Need》中所述:
“……更容易学会依相对位置进行注意力计算,因为对于任意固定的偏移量 k,PEpos + k 都可以表示为 PEpos 的线性函数。”
通俗地说,作者假设这一特性可以让注意力机制更容易学会诸如“前 3 个 token”之类的相对关系。
下图 13 展示了一对正余弦分量的情形。旋转是一种线性变换,两次平移 3 个位置所对应的旋转完全相同。
3. 用 RoPE 编码相对位置
因此,上述正弦方法仍被视为一种绝对位置编码,因为加到每个 token 嵌入上的向量表示的都是该 token 距离序列开头的绝对位置。
比如在上图中,位置 2 和位置 5 的 token 分别获得位置向量 P2 和 P5。如果把这两个 token 移到位置 102 和 105,它们之间的距离依然是 3 个位置。但由于绝对位置 m 变了,每个 token 分配到的位置向量也会随之改变。
这样一来,即便 token 嵌入完全相同,它们的注意力分数也可能发生变化。不过,正弦结构依然赋予了模型学习相对位置关系的能力。
话说回来,下文要讨论的 RoPE 则直接将这种相对关系融入了注意力计算之中。RoPE 是旋转位置嵌入(Rotary Position Embedding)的缩写,由 Su 等人在 2021 年的 RoFormer 论文中提出,被归类为一种相对位置编码方法。
3.1 RoPE:将旋转操作移至注意力机制内部
在注意力机制中,每个 token 的当前表示都会被投影成 Query、Key 和 Value 向量。Query 与 Key 的点积决定注意力分数,经过掩码(masking)和 softmax 处理后得到的权重,则用来对 Value 向量进行加权融合。如果想温习这部分内容,可以参考我的文章《深入理解与代码实现大语言模型中的自注意力、多头注意力、因果注意力与交叉注意力》:
RoPE 在计算 Query 和 Key 的点积之前,会根据 token 的位置对其进行旋转变换,而 Value 向量则不参与旋转。下图 14 展示了较新的 MiniMax-M3 模型中 RoPE 的具体应用位置;在该模型中,QK-Norm 会在应用 RoPE 之前先对 Query 和 Key 进行归一化。
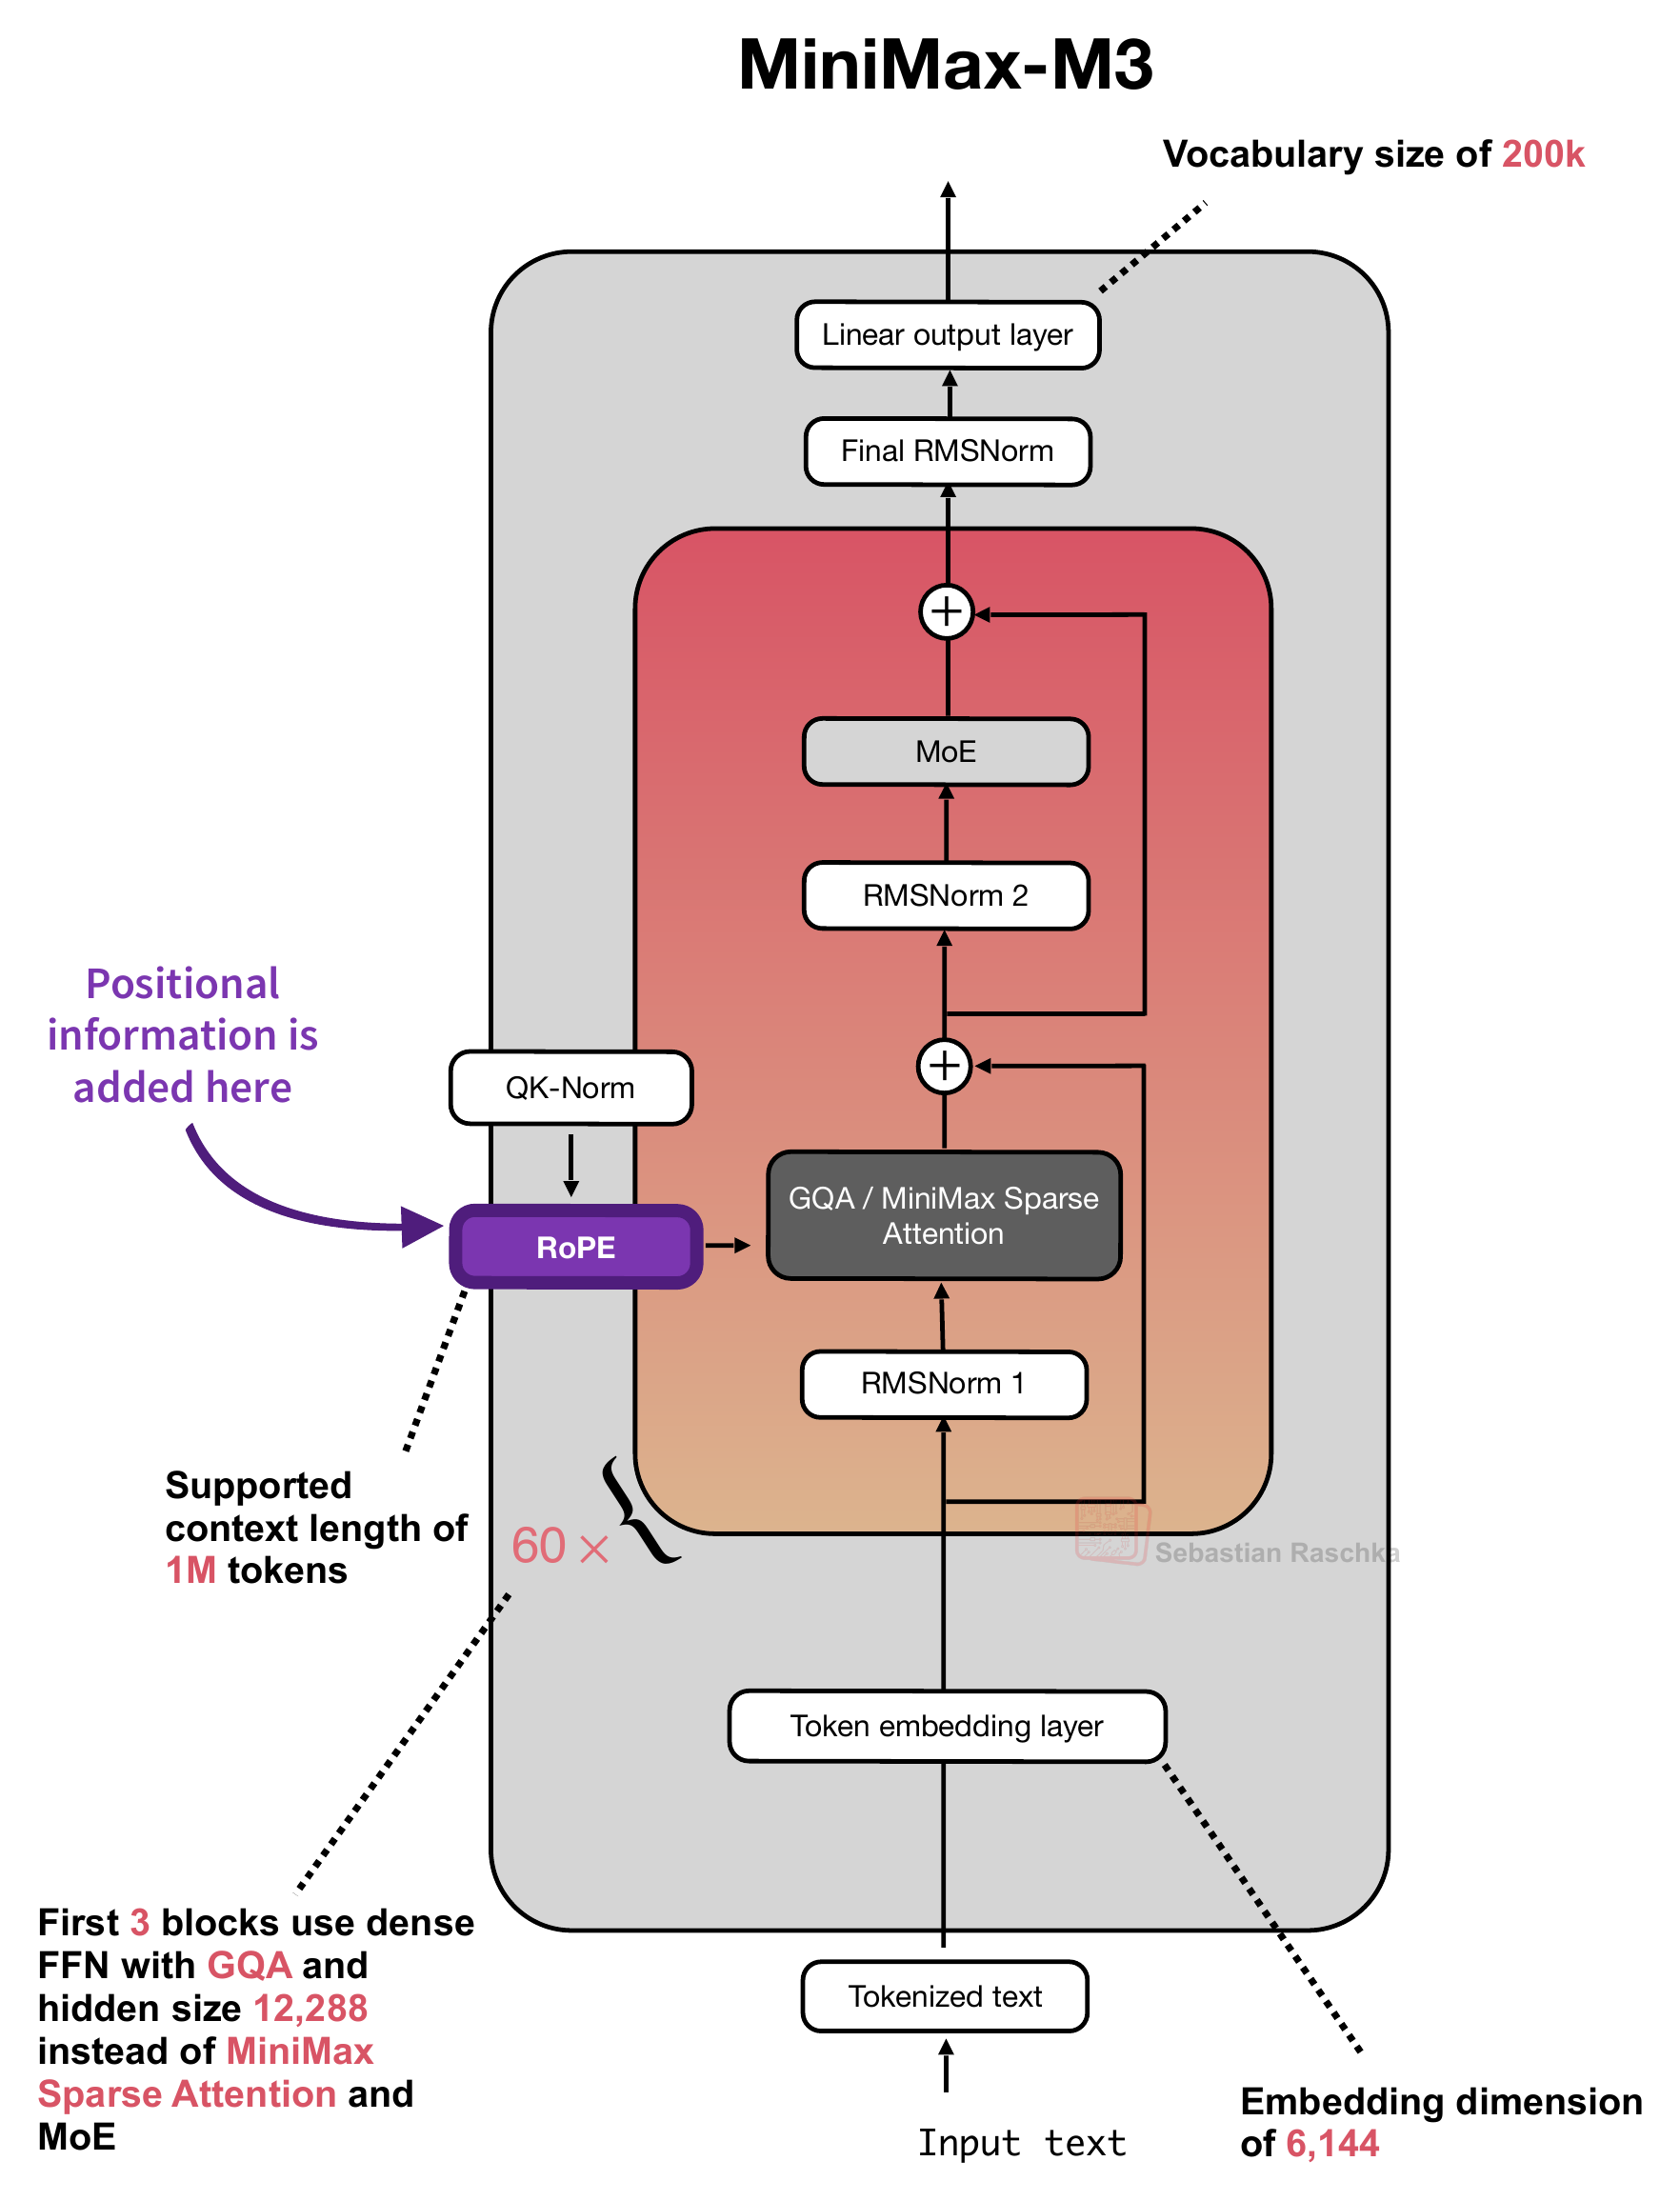
从上图可以看出,该大模型架构并没有在初始 token 嵌入上直接累加显式的位置向量,而是将显式的位置信号注入到了注意力计算内部。
顺带一提:MiniMax-M3 只对每个 Query 和 Key 头的部分维度进行旋转,这种变体被称为“部分 RoPE”(partial RoPE),我们会在后文的 6.1 节详细介绍。不过,为了先理清 RoPE 的基本操作,我们不妨先通过一个简单示例一步步拆解该方法。
3.2 RoPE:从 token 表示到特征配对
注意力机制通常会将 Query、Key 和 Value 特征切分成多个头进行并行处理,因此整套机制通常被称为多头注意力(注意,分组查询注意力 GQA 同样采用多头设计)。在这种架构下,每个注意力头各自计算注意力分数并求加权和。随后,RoPE 会作用于每个 Query 和 Key 头内部成对的数值上。
为了更直观地说明这一点,下图 12 追踪了一个 token 表示经过权重矩阵 WQ 和 WK 映射成 Query 和 Key 投影的过程。在这个简化示例中,每次投影生成 16 个特征,并重整为 2 个头,每个头包含 8 个特征。在下图中,每个小方格代表一个标量特征,也就是向量中的一个数值项(受篇幅所限未列出具体数值)。
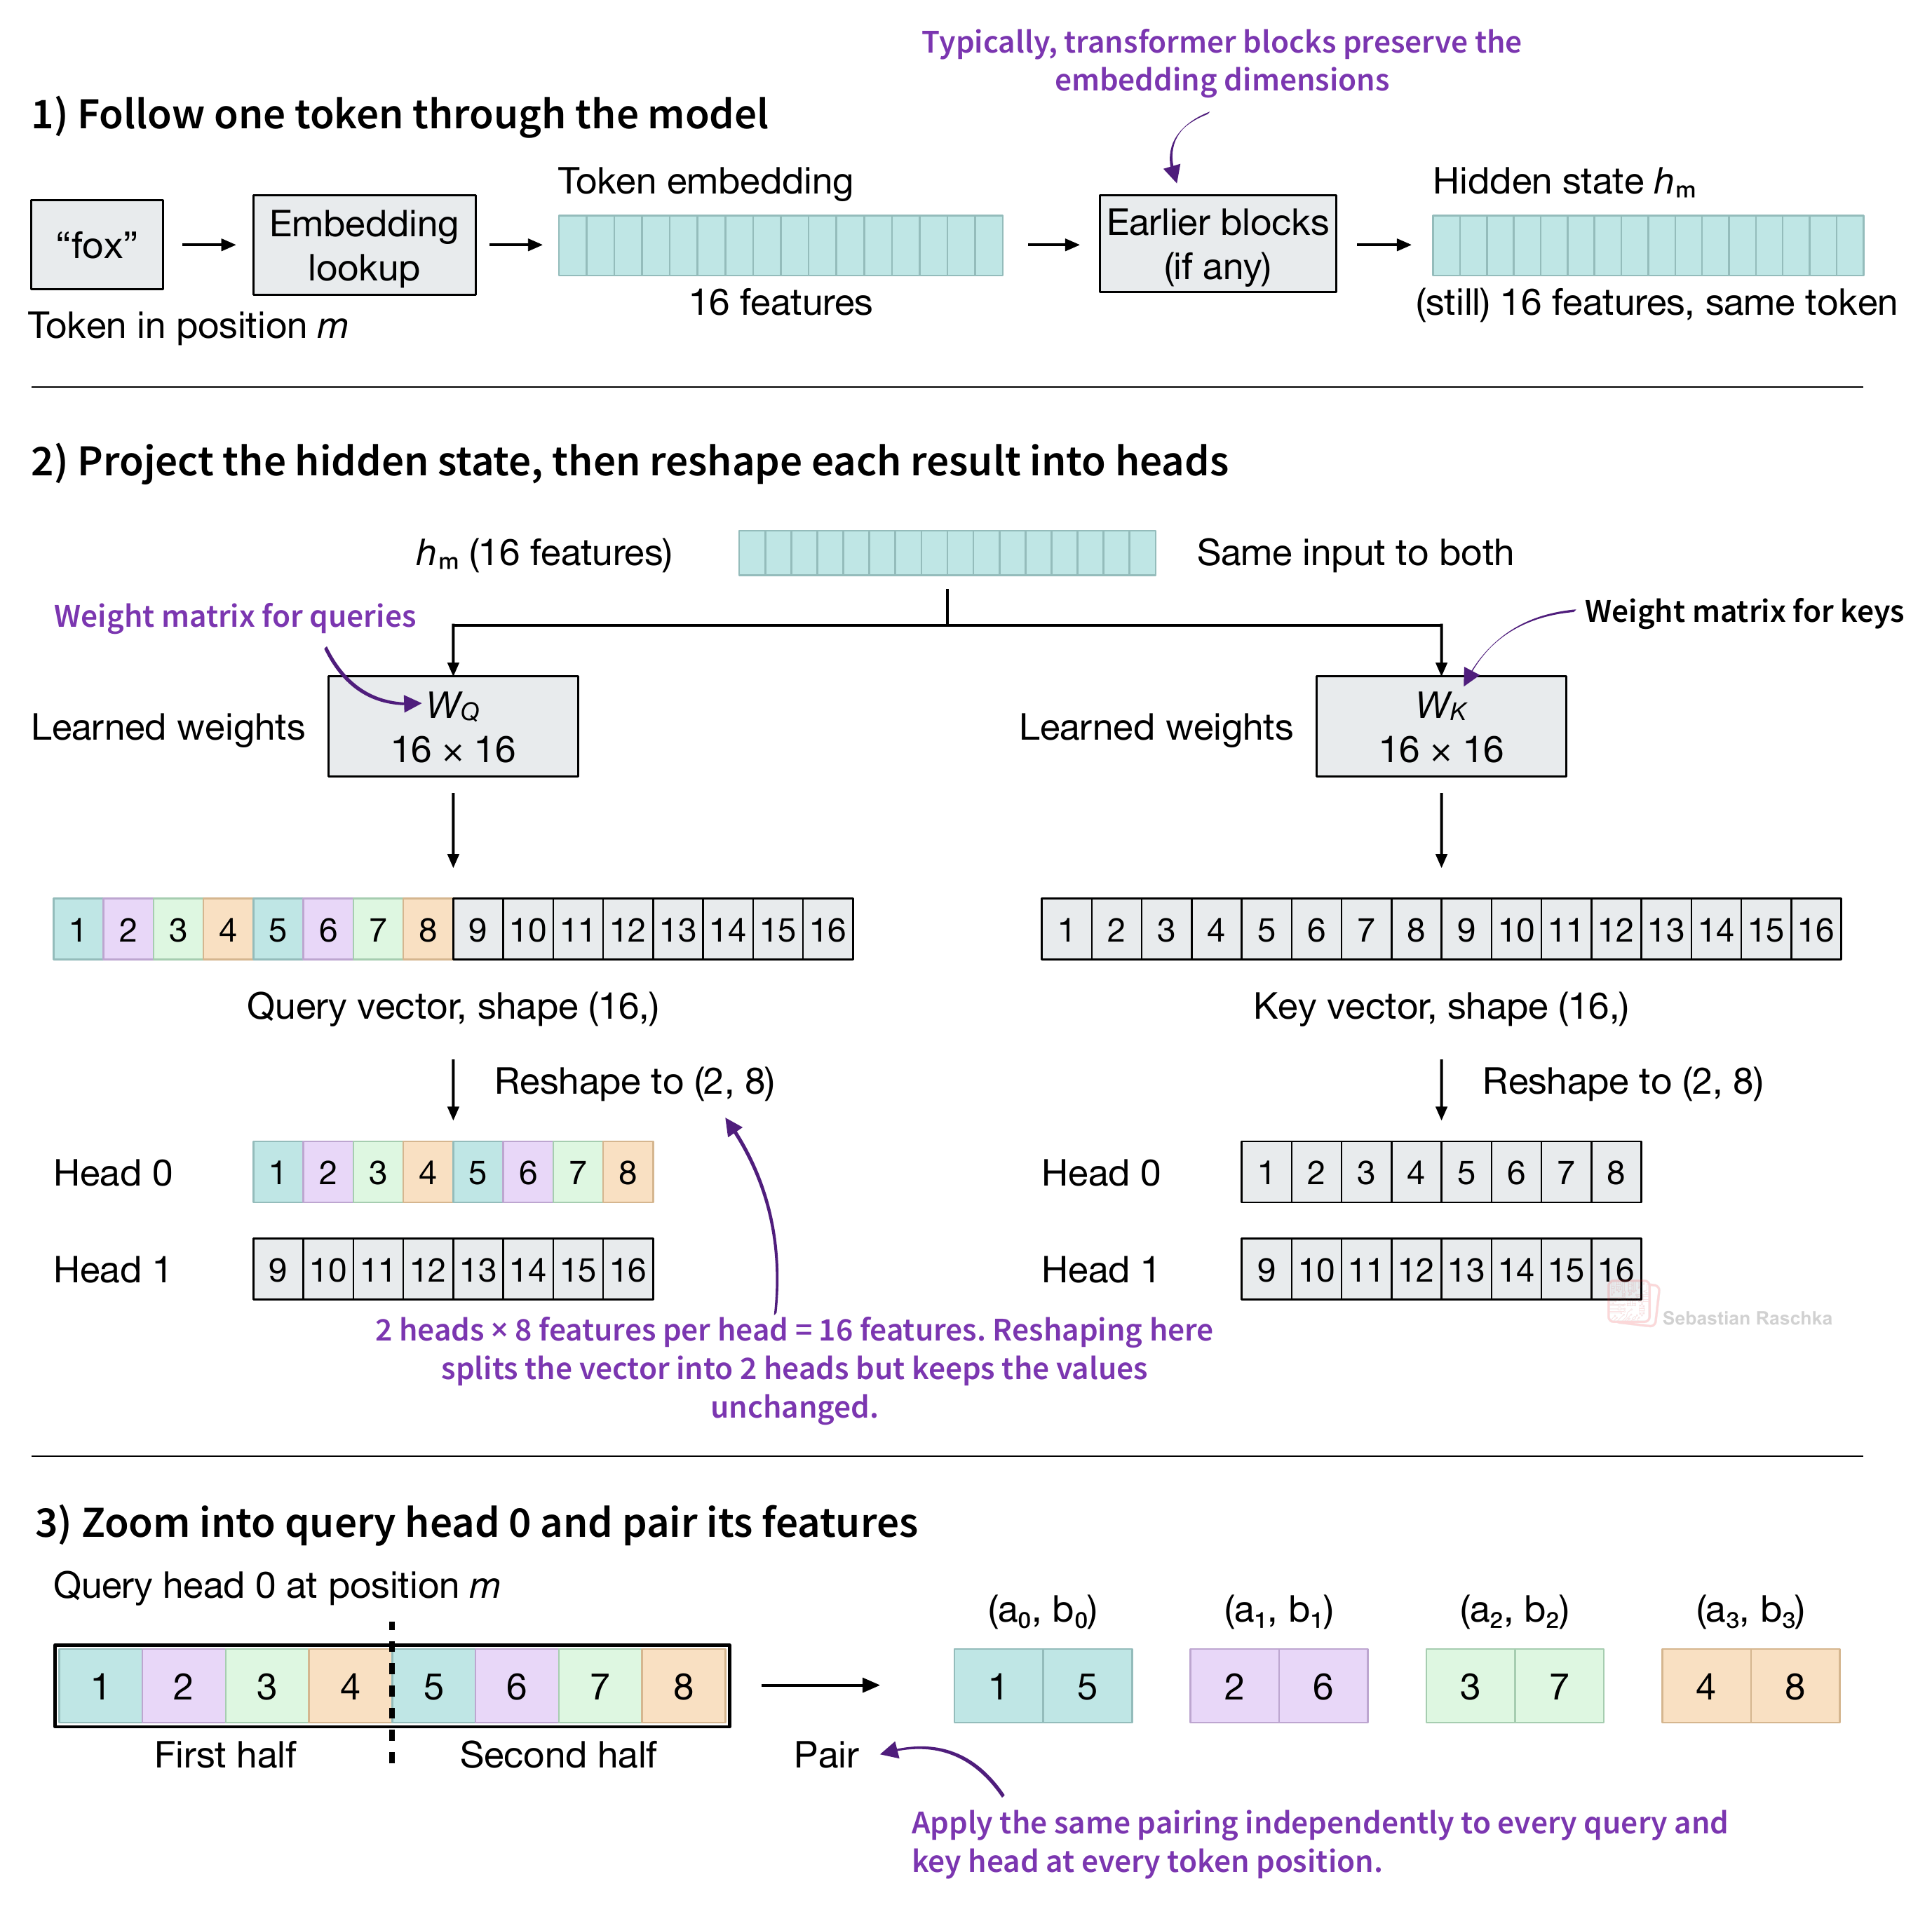
对于第一个包含 8 个特征的注意力头 [1, 2, 3, 4, 5, 6, 7, 8],我们将前半部分的每个特征与后半部分的对应特征两两配对,得到 (1, 5)、(2, 6)、(3, 7) 和 (4, 8)。这种“对半拆分(split-half)”约定在各类大模型实现中广泛使用,包括我的 Qwen3 实现。(在完成基础操作的实现之后,我们稍后再将其与最初采用的另一种“相邻特征配对”方法进行对比。)
每个特征对的旋转角度由 token 位置 m 和该对对应的频率 θi 共同决定。相对应的 query 和 key 特征对使用相同的频率。下图 16 展示了我们如何旋转这些特征对、将更新后的特征放回原位,并计算 query-key 的点积。
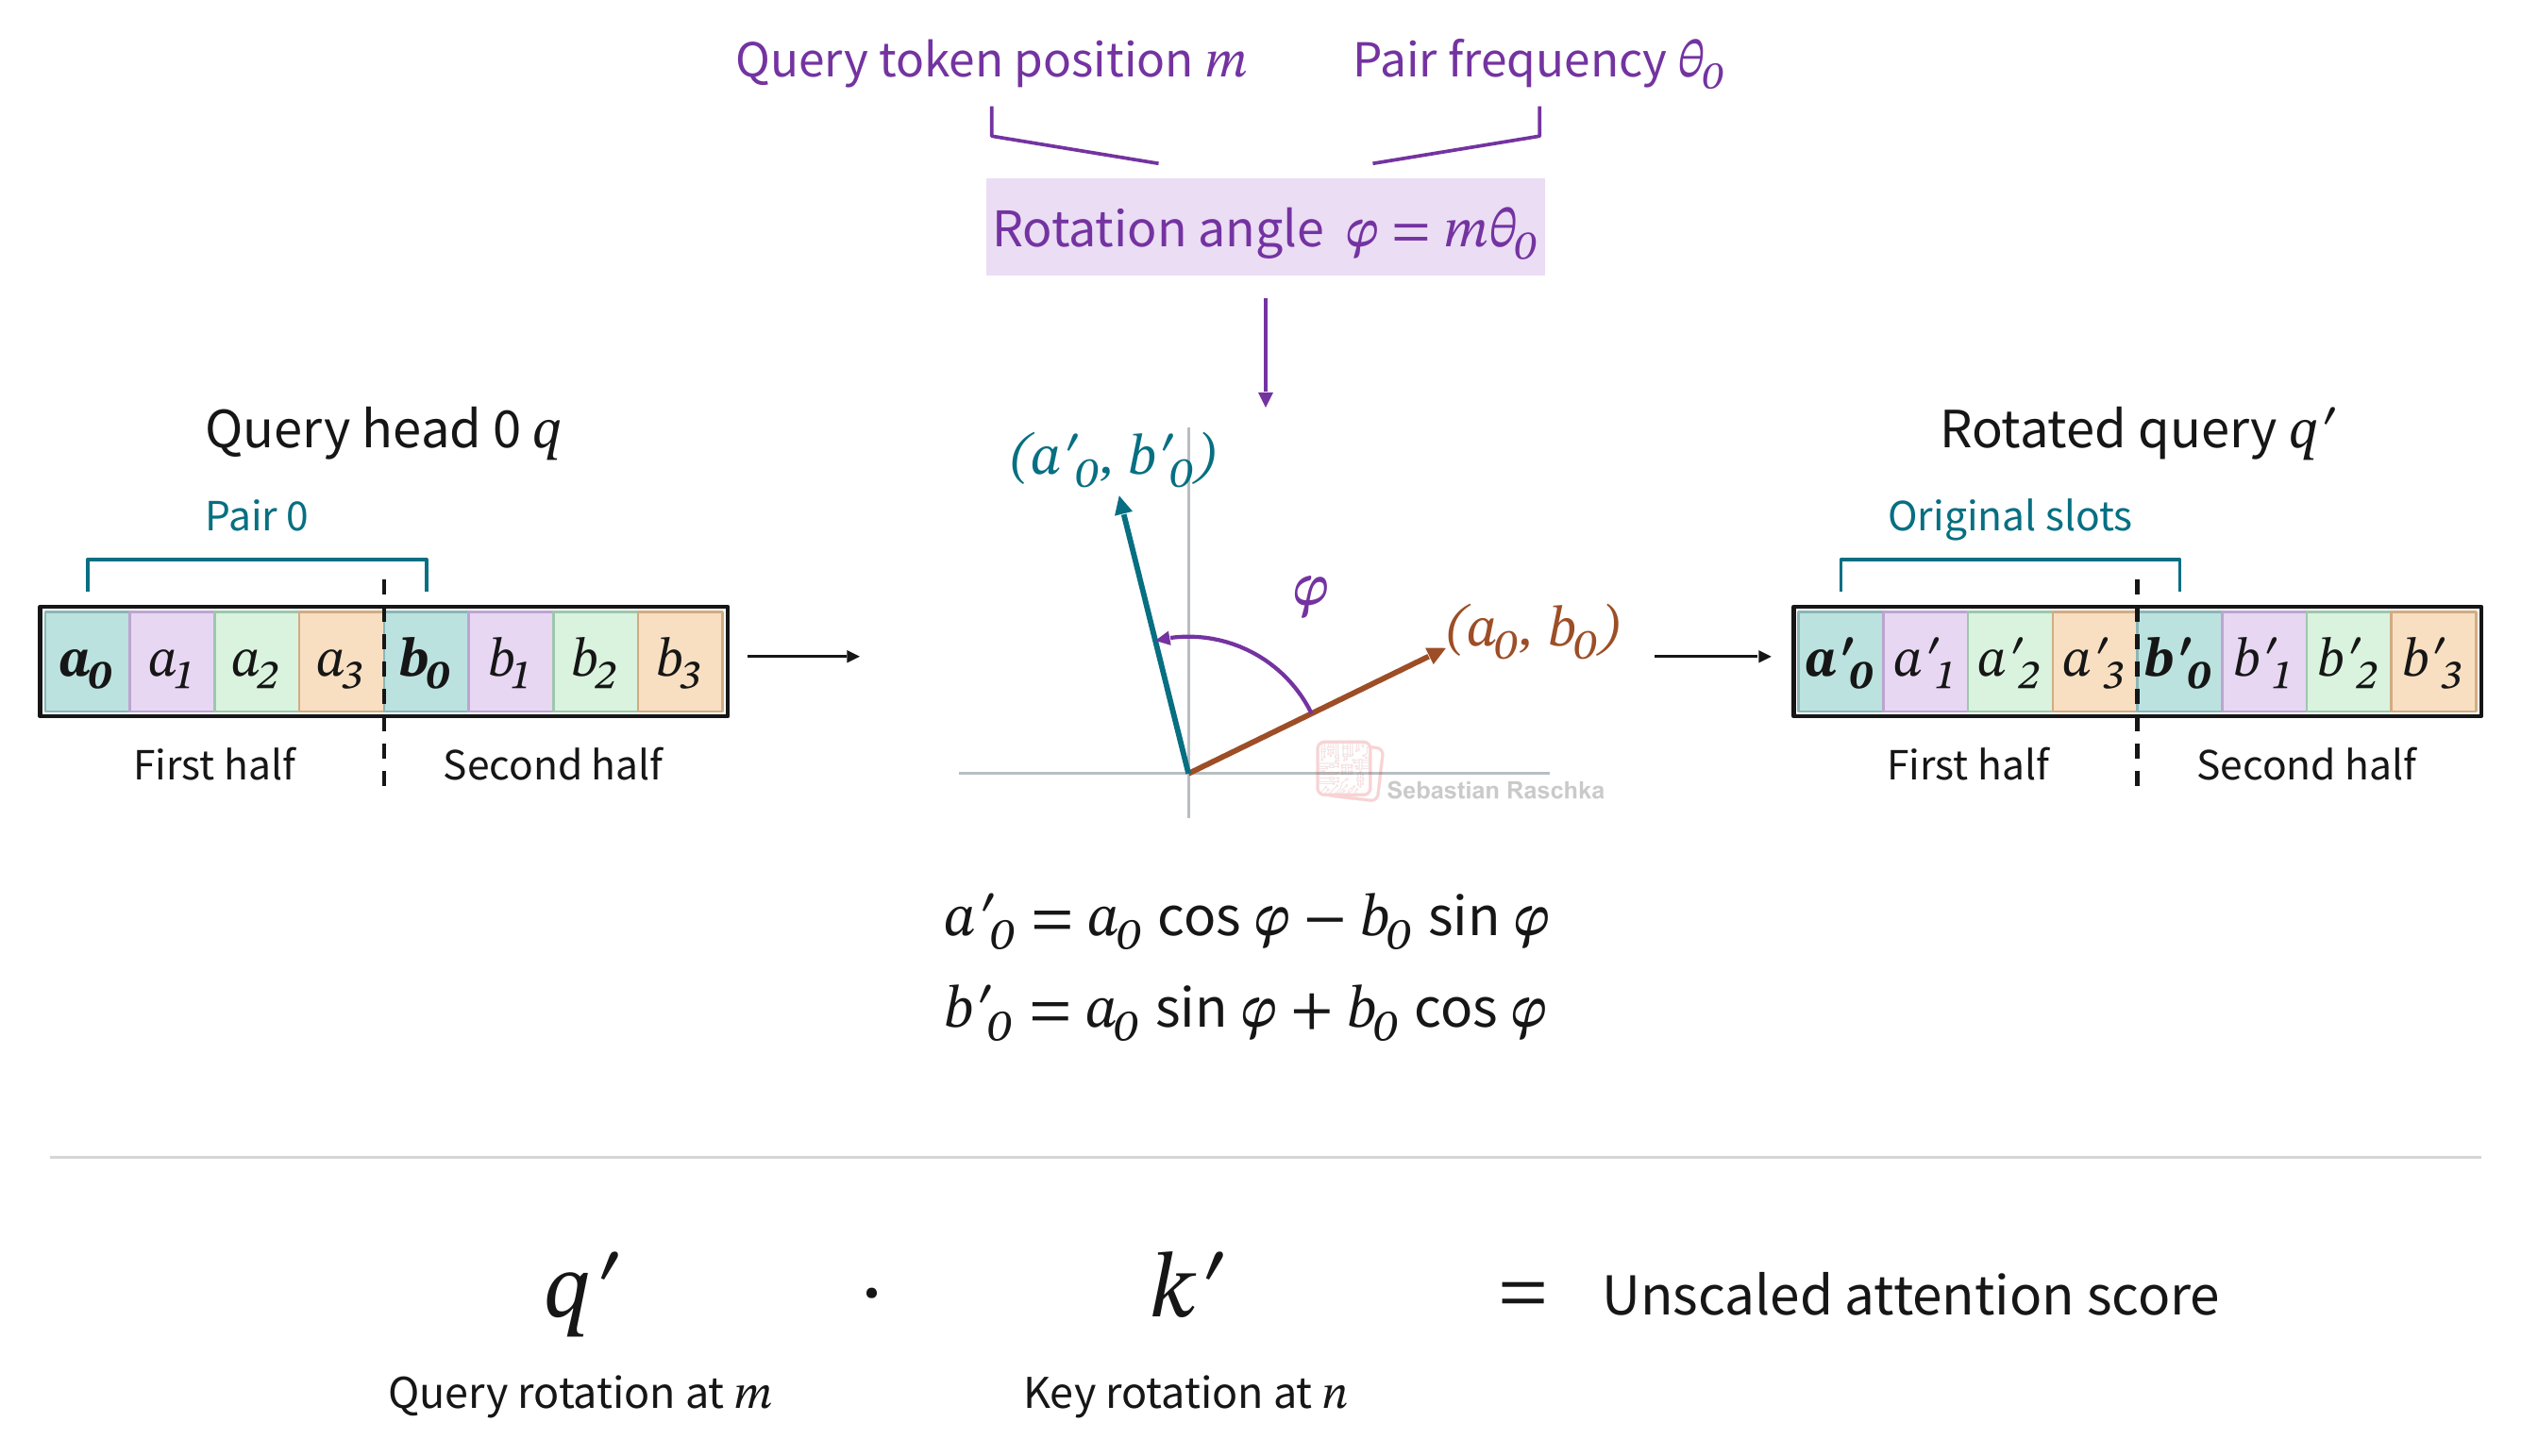
下一节将更详细地逐步解读这些图示。
3.3 RoPE 中单个特征对的旋转
在接下来的示例中,我们沿用之前的两个位置:query 来自位置 m = 5 处的“the”,key 来自位置 n = 2 处的第一个“fox”。由于本例中 key 位于 query 之前,因此因果掩码允许 query 关注到它。
为了说明位置带来的影响,在保持其他条件不变的前提下,我们假设两个特征对的初始值均为 (1, 5)。

此外,在示例中我们假设每个 token 位置的旋转角度为 θ = 20°(即每个位置 π/9 弧度)。在位置 2,我们将 key 的向量箭头逆时针旋转 2 × 20° = 40°;在位置 5,我们将 query 的向量箭头旋转 5 × 20° = 100°。
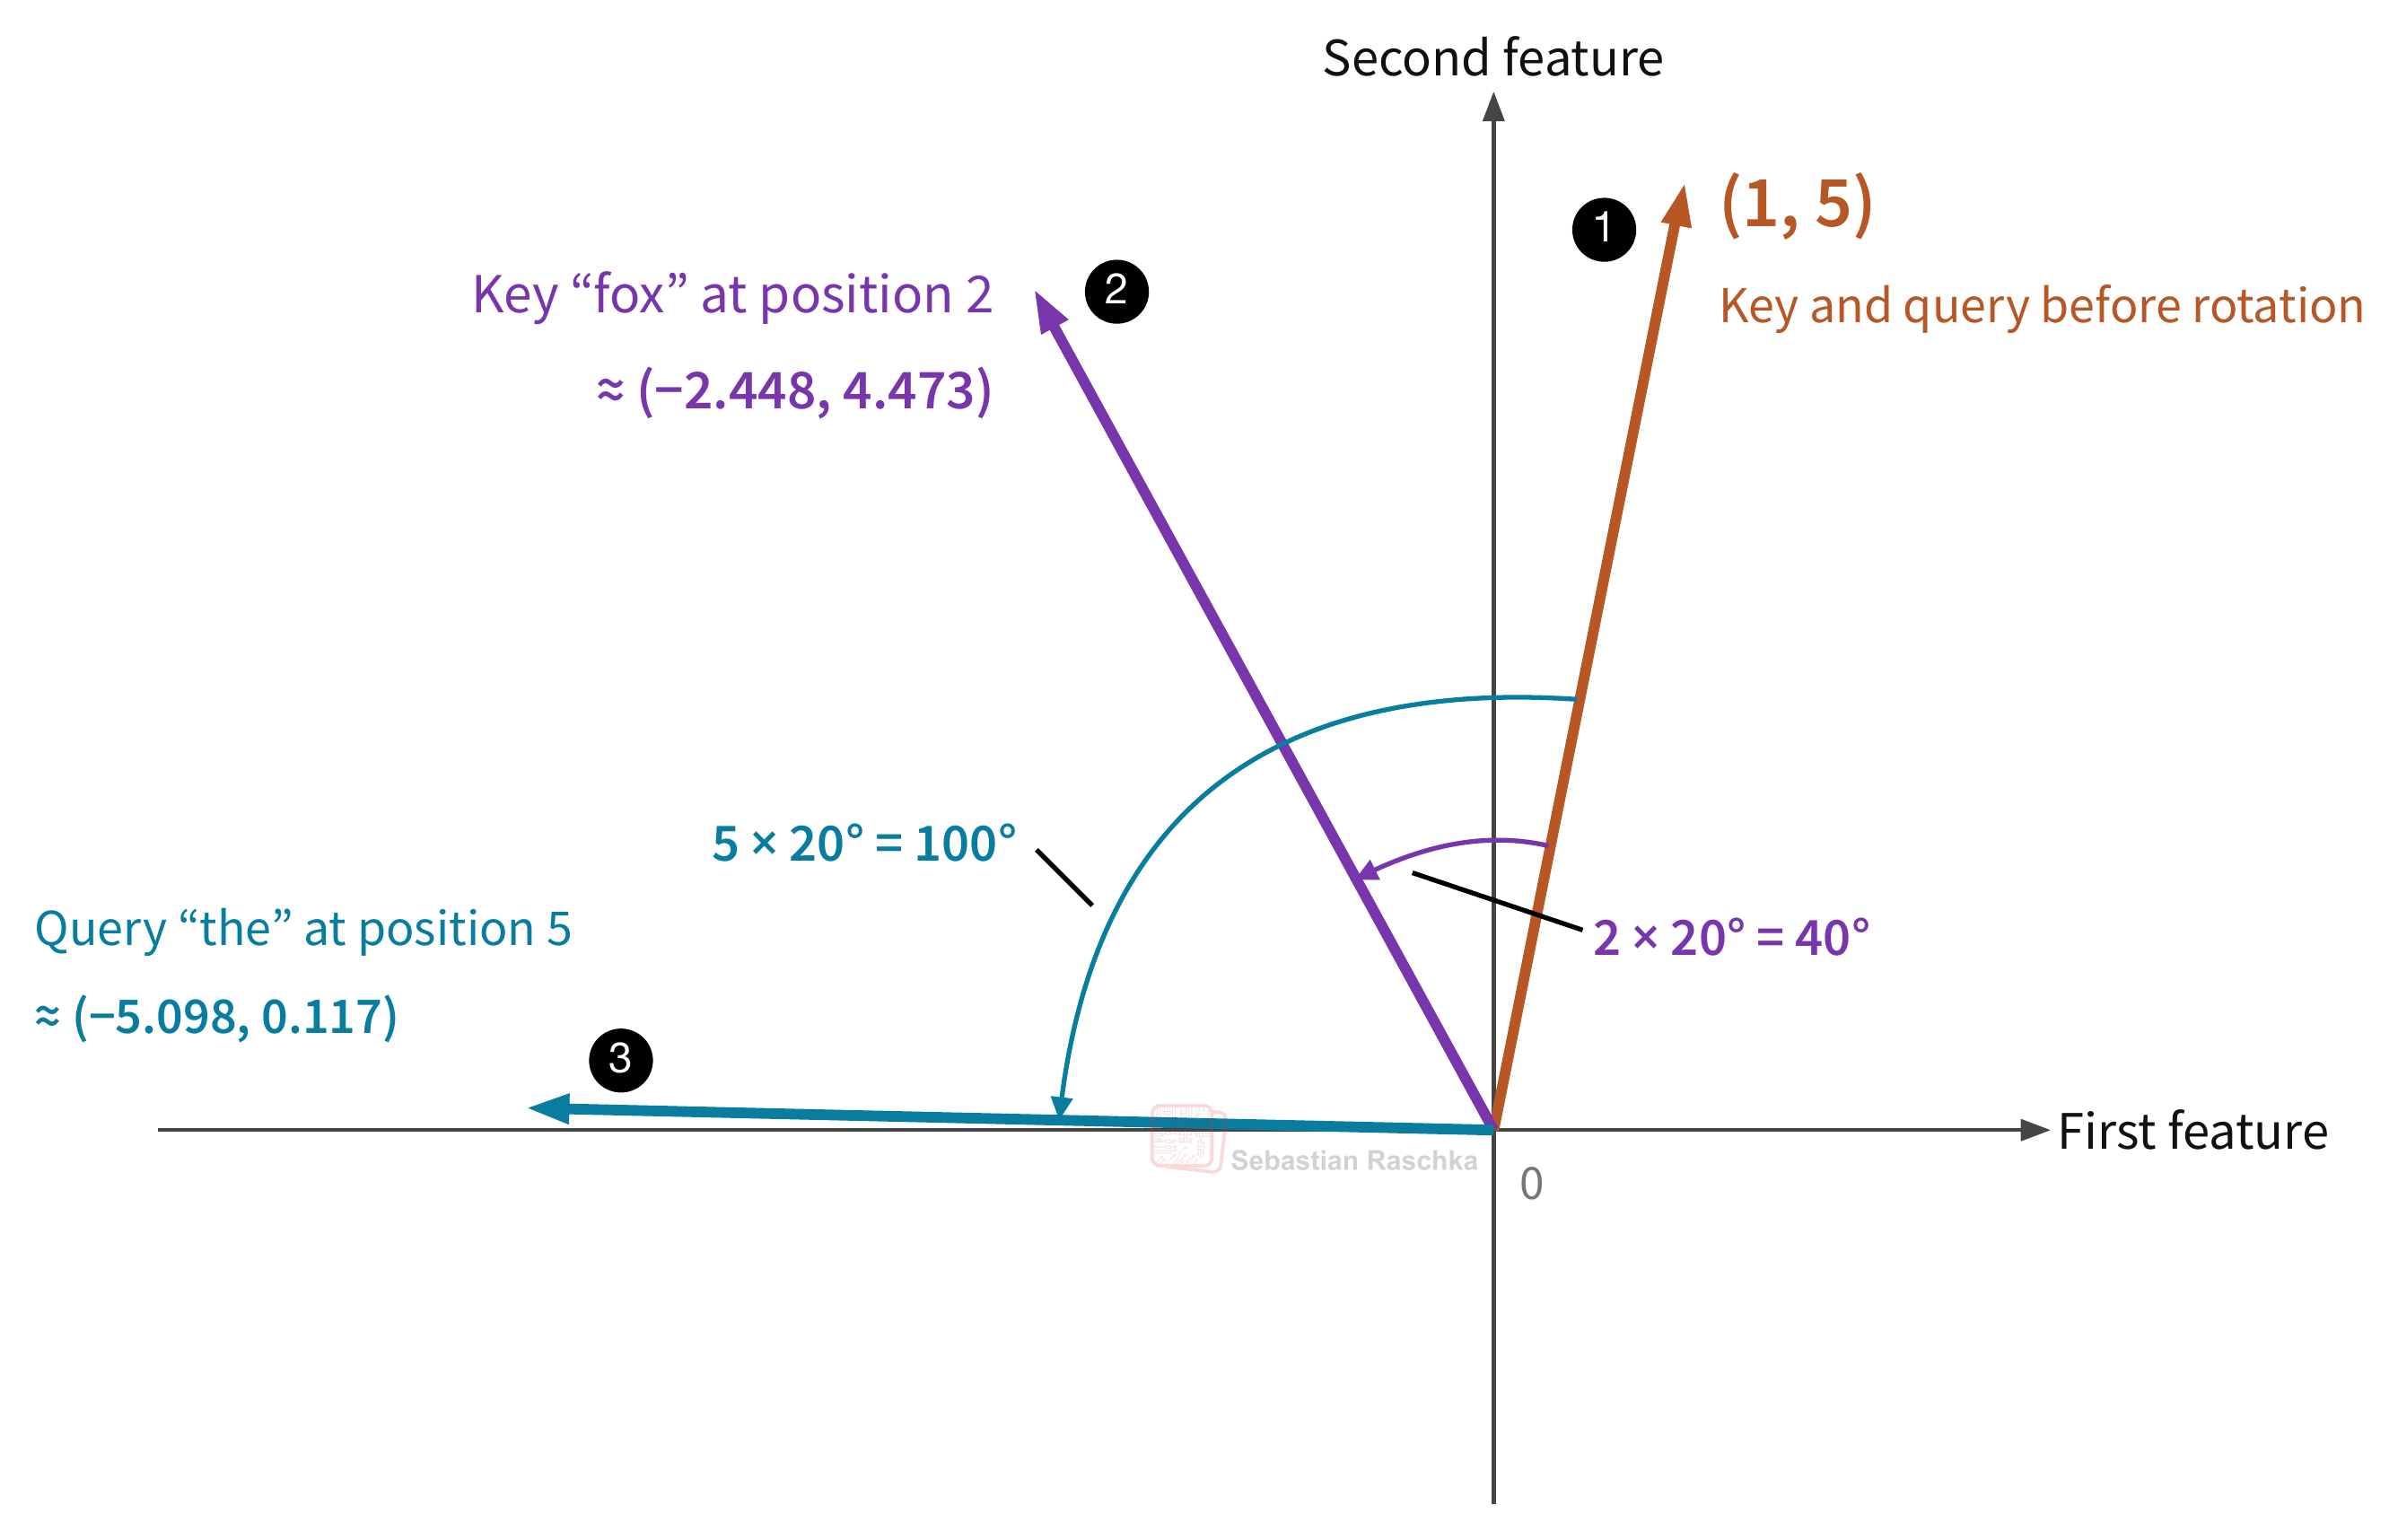
为了更直观地展示上图的过程,以计算 key 的新坐标为例,将 cos 40° ≈ 0.766 和 sin 40° ≈ 0.643 代入图 16 的旋转公式可得:

接着,用同样的公式并将角度从 40° 改为 100°,旋转后的 query 特征对变为 q′ ≈ (−5.098, 0.117)。但核心在于,两个箭头的长度依然是 √26。变换过程中改变的只有角度,向量在变换前后的长度始终保持不变。
因此,对于位于位置 m 的 query 特征对 (a, b),对应的两次运算为:

对于位于位置 n 的 key 特征对,只需在相同的公式中使用 nθ 即可。

(后文第 4 节将介绍 RoPE 如何计算每个特征对的角频率。)
在本节末尾,对于更习惯读代码的读者,上文介绍的 RoPE 运算过程也可以用代码表示如下:
import torch

query_head = torch.tensor([1., 2., 3., 4., 5., 6., 7., 8.])
key_head = query_head.clone()

# Split-half pairing gives (1, 5), (2, 6), (3, 7), and (4, 8).
query_pairs = torch.stack(query_head.chunk(2), dim=-1)
key_pairs = torch.stack(key_head.chunk(2), dim=-1)

# Take the first feature pair from each head.
q = query_pairs[0]
k = key_pairs[0]

m = 5  # Query position (in our example, "the")
n = 2  # Key position (in our example, the first "fox")
theta = torch.deg2rad(torch.tensor(20.0))  # Radians per token position


def rotate_pair(pair, angle):
    a, b = pair
    c, s = torch.cos(angle), torch.sin(angle)
    return torch.stack((a * c - b * s, a * s + b * c))


k_rot = rotate_pair(k, n * theta)  # 2 × 20° = 40°
q_rot = rotate_pair(q, m * theta)  # 5 × 20° = 100°

print(f"Original key:   ({k[0]:g}, {k[1]:g})")
print(f"Original query: ({q[0]:g}, {q[1]:g})")
print(f"Rotated key:    ({k_rot[0]:.3f}, {k_rot[1]:.3f})")
print(f"Rotated query:  ({q_rot[0]:.3f}, {q_rot[1]:.3f})")
计算结果为:
Original key:   (1, 5)
Original query: (1, 5)
Rotated key:    (-2.448, 4.473)
Rotated query:  (-5.098, 0.117)
如果我们对 8 维特征的 query(以及 key)向量中的全部 4 个特征对都进行旋转,就会得到以下向量。(稍后我们再回过头来看如何从旋转单对扩展到旋转全部对。)
Original key:   (1, 2, 3, 4, 5, 6, 7, 8)
Original query: (1, 2, 3, 4, 5, 6, 7, 8)
Rotated key:    (-2.448, 1.577, 2.951, 3.994, 4.473, 6.125, 7.021, 8.003)
Rotated query:  (-5.098, 0.928, 2.877, 3.986, 0.117, 6.256, 7.051, 8.007)
3.4 RoPE 中相对偏移如何改变注意力分数
注意,如上所示,query 和 key 头各有 8 个特征,前面我们将其两两配对成 4 个特征对,如 (1, 5)、(2, 6) 等。为简单起见,这里我们只关注每个头的第一对 (1, 5),它由索引为 0 和 4 的两个元素组成:
Original key:   (1, 5)
Original query: (1, 5)
Rotated key:    (-2.448, 4.473)
Rotated query:  (-5.098, 0.117)
如上所示,在我们的示例中,旋转前这两个元素在两个头中的值均为 (1, 5)。
同样,如上面的代码所示,我们用 q =(q1, q2) 和 k =(k1, k2) 来表示这两个特征对。计算它们的点积时,按照标准的点积公式,将对应分量相乘后再求和:

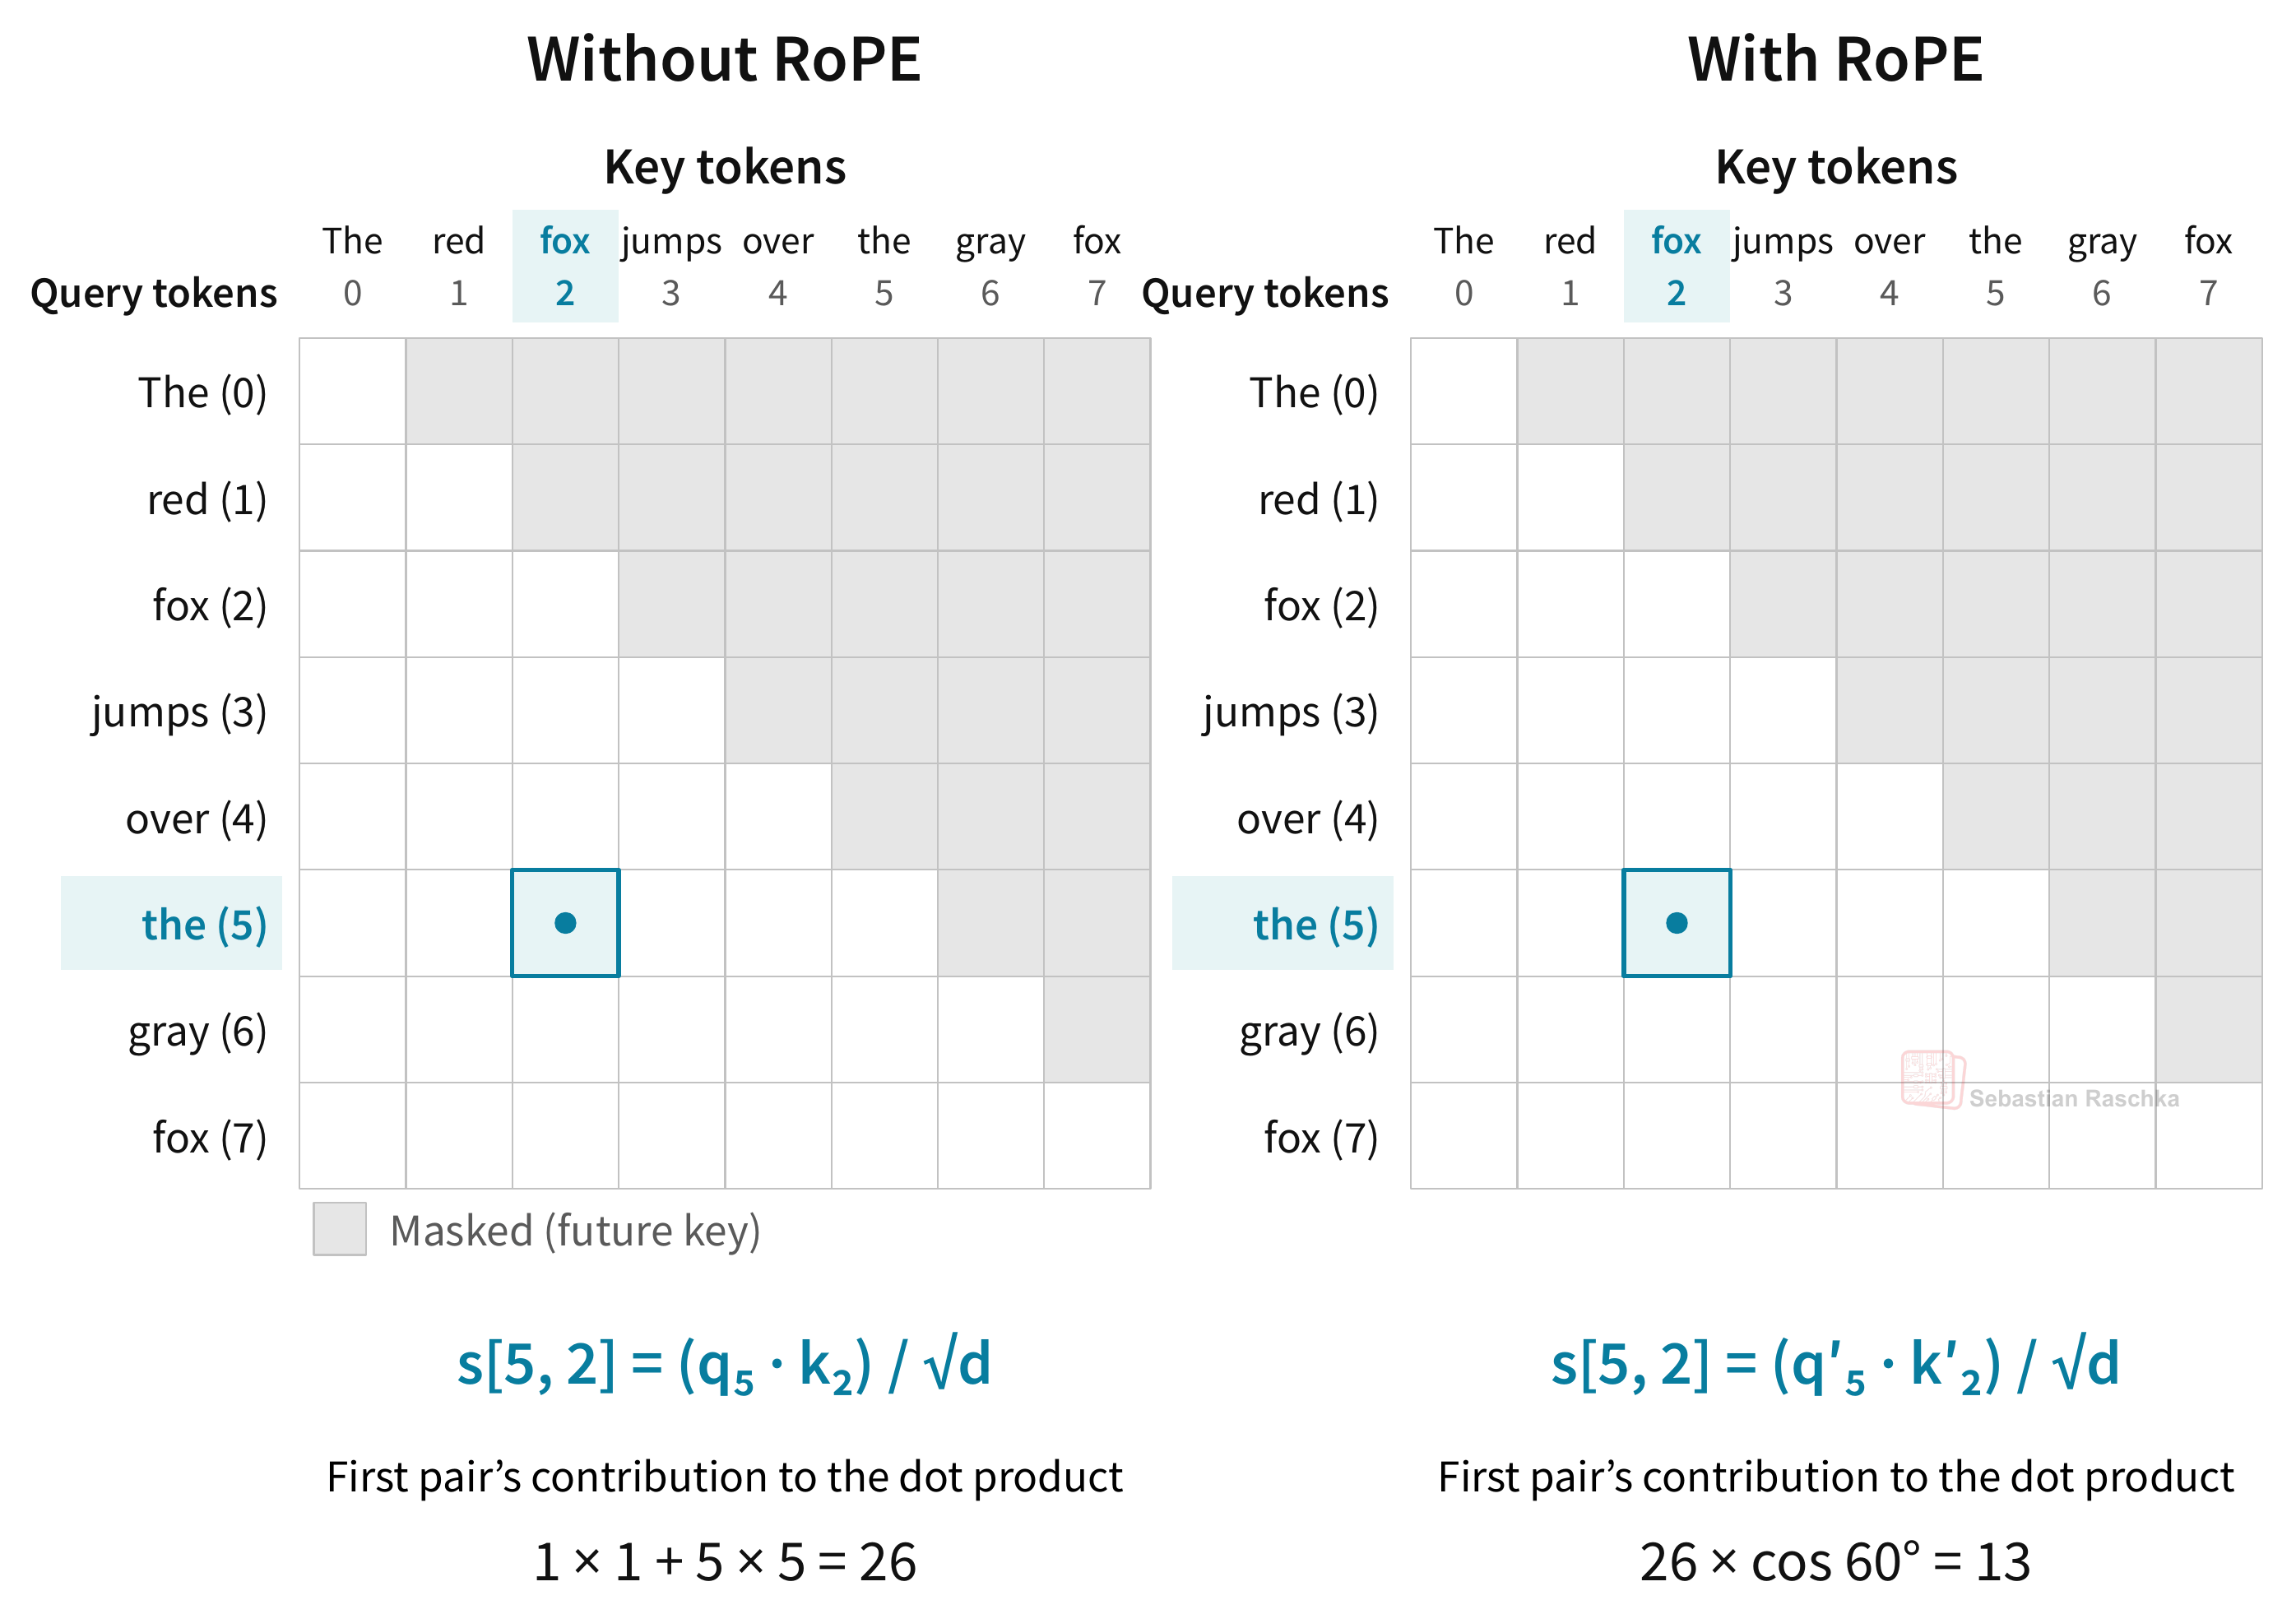
旋转前,特征对的点积为 1 × 1 + 5 × 5 = 26。利用前面图 18 中取整后的坐标,可以算出旋转后第一个特征对贡献的分数为:

我们可以用两个向量(图 18 中的箭头)的模长以及它们之间的夹角 ϕ 来展开点积,原因便一目了然。

在这两种情况下,向量的模长均为 √26。Query(位置 5)旋转了 100°,Key(位置 2)旋转了 40°。两个向量(箭头)初始方向相同,旋转后相差 60°。因此精确的点积为 26 × cos(60°) = 13。
现在我们来看看,如果只把 Key 从位置 2 移到位置 3,同时保持其初始坐标 (1, 5) 不变,会发生什么。Key 的旋转角度从 2 × 20° = 40° 变成了 3 × 20° = 60°。Query 仍旋转 100°,因此两个箭头之间的夹角缩小到 40°,点积也从 13 变为 26 × cos(40°) ≈ 19.92。可见,即便特征初始值完全相同,只要把 Key 挪近一个位置,点积就会改变。
为什么这些点积如此重要?在注意力机制中,我们将所有特征对的贡献求和来计算 Query-Key 点积。RoPE 会改变这些点积,进而影响 Softmax 分配给 Value 向量的权重。

在上面的注意力公式中,Q′ 和 K′ 是包含单头旋转后 Query q′ 和 Key k′ 的矩阵,V 包含 Value,d 则是头的维度。
3.5 为什么同时平移两个位置不会改变 RoPE 的注意力分数
前面我们演示了点积的计算过程,这也是注意力机制的核心。现在回到位置 m = 5 和 n = 2。如果把这两个位置同时向右平移 3 位,就得到 m = 8 和 n = 5。此时两者的旋转角度都增加了 60°(Query 从 100° 变为 160°,Key 从 40° 变为 100°),但向量之间的相对夹角保持不变。因此该特征对的点积依然是 13。
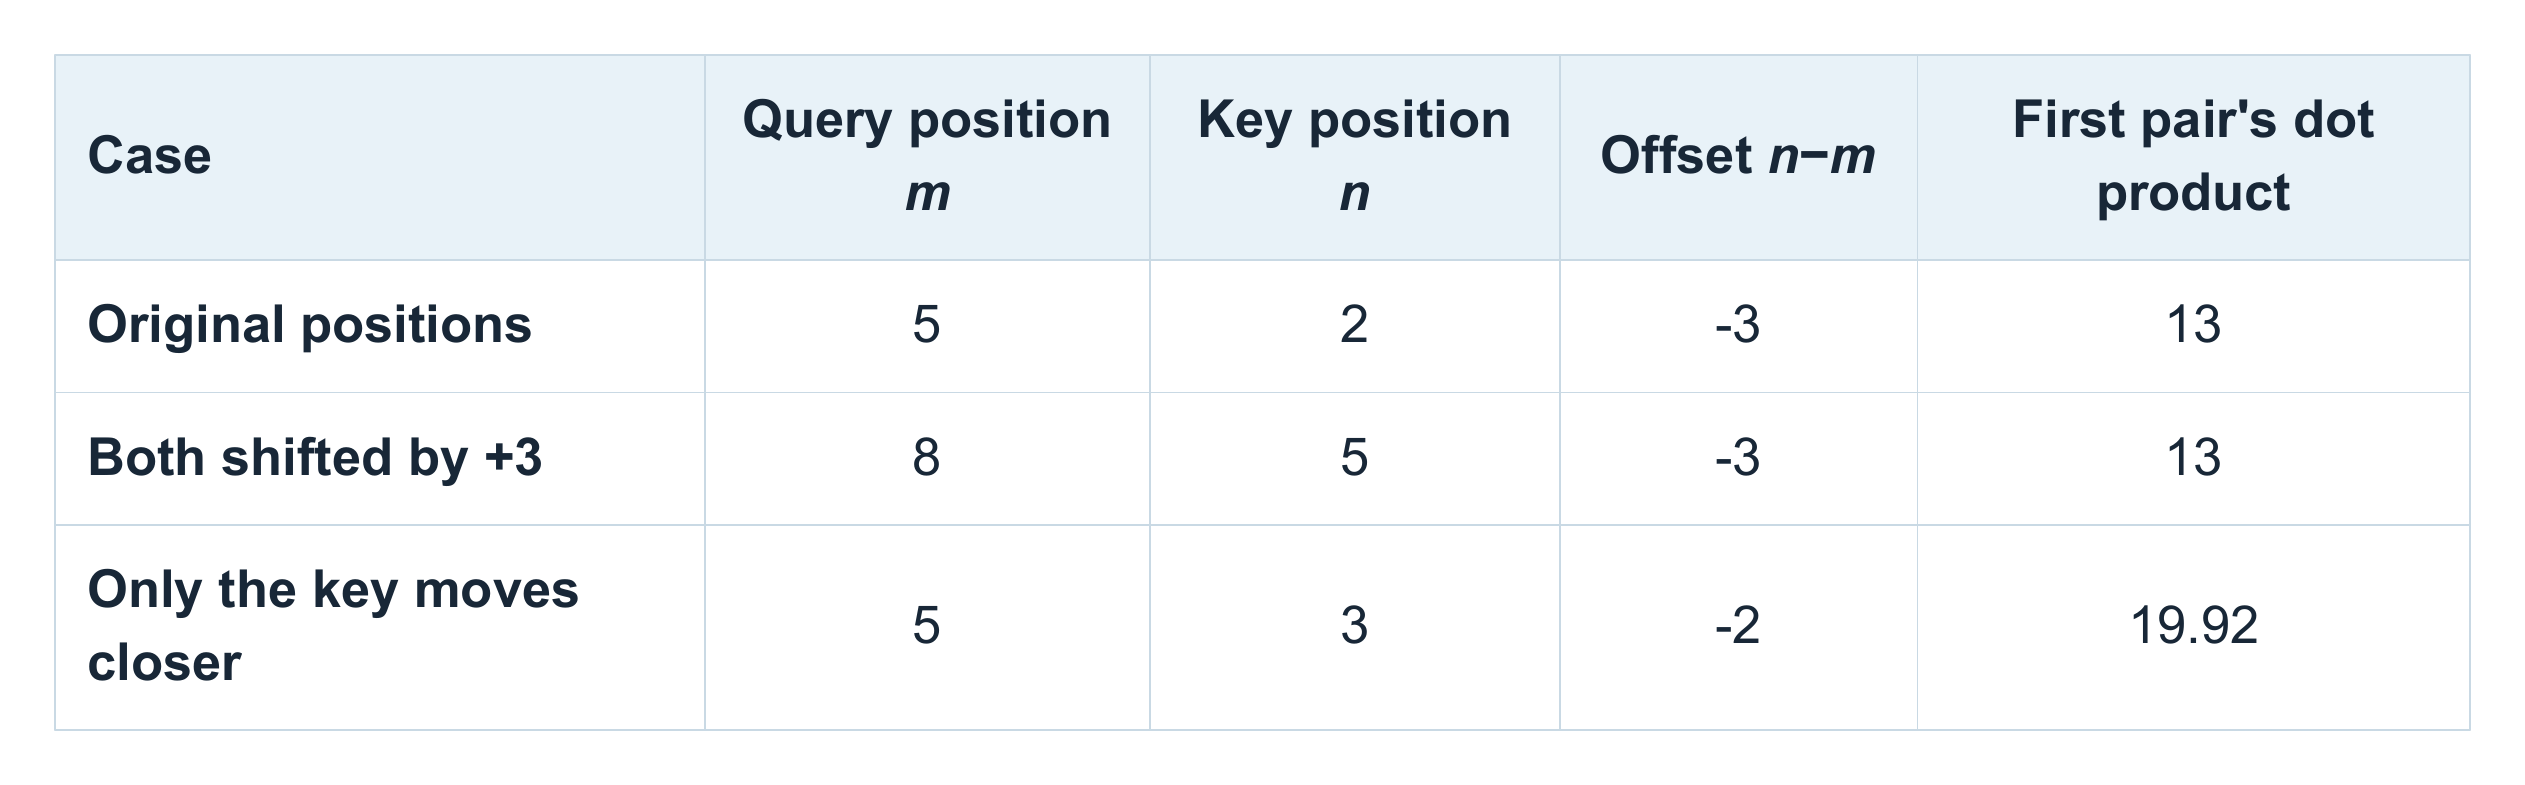
关键在于,旋转角度之差为

如果保持原始 Query 和 Key 向量不变,并将两个 token 的位置平移相同的量,RoPE 会对两个向量施加完全相同的旋转。两者之间的夹角保持不变,点积自然也不会改变。需要说明的是,为了让图解更清晰易读,下面的图 20 采用了比实际示例(每个位置 20°)更小的角度。
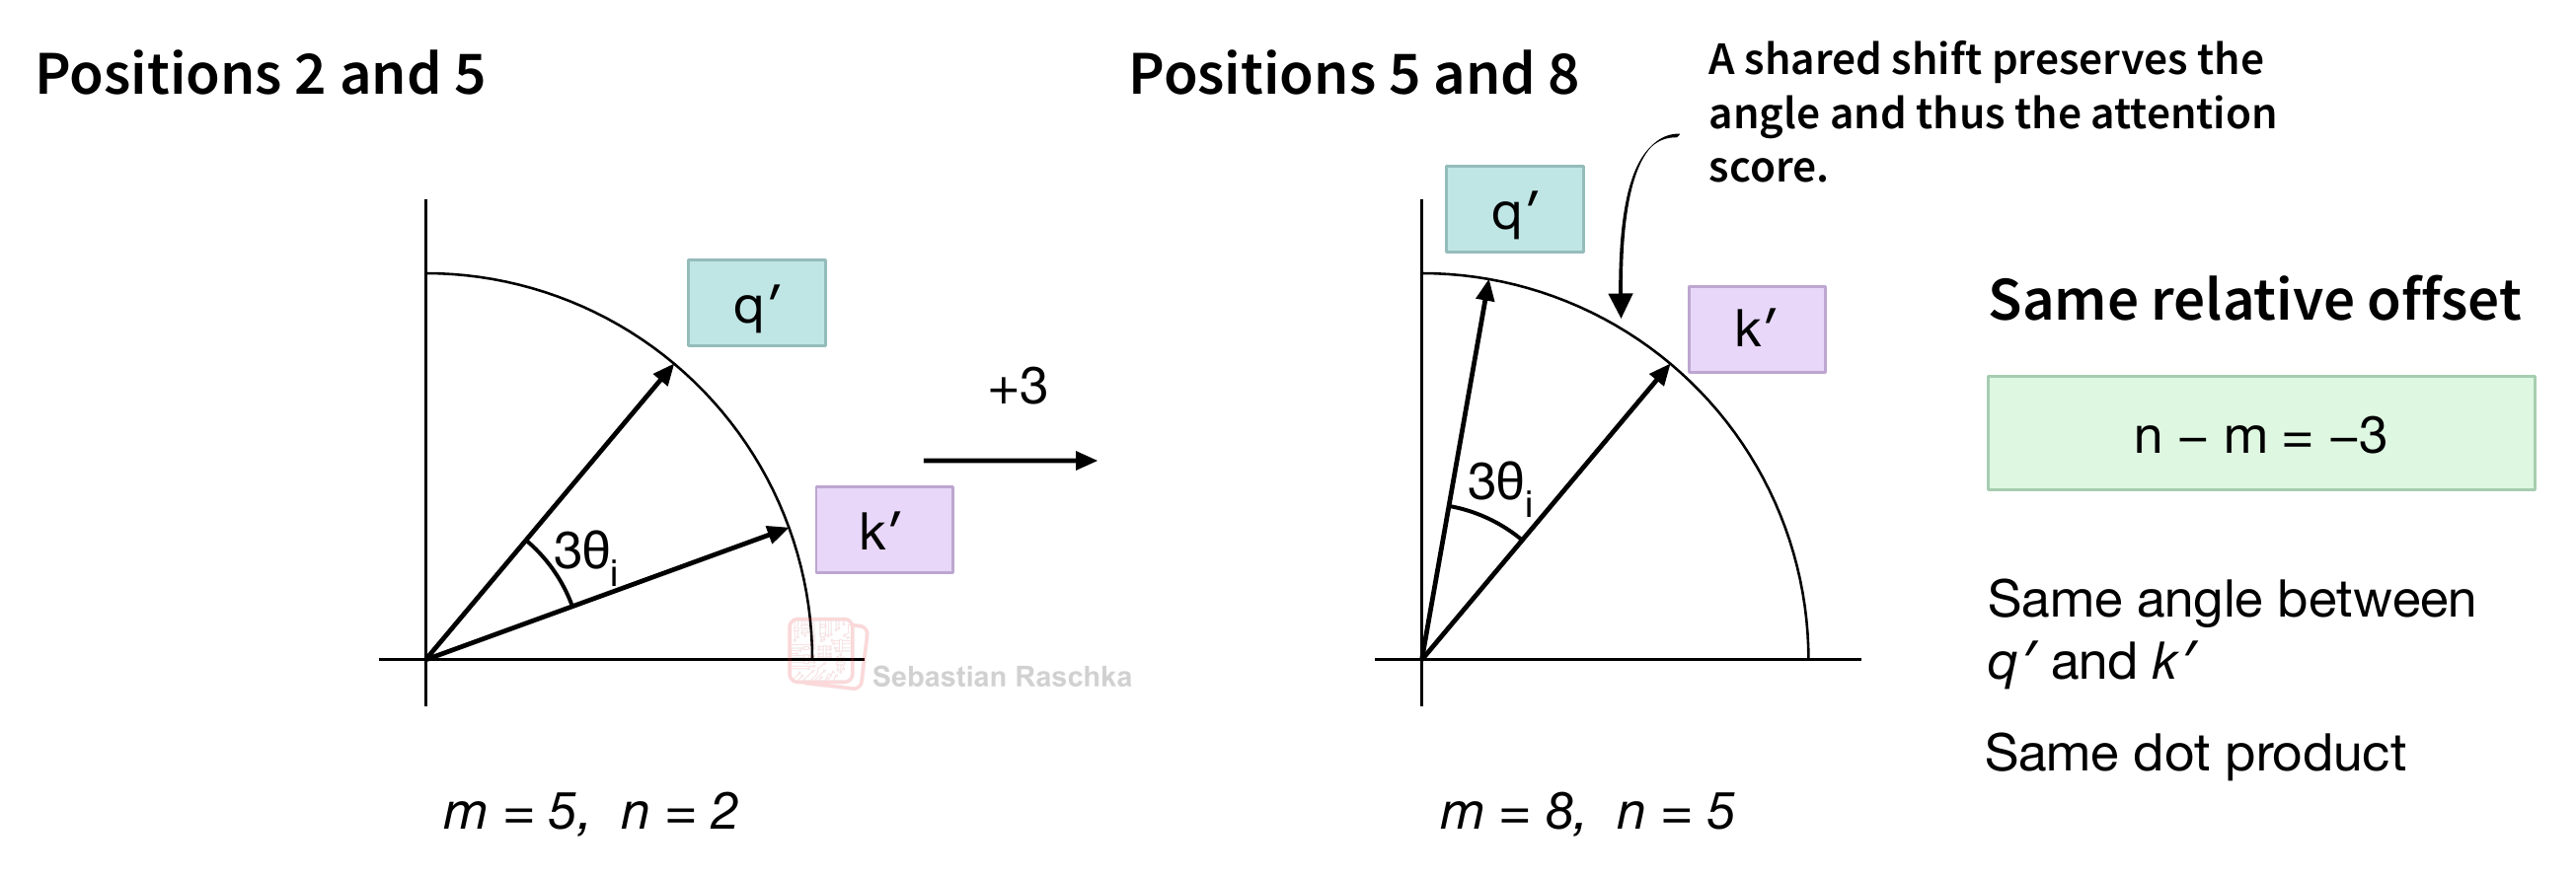
上述示例和图 20 展现了 RoPE 的核心思想:在注意力模块中,我们利用每个 token 的位置来旋转对应的 Query 和 Key;而在 Query-Key 的点积中,起决定作用的是两向量之间的相对旋转量;对于每个特征对,这一相对旋转量完全取决于两个 token 之间的相对位移。
从全局视角来看,图 21 中的每一行都汇总了一个 Query 的注意力分数。以第 5 行(“the”的 Query)和第 2 列(“fox”的 Key)为例,两者之间的注意力分数,就是 Query 和 Key 向量各自旋转后再计算的点积。
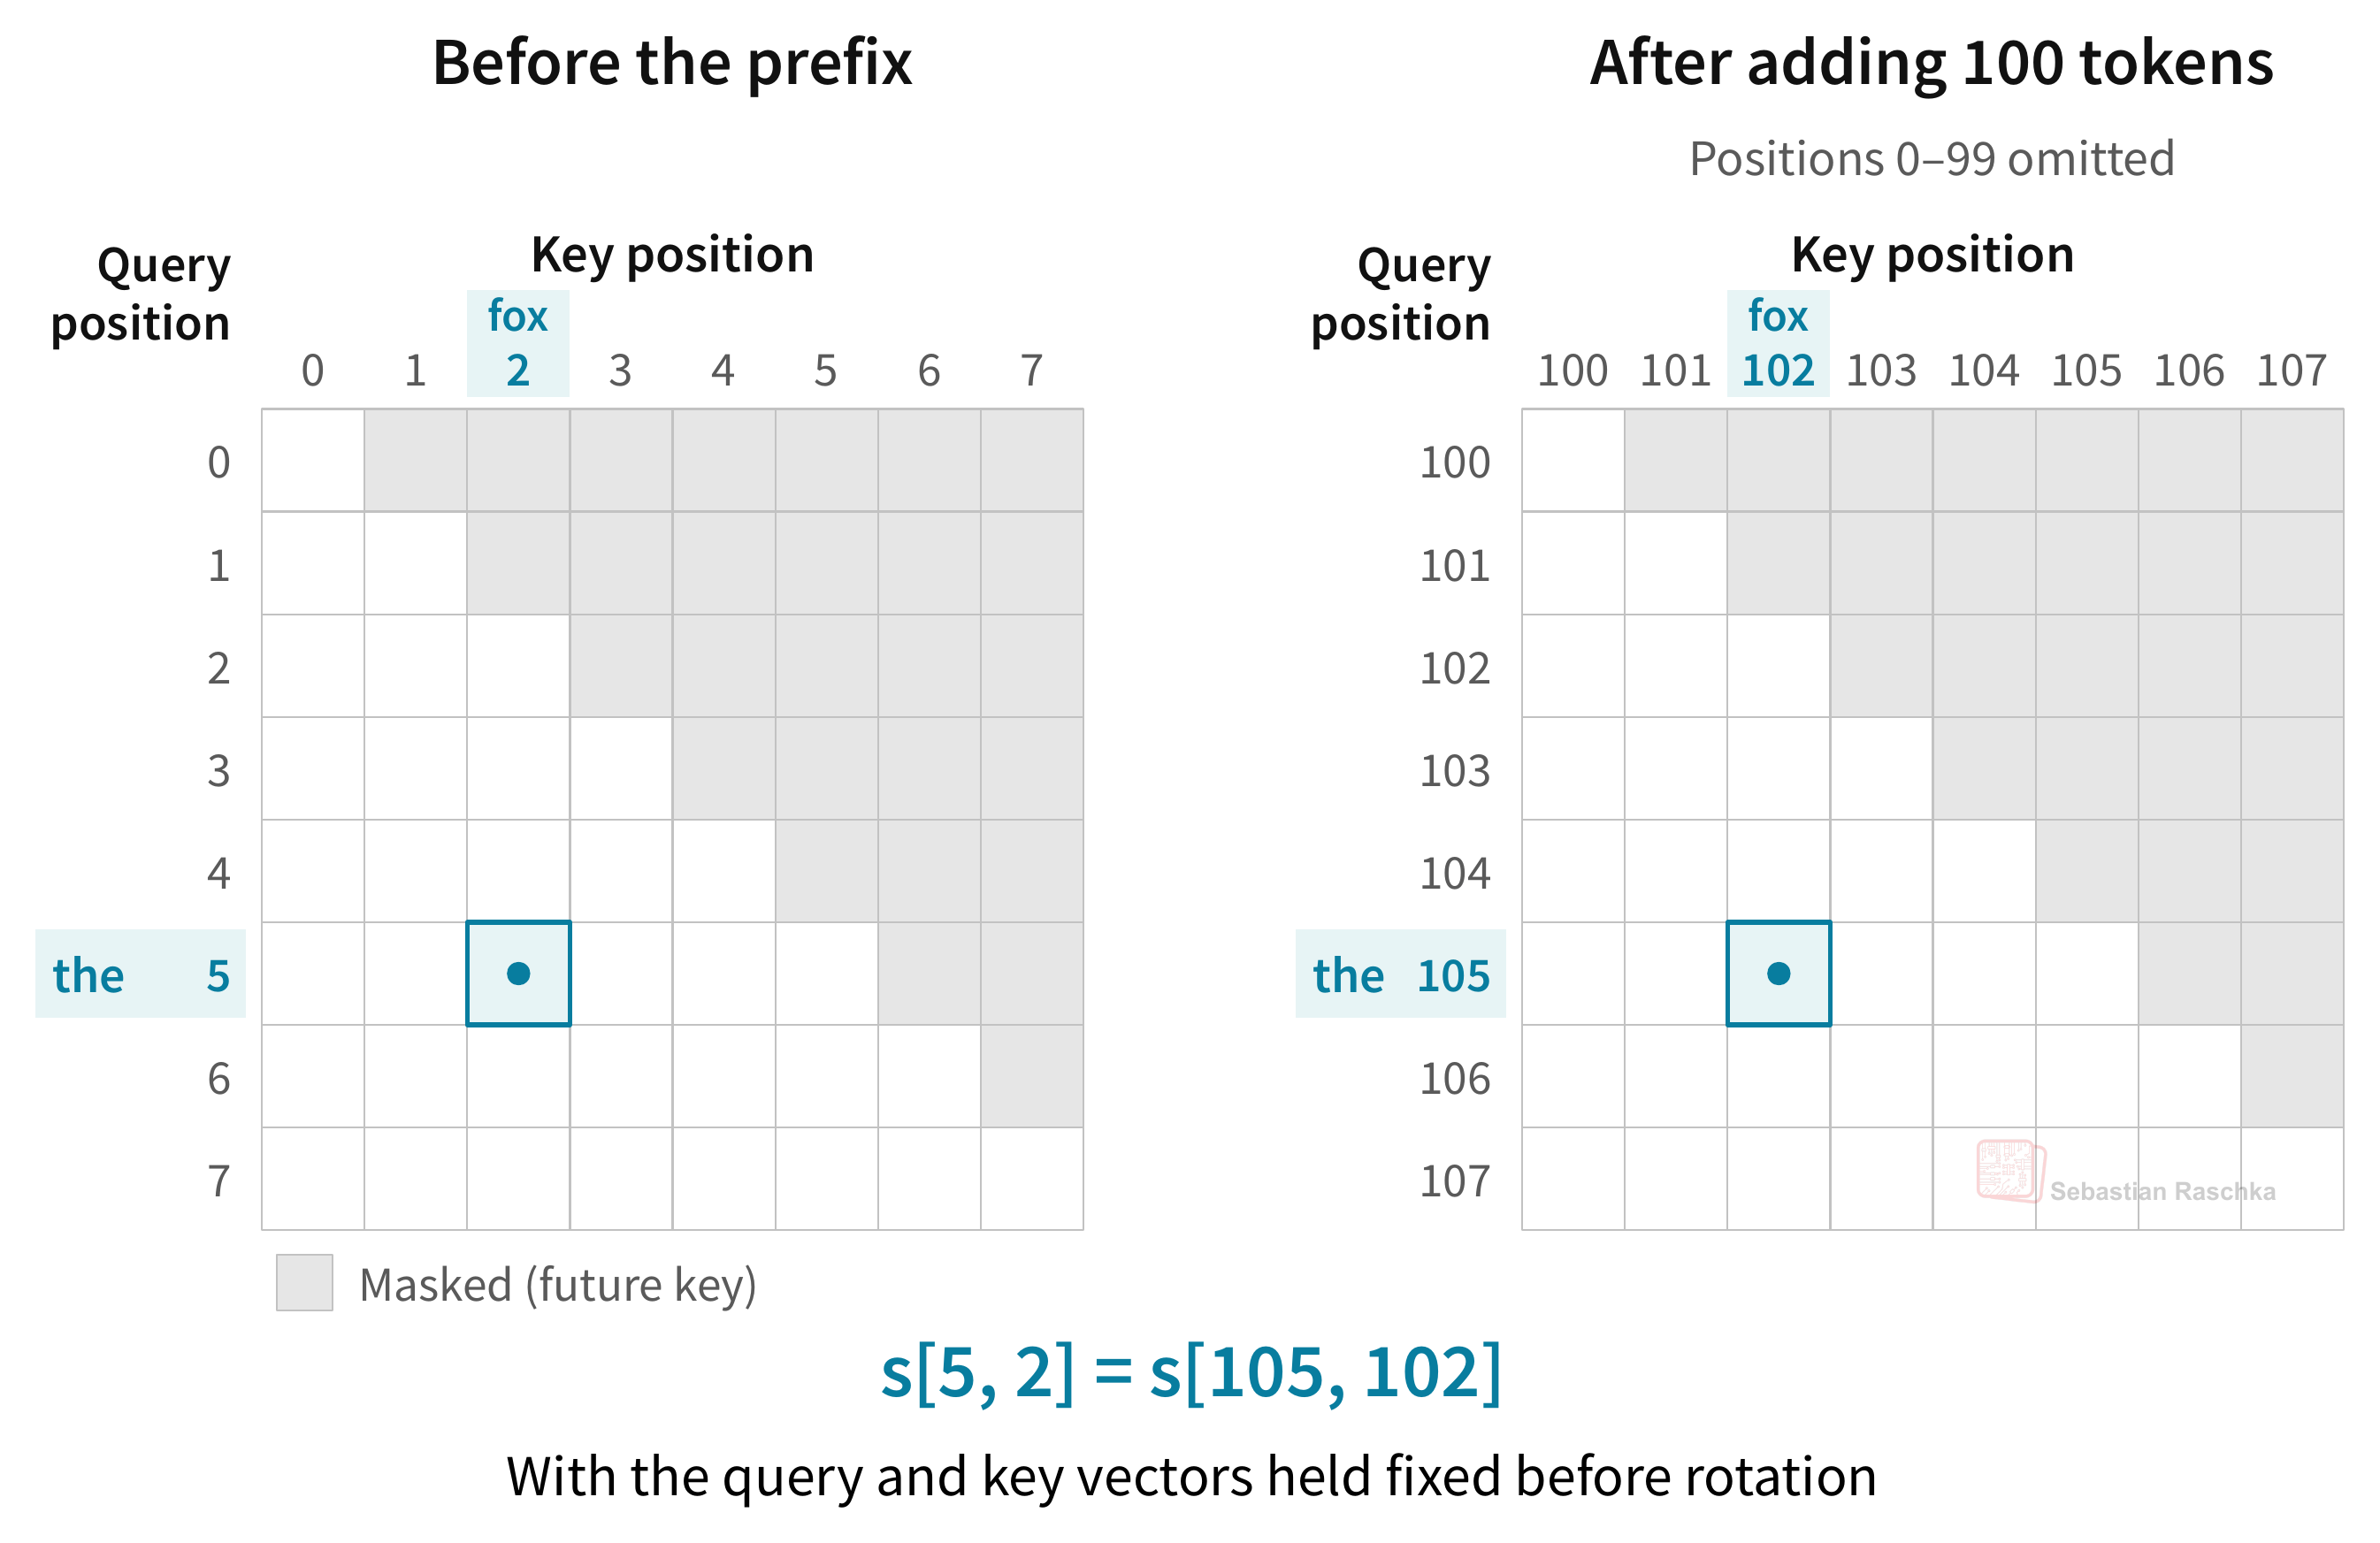
这样做到底有什么意义?我们再来看看“The red fox jumps over the gray fox”这句话。如果我们在句子前面加上 100 个 token(比如加入系统提示词),第一个“fox”和第二个“the”的位置就会分别从 2 和 5 变成 102 和 105。不过,无论前缀有多长,两个词的位置偏移量都是一样的,它们之间依然刚好相隔 3 个位置。这意味着,每个向量(箭头)获得的额外旋转角度完全相同,因此它们之间的夹角和点积都保持不变(这里假设未旋转的 query 和 key 向量保持不变;而在实际模型中,新增 100 个 token 的前缀会改变 token 关注的内容,进而改变这些向量)。
图 22 在注意力分数矩阵中展示了这种对比。右侧面板显示添加前缀后该句子对应的行和列。在这个简单示例中,第一对特征对点积的贡献依然是 13。
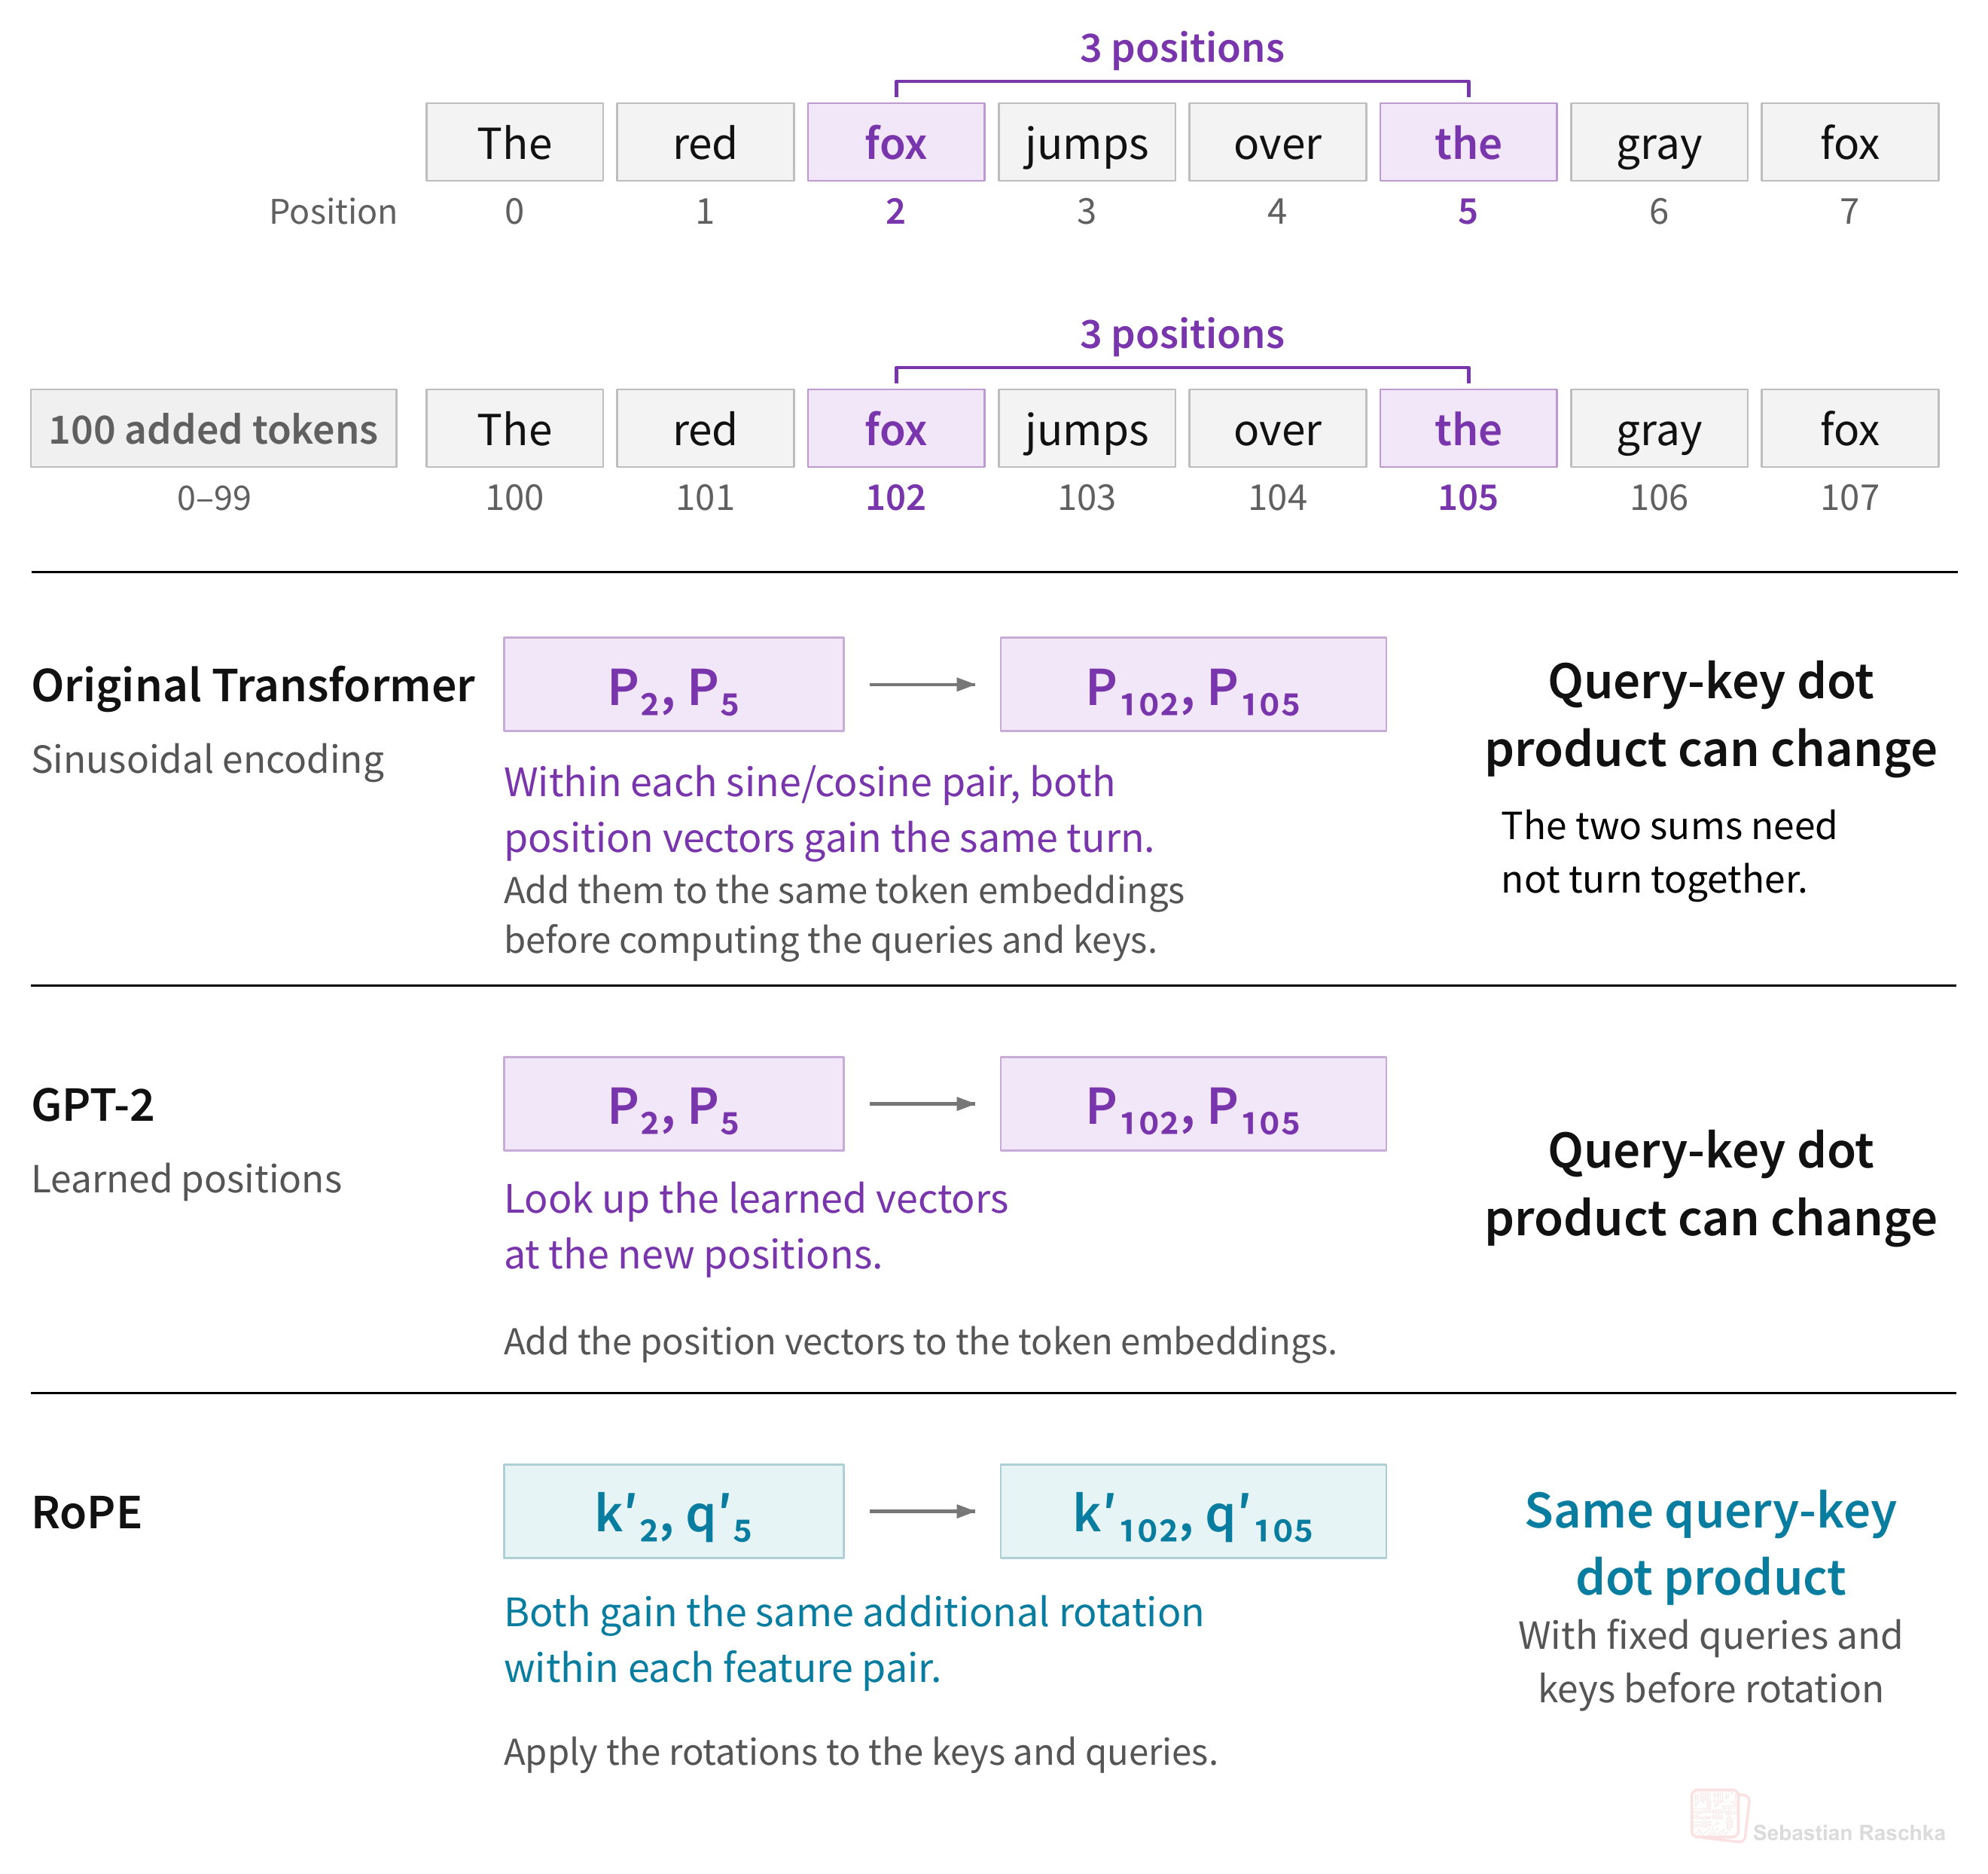
你可能还记得,在最初 Transformer 的正弦位置编码中,固定的偏移量也对应每对正弦/余弦分量内的固定旋转。但这种共同的旋转只作用于位置向量(与输入向量相加),并没有直接应用到注意力机制内部的 key 和 query 向量上。
图 23 对比了前面介绍的三种方法在这种位置偏移下的变化情况。
3.6 补充内容:在 RoPE 中将所有特征对整合成一个完整的头
为了说明相对偏移量如何影响点积,我们此前重点讨论了 query 和 key 中的单个特征对。现在,我们将全部 4 个特征对组合在一起,看看 RoPE 如何在单个注意力头中旋转完整的 8 维特征向量。(如果觉得技术细节过多,完全可以跳过本节。)
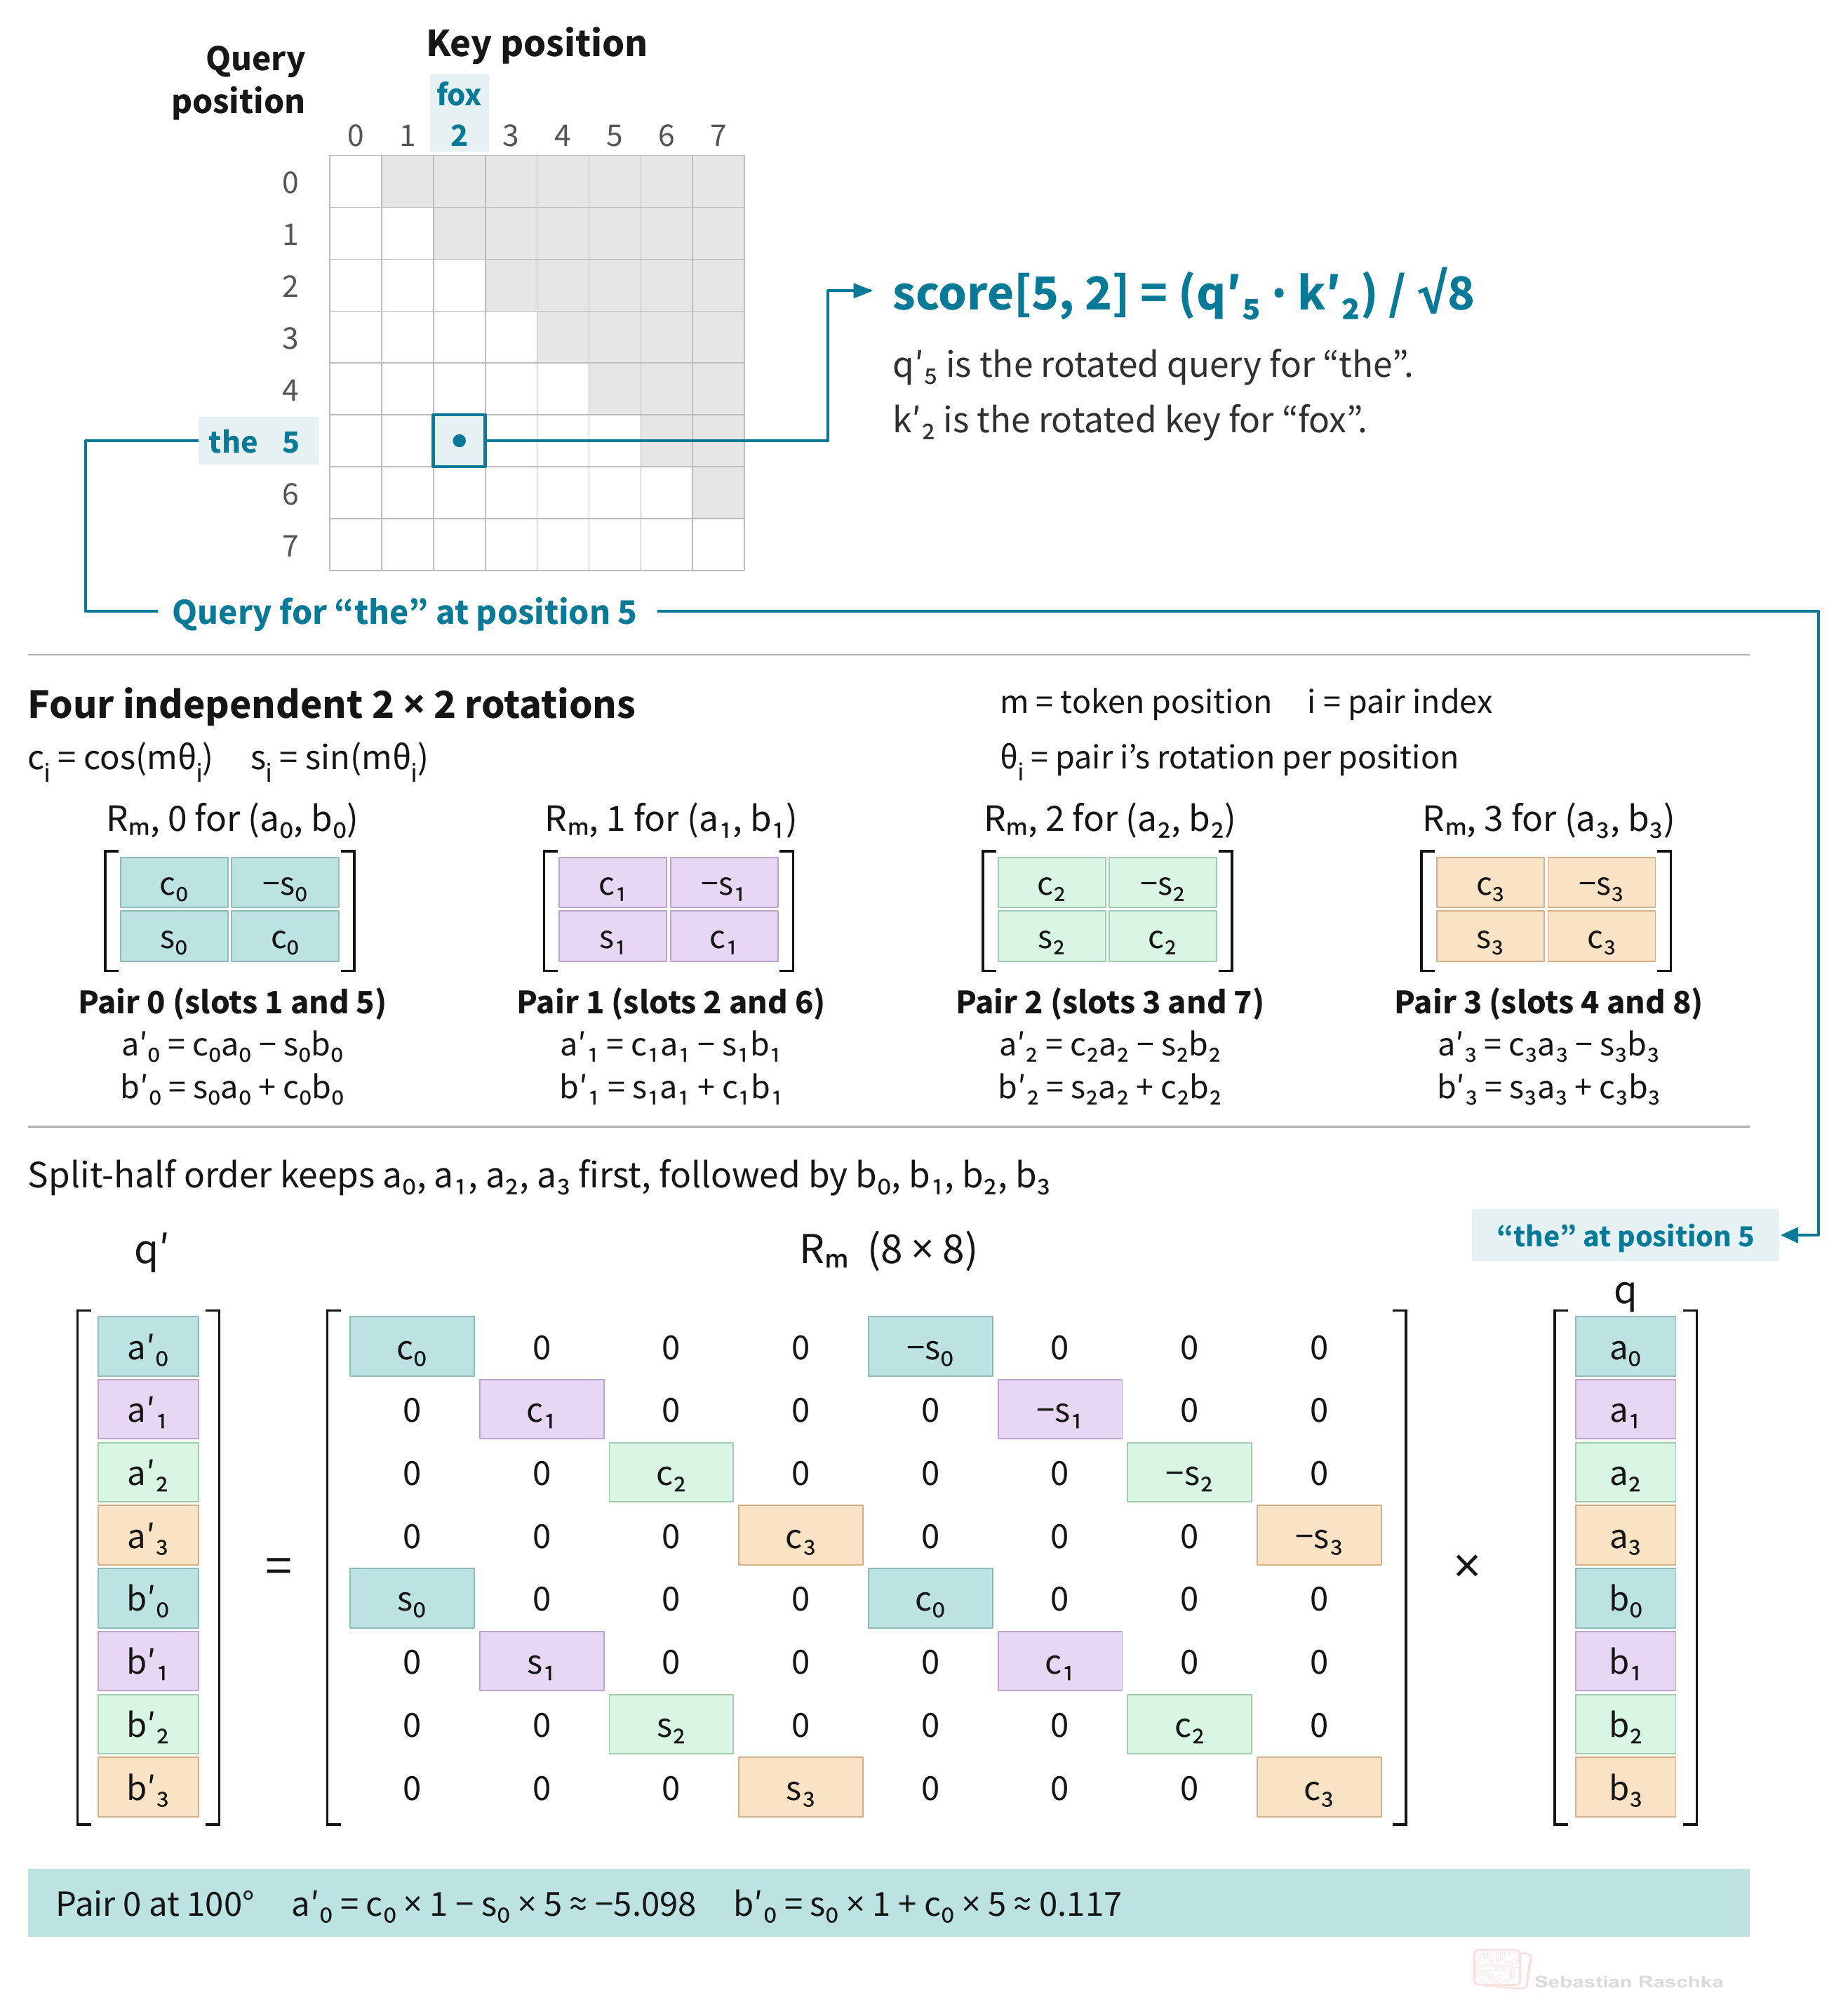
图 24 接续了图 17 的内容。我们分别对这 4 个特征对进行旋转,然后把结果按 query 原有的特征顺序重新排列。
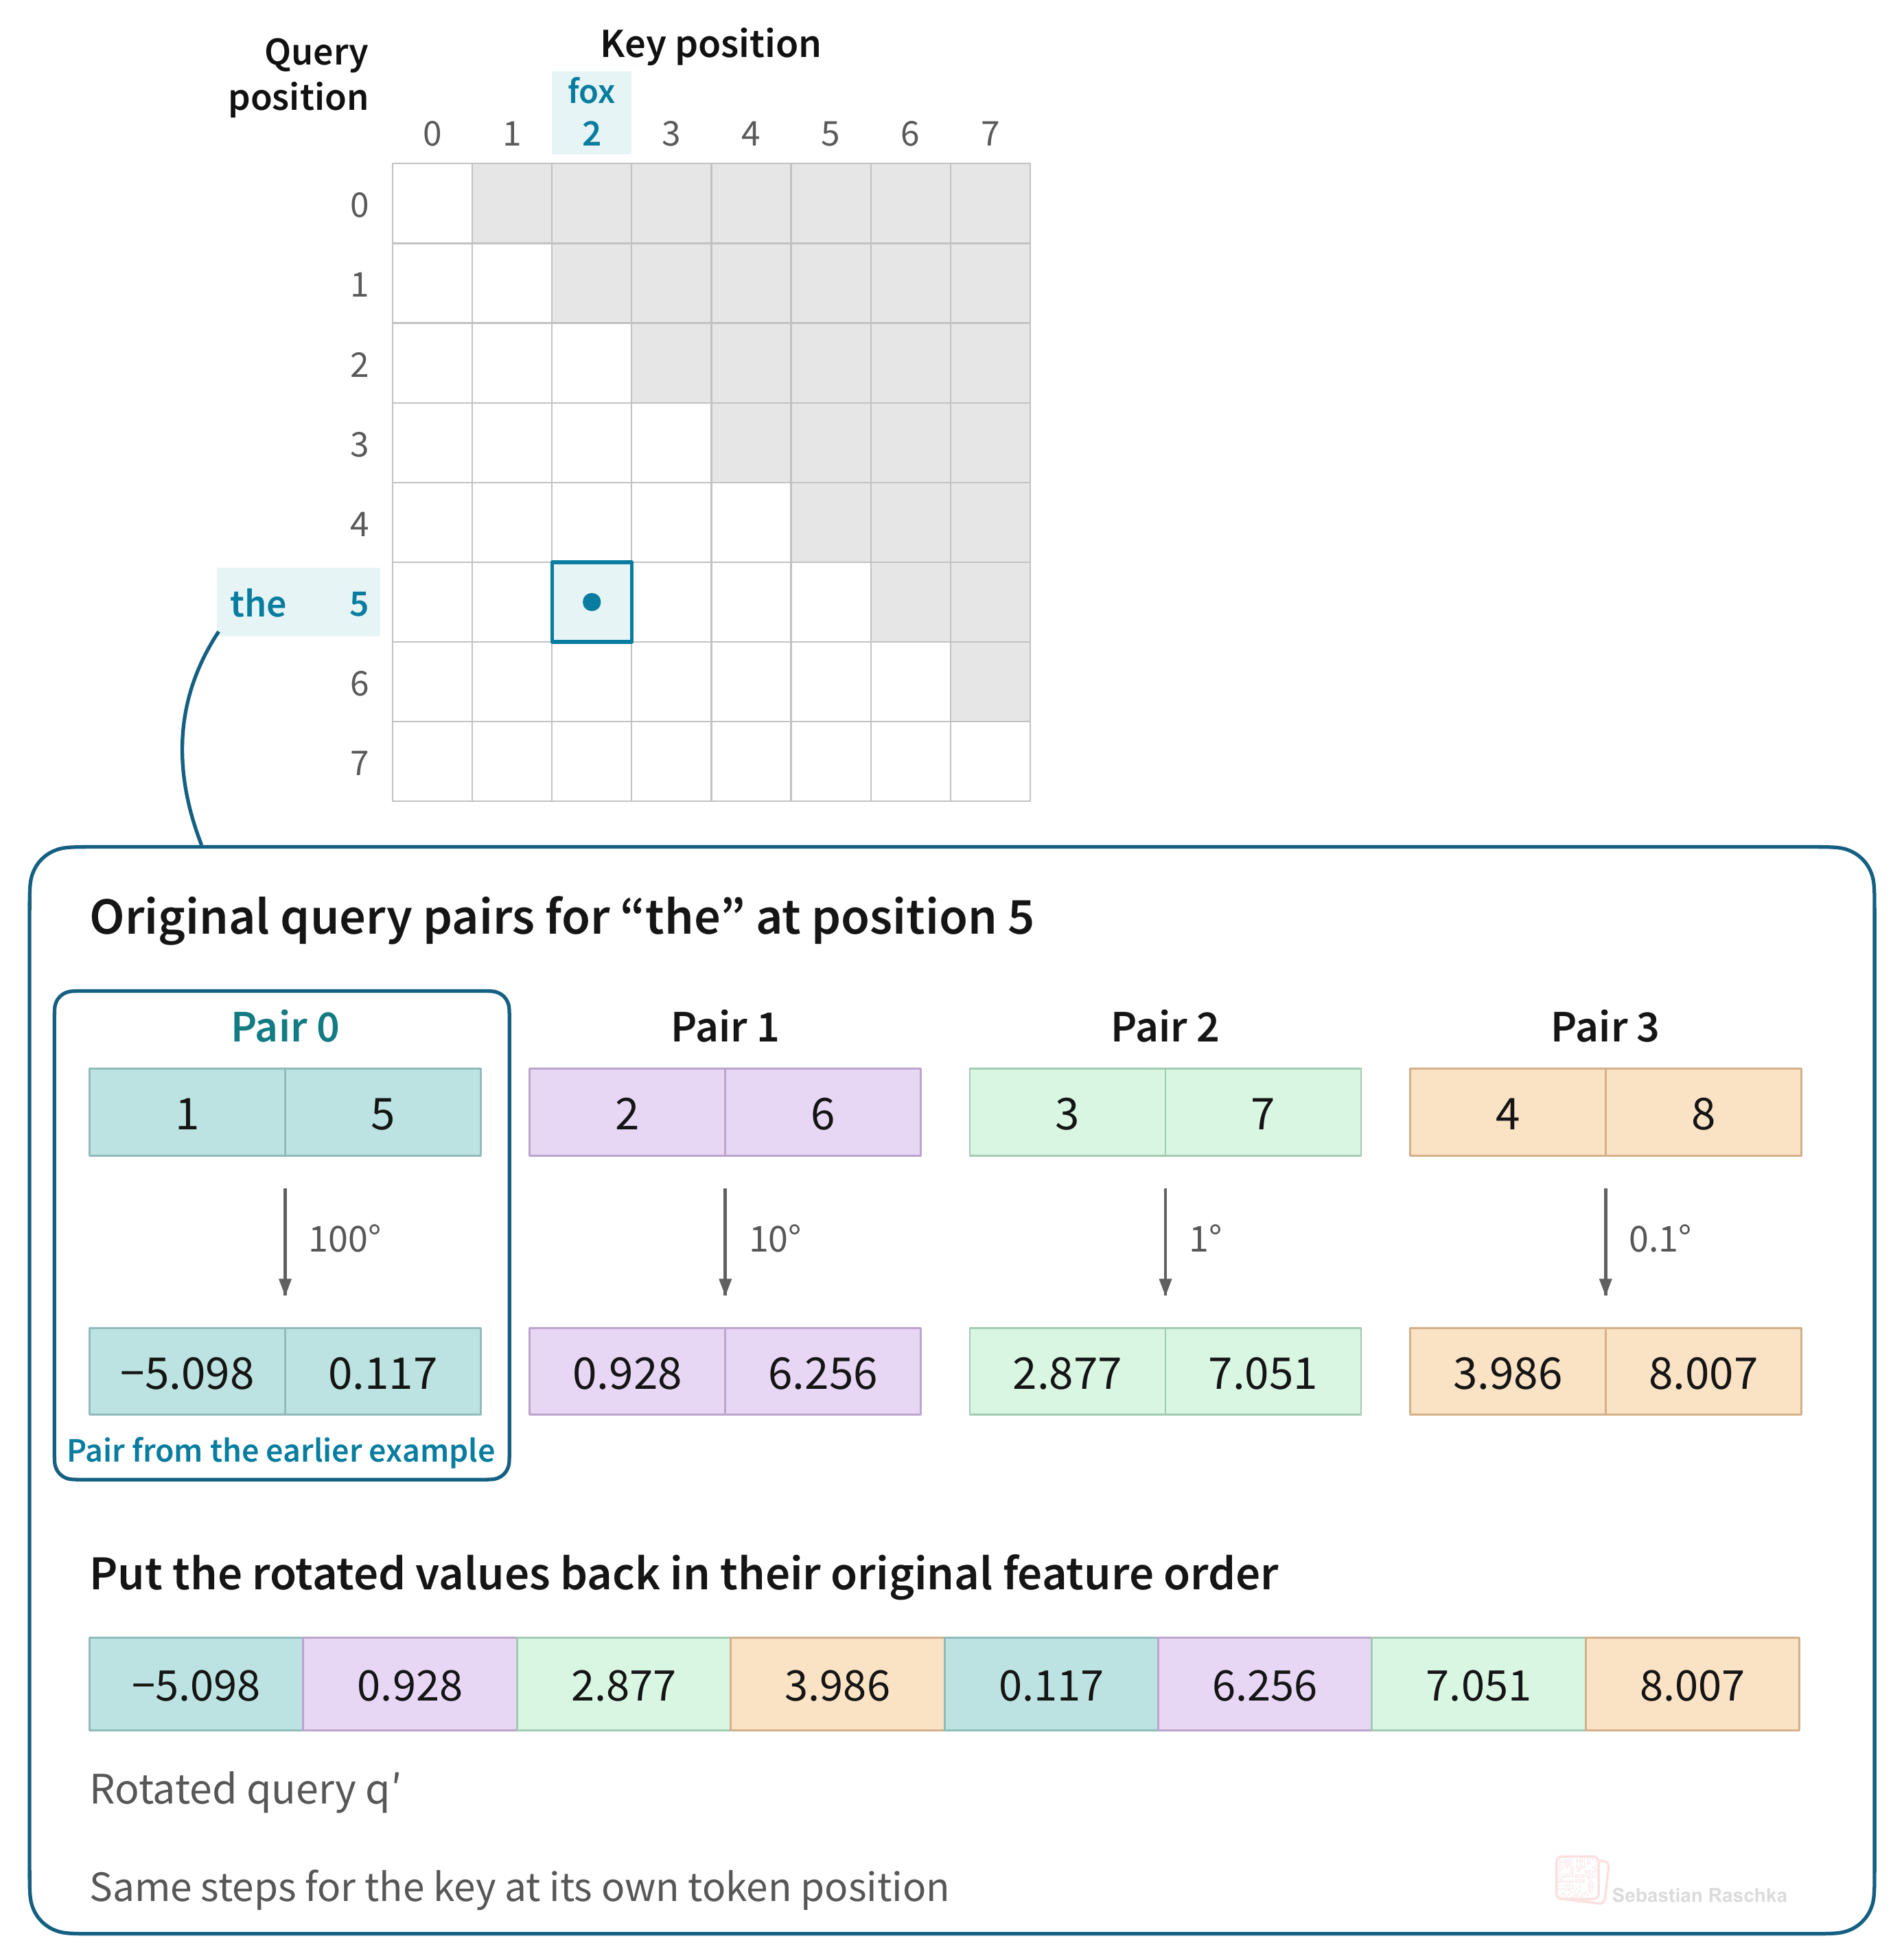
上面的图 24 展示了旋转后的 query q′ (底部)。同理,在 key 所在位置重复相同的步骤,就能得到旋转后的 key k′。
回顾一下 3.3 节的两个公式。对于输入值为 (ai, bi) 的第 i 个 query 特征对,令 ci = cos(mθi)、si = sin(mθi),它们分别是该特征对在 query 位置 m 处的旋转角的余弦值和正弦值:

下面的图 25 将这 4 个特征对的旋转操作整合表示为一个矩阵乘法:q′ = Rmq。
4. 如何计算 RoPE 中的旋转频率?
一个完整的注意力头会使用多种频率,这样某些特征对随着位置的变化会更加剧烈(在 RoPE 中称为“快速”变化),而另一些特征对的变化则更加平缓(在 RoPE 中称为“缓慢”变化)。这与最初 Transformer 正弦编码中采用多种频率的目的完全相同。
不过,我们并不需要手动指定这些数值。对于特征维度为 d 的注意力头,标准的完整 RoPE 会为其中的 d/2 个特征对分别计算频率,公式如下:

其中:
d 为注意力头的维度(必须是偶数,这样所有特征才能两两配对)。
i 为特征对的索引,取值范围为 0 到 d/2−1。
b 为选定的底数(超参数),用来控制频率的间隔。
θi 为第 i 个特征对的频率,单位为弧度/token 位置。
RoFormer 原论文中取 b = 10,000,沿用了初代 Transformer 的频率公式,只是把嵌入维度 dmodel 替换成了注意力头维度 d。
例如,当注意力头维度 d = 8 且底数 b = 10,000 时,计算出的频率分别为 [1, 0.1, 0.01, 0.001] 弧度/位置。
5. 彩蛋:用 PyTorch 实现 RoPE
如果你想在完整模型中观察 RoPE 的实际运作,推荐参考我从零开始构建的端到端 Qwen3 实现。
鉴于代码往往能更直观地帮大家理解概念,感兴趣的读者可以在接下来的小节中,跟着代码一起梳理前面讲过的核心内容。如果你想跳过,也可以直接翻到第 6 节:现代架构中的位置编码选型。
在接下来的代码片段中,我们采用前面提到过的对半拆分(split-half)旋转约定(不用担心,交错排列的方式后面也会讲到)。我们会先将其应用到单个 query 向量上,随后再用到注意力机制内部的 query 和 key 上。
5.1 计算并应用旋转变换
首先,我们继续沿用图 24 中那个具有 8 个特征的 query 向量。为了方便查看,下图展示了旋转前的 4 个特征对。

在之前不涉及代码的示例中,为了简化计算,我们把第一个特征对的频率设为了每 token 位置 20°。这里我们改用上面第 4 节中 RoPE 的原生公式 θi = b−2i/d,设定注意力头维度 d = 8,底数 b = 10,000。
图 26 展示了这两个函数如何协同工作来完成旋转变换。
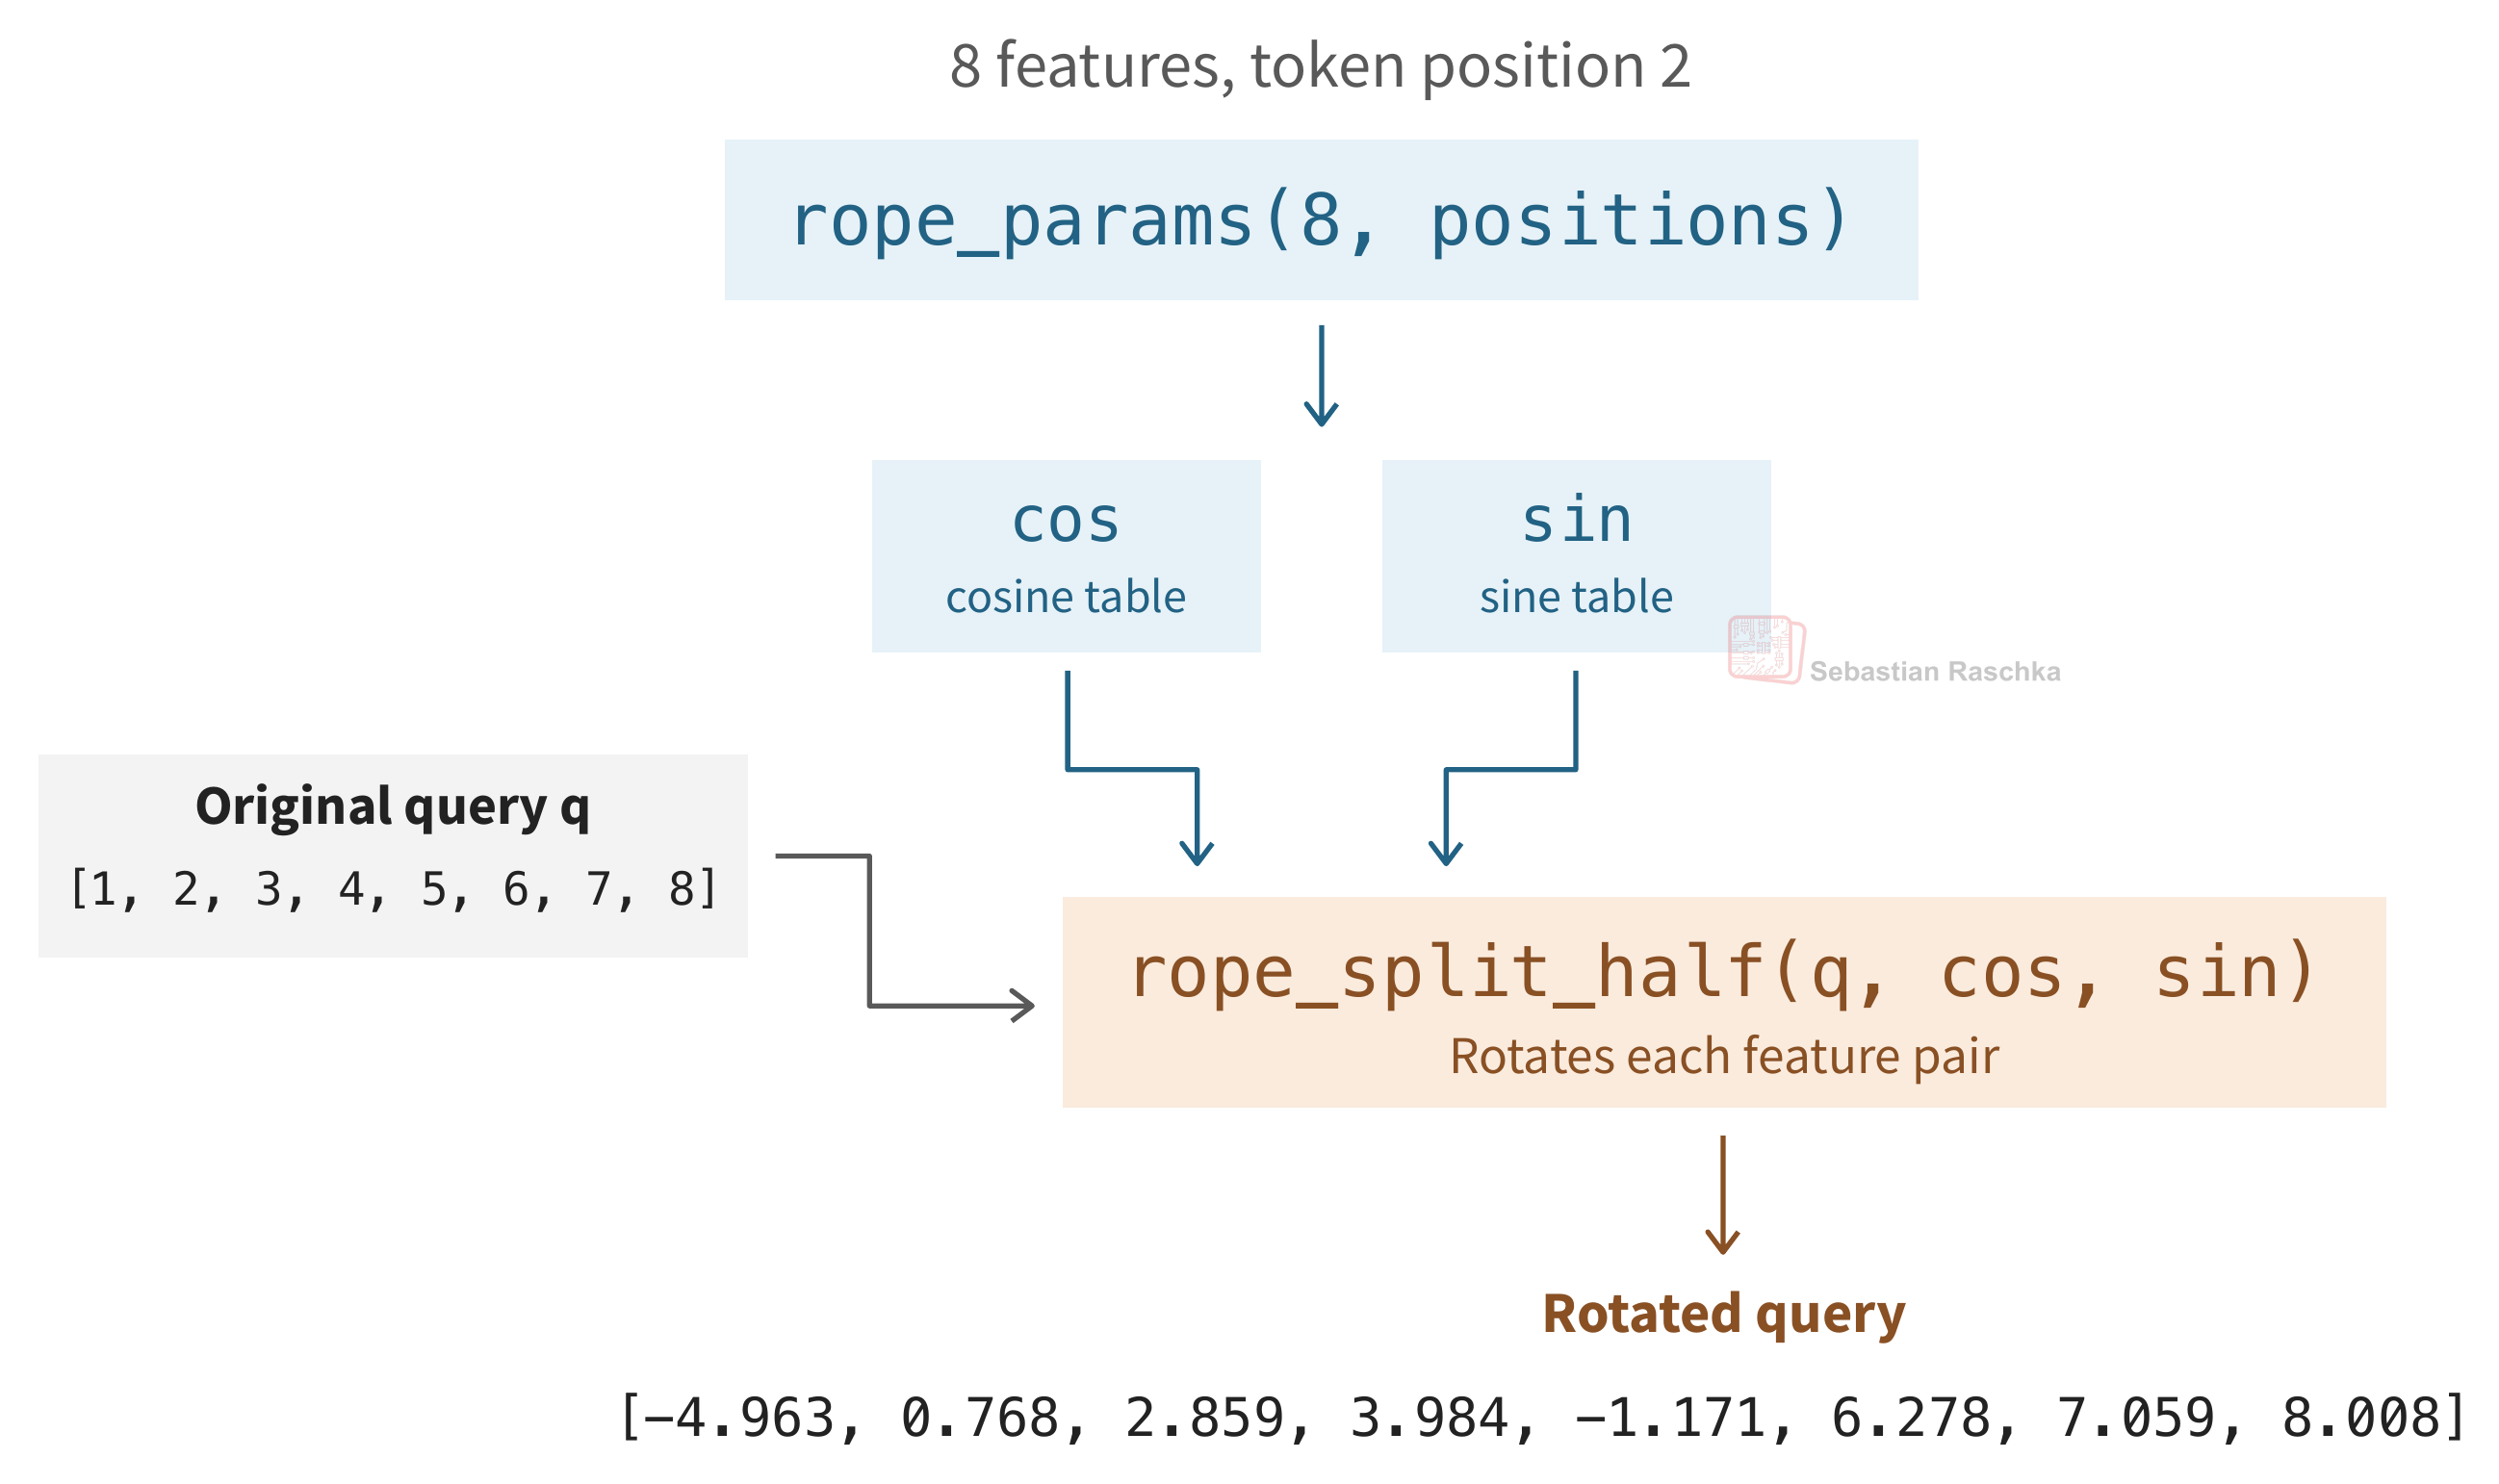
如上图所示,首先由 rope_params 计算出每个特征对需要旋转的角度,并返回两张分别存储这些角度余弦值和正弦值的“表”。换言之,rope_params 计算出的每个旋转角度的余弦和正弦值,取决于该 token 所处的位置以及对应特征对的频率。
import torch

def rope_params(head_dim, positions, base=10_000):
    assert head_dim % 2 == 0
    indices = torch.arange(0, head_dim, 2, device=positions.device)
    inv_freq = base ** (-indices.float() / head_dim)
    angles = positions.float()[:, None] * inv_freq[None, :]
    return angles.cos(), angles.sin()
在 rope_params 函数中,indices 数组存放着第 4 节频率公式里的 2i 取值:
对于我们这个 8 特征的 query 来说,indices的值为 [0, 2, 4, 6],也就是每个特征对对应一个 2i 值。假设采用常用的底数 b = 10,000,并沿用之前的示例设置较小的注意力头维度 d = 8,此时 inv_freq 就会按下式计算出 4 个特征对各自的频率 θi = b−2i/d:

正如上文所示,生成的 inv_freq 在每个 token 位置都为 4 个特征对各提供了一个频率 θi(以弧度为单位)。
接下来,angles 会将每个特征对的频率 θi 与 token 位置 m 相乘,从而计算出旋转角度 mθi。在本例中,取 positions = [2],可得:

最后,rope_params 分别计算每个角度的余弦和正弦值,并输出两张所谓的余弦表和正弦表:cos 与 sin。在这两张表中,每一行代表一个 token 位置,每一列代表一个特征对。由于这里我们只用到了 token 位置 2,因此每个表的形状都是 (1, 4),仅包含如下所示的这一行:

以图 26 的例子来说,每个表都有一行(对应 token 位置 2)和四列(各对应一个特征对)。图 27 展示了每个特征对的旋转角度,以及两张表中对应的数值项。

简而言之,rope_params 计算出各个旋转角度的余弦和正弦值,而该角度取决于 token 的位置和对应特征对的频率。
在实际应用中,如果针对 1024 的上下文大小传入 1,024 个 token 位置,且注意力头维度为 128,rope_params 会返回两个张量 cos 和 sin;因为 128 维特征对应 64 个特征对,所以两者的形状都是 (1024, 64)。
这些表不包含批次或头维度,我们会把每个 (1024, 64) 表广播到批次和头维度上。因此,如果采用 32 个头的多头注意力或分组查询注意力,token 位置 2 上的特征对 0 在所有 32 个头中都会使用相同的旋转角度。每个头旋转各自的特征值,因此旋转后的 query 在不同头之间依然不同。此外,只要位置和频率相同,这些表项就可以在 query、key 以及各个头之间复用。简而言之,每个模型只需针对最大支持上下文长度内的所有位置,将这些表预计算一次即可。
从技术上讲,也可以把这些表随模型权重一起保存;但它们的计算开销极低,专门存到磁盘上反而多此一举。
接下来,rope_split_half 会利用这些余弦和正弦值,在注意力机制内部对 query 和 key 向量中的实际特征进行旋转。
def rope_split_half(x, cos, sin):
    first, second = x.float().chunk(2, dim=-1)
    return torch.cat((
        first * cos - second * sin,
        first * sin + second * cos,
    ), dim=-1).to(x.dtype)
我们再次回顾那个简单的 8 特征示例:上面代码片段中的 .chunk 将 query 拆分为 [1, 2, 3, 4] 和 [5, 6, 7, 8],并让每个特征对的两个元素一一对应。例如,两半部分的首个位置组合成了 (1, 5),第二个位置组合成了 (2, 6),依此类推。torch.cat 中的两个表达式则利用 3.3 节的公式计算旋转后的两半部分:

注意,这里所有用 ai 表示的值都对应 query 的前半部分,用 bi 表示的值则都来自后半部分。torch.cat 中的第一个表达式负责计算所有 ai′ 的值,第二个表达式负责计算所有 bi′ 的值。
随后将这两半部分拼接起来,通过 torch.cat 让每个值回到原本的索引位置。
以下代码可生成前面图 26 中旋转后的 query。代码中的 reshape (1, 1, 1, 8) 只是将这个简单的示例数组调整为预期格式:批大小为 1、1 个头、1 个 token 以及 8 个特征。
positions = torch.tensor([2])
cos, sin = rope_params(8, positions)

q = torch.arange(1., 9.).reshape(1, 1, 1, 8)
q_rot = rope_split_half(q, cos, sin)
print(q_rot[0, 0, 0])
包含多个位置时,每个 token 只需从 cos 和 sin 表中取出对应的行即可。借助广播机制,PyTorch 可以在所有批次样本和注意力头之间复用这两张表。
5.2 在因果注意力中使用 RoPE
到目前为止,我们已经写好了 RoPE 的工具函数。现在,我们把它们放到实际的注意力机制中跑一下。这里我们设定了 4 个 token 位置和 2 个维度为 8 的注意力头,并采用标准的频率规划。为了让示例自包含,这里使用了随机生成的 Query、Key 和 Value 张量;不过正如前面提到的,你也可以参考完整的从零实现 Qwen3 代码,里面使用的是预训练模型生成的真实 Query、Key 和 Value。
torch.manual_seed(123)

q = torch.randn(1, 2, 4, 8) # 1 batch, 2 heads, 4 tokens, 8 head dim
k = torch.randn(1, 2, 4, 8)
v = torch.randn(1, 2, 4, 8)
positions = torch.arange(4)

cos, sin = rope_params(8, positions)
q_rot = rope_split_half(q, cos, sin)
k_rot = rope_split_half(k, cos, sin)
scores = q_rot @ k_rot.transpose(-2, -1) / q.shape[-1] ** 0.5

future_mask = positions[None, :] > positions[:, None]
masked_scores = scores.masked_fill(future_mask, -torch.inf)
weights = torch.softmax(masked_scores, dim=-1)
context = weights @ v
注意,只有 q 和 k 会经过 RoPE,v 则不需要。计算得到的原始注意力分数保存在形状为 (1, 2, 4, 4) 的张量中,即每一行对应一个 Query 位置,每一列对应一个 Key 位置;因为共有 4 个互相计算注意力的 token,所以矩阵大小是 4x4。
随后,按照常规的注意力代码实现,因果掩码(causal mask)会将未来 Key 的注意力分数替换为负无穷,经 Softmax 后权重归零。最终得到的 context 张量形状为 (1, 2, 4, 8);其中 4 代表 4 个 token,8 则因为最初的嵌入维度就是 8。
我们还可以验证一下关于相对偏移的结论是否成立:给每个位置都加上 3,位置虽然变了,但 Query 和 Key 之间的相对偏移量应当保持不变:
cos_shifted, sin_shifted = rope_params(8, positions + 3)
q_shifted = rope_split_half(q, cos_shifted, sin_shifted)
k_shifted = rope_split_half(k, cos_shifted, sin_shifted)
scores_shifted = (
    q_shifted @ k_shifted.transpose(-2, -1) / q.shape[-1] ** 0.5
)
torch.testing.assert_close(scores, scores_shifted)
# Should return True
5.3 另一种特征配对方式
本文多次提到了对半分(split-halves)的方式。而 RoPE 原论文以及 LLaMA 最初的实现采用的则是另一种交错式(interleaved)配对方式(不过正如前文所述,现在大部分代码实现都采用对半分,因为在代码中通过逐元素的正弦和余弦运算,能更方便地一次性旋转所有配对)。
为了说明这两种排布的区别,下图 28 在两行中展示了同一个 8 维特征向量的对应方式。

交错式的实现使用的是相同的两套公式,只不过选取的是交替出现的特征,并对输出进行交错排列。
def rope_interleaved(x, cos, sin):
    even, odd = x.float()[..., 0::2], x.float()[..., 1::2]
    return torch.stack((
        even * cos - odd * sin,
        even * sin + odd * cos,
    ), dim=-1).flatten(-2).to(x.dtype)
但从数学上看,只要考虑特征顺序,这两种排布是等价的。将元素从 [1, 2, 3, 4, 5, 6, 7, 8] 重排为 [1, 5, 2, 6, 3, 7, 4, 8],就能让对半分的配对(1, 5)、(2, 6)等相邻排列。如果对 Query 和 Key 同时进行同样的重排,最终的点积结果完全相同。
order = torch.tensor([0, 4, 1, 5, 2, 6, 3, 7], device=q.device)
q_rot_interleaved = rope_interleaved(q[..., order], cos, sin)
k_rot_interleaved = rope_interleaved(k[..., order], cos, sin)
scores_interleaved = (
    q_rot_interleaved @ k_rot_interleaved.transpose(-2, -1)
    / q.shape[-1] ** 0.5
)

torch.testing.assert_close(q_rot[..., order], q_rot_interleaved)
torch.testing.assert_close(k_rot[..., order], k_rot_interleaved)
torch.testing.assert_close(scores, scores_interleaved)
# This should all return True
输出结果保留了重排后的特征,因此我们可以在相同顺序下将它们与对半分的输出进行对比。不过,如果直接对原始向量应用这两种不同的排布,计算出的注意力分数会有所不同。
6. 现代架构中的位置编码选择
自初代 LLaMA 模型问世以来,RoPE 已经成为绝大多数(开源权重)大语言模型的标配。闭源商用模型当然也可能使用它,但对闭源模型我们向来很难百分之百断定。
然而近年来,不少模型架构已不再在每个 Transformer 模块中都完整应用 RoPE。在接下来的小节中,我们将探讨其中的几种变体。
比如,前文讨论并实现的完整 RoPE,会对每一个 Query 头和 Key 头中的每一对特征都进行旋转。
在接下来的各个小节中,我们会看到不同的做法:有些模型只旋转注意力头内的部分特征;有些模型在某些 Transformer 块中直接跳过 RoPE;还有些模型则另辟蹊径,把位置信息直接注入到注意力分数中。
6.1 Partial RoPE
正如本文前面讨论的那样,常规的“全量”RoPE 会旋转每个 Query 和 Key 头的所有维度。而 Partial RoPE 是一种变体,它只旋转其中一部分维度,其余维度则保持不变。
例如,MiniMax-M3 的配置在每个 128 维的注意力头中使用了 64 个旋转维度。这样就会产生 32 组旋转特征对,剩下的 64 个维度保持不变。下图直观展示了这种设计。
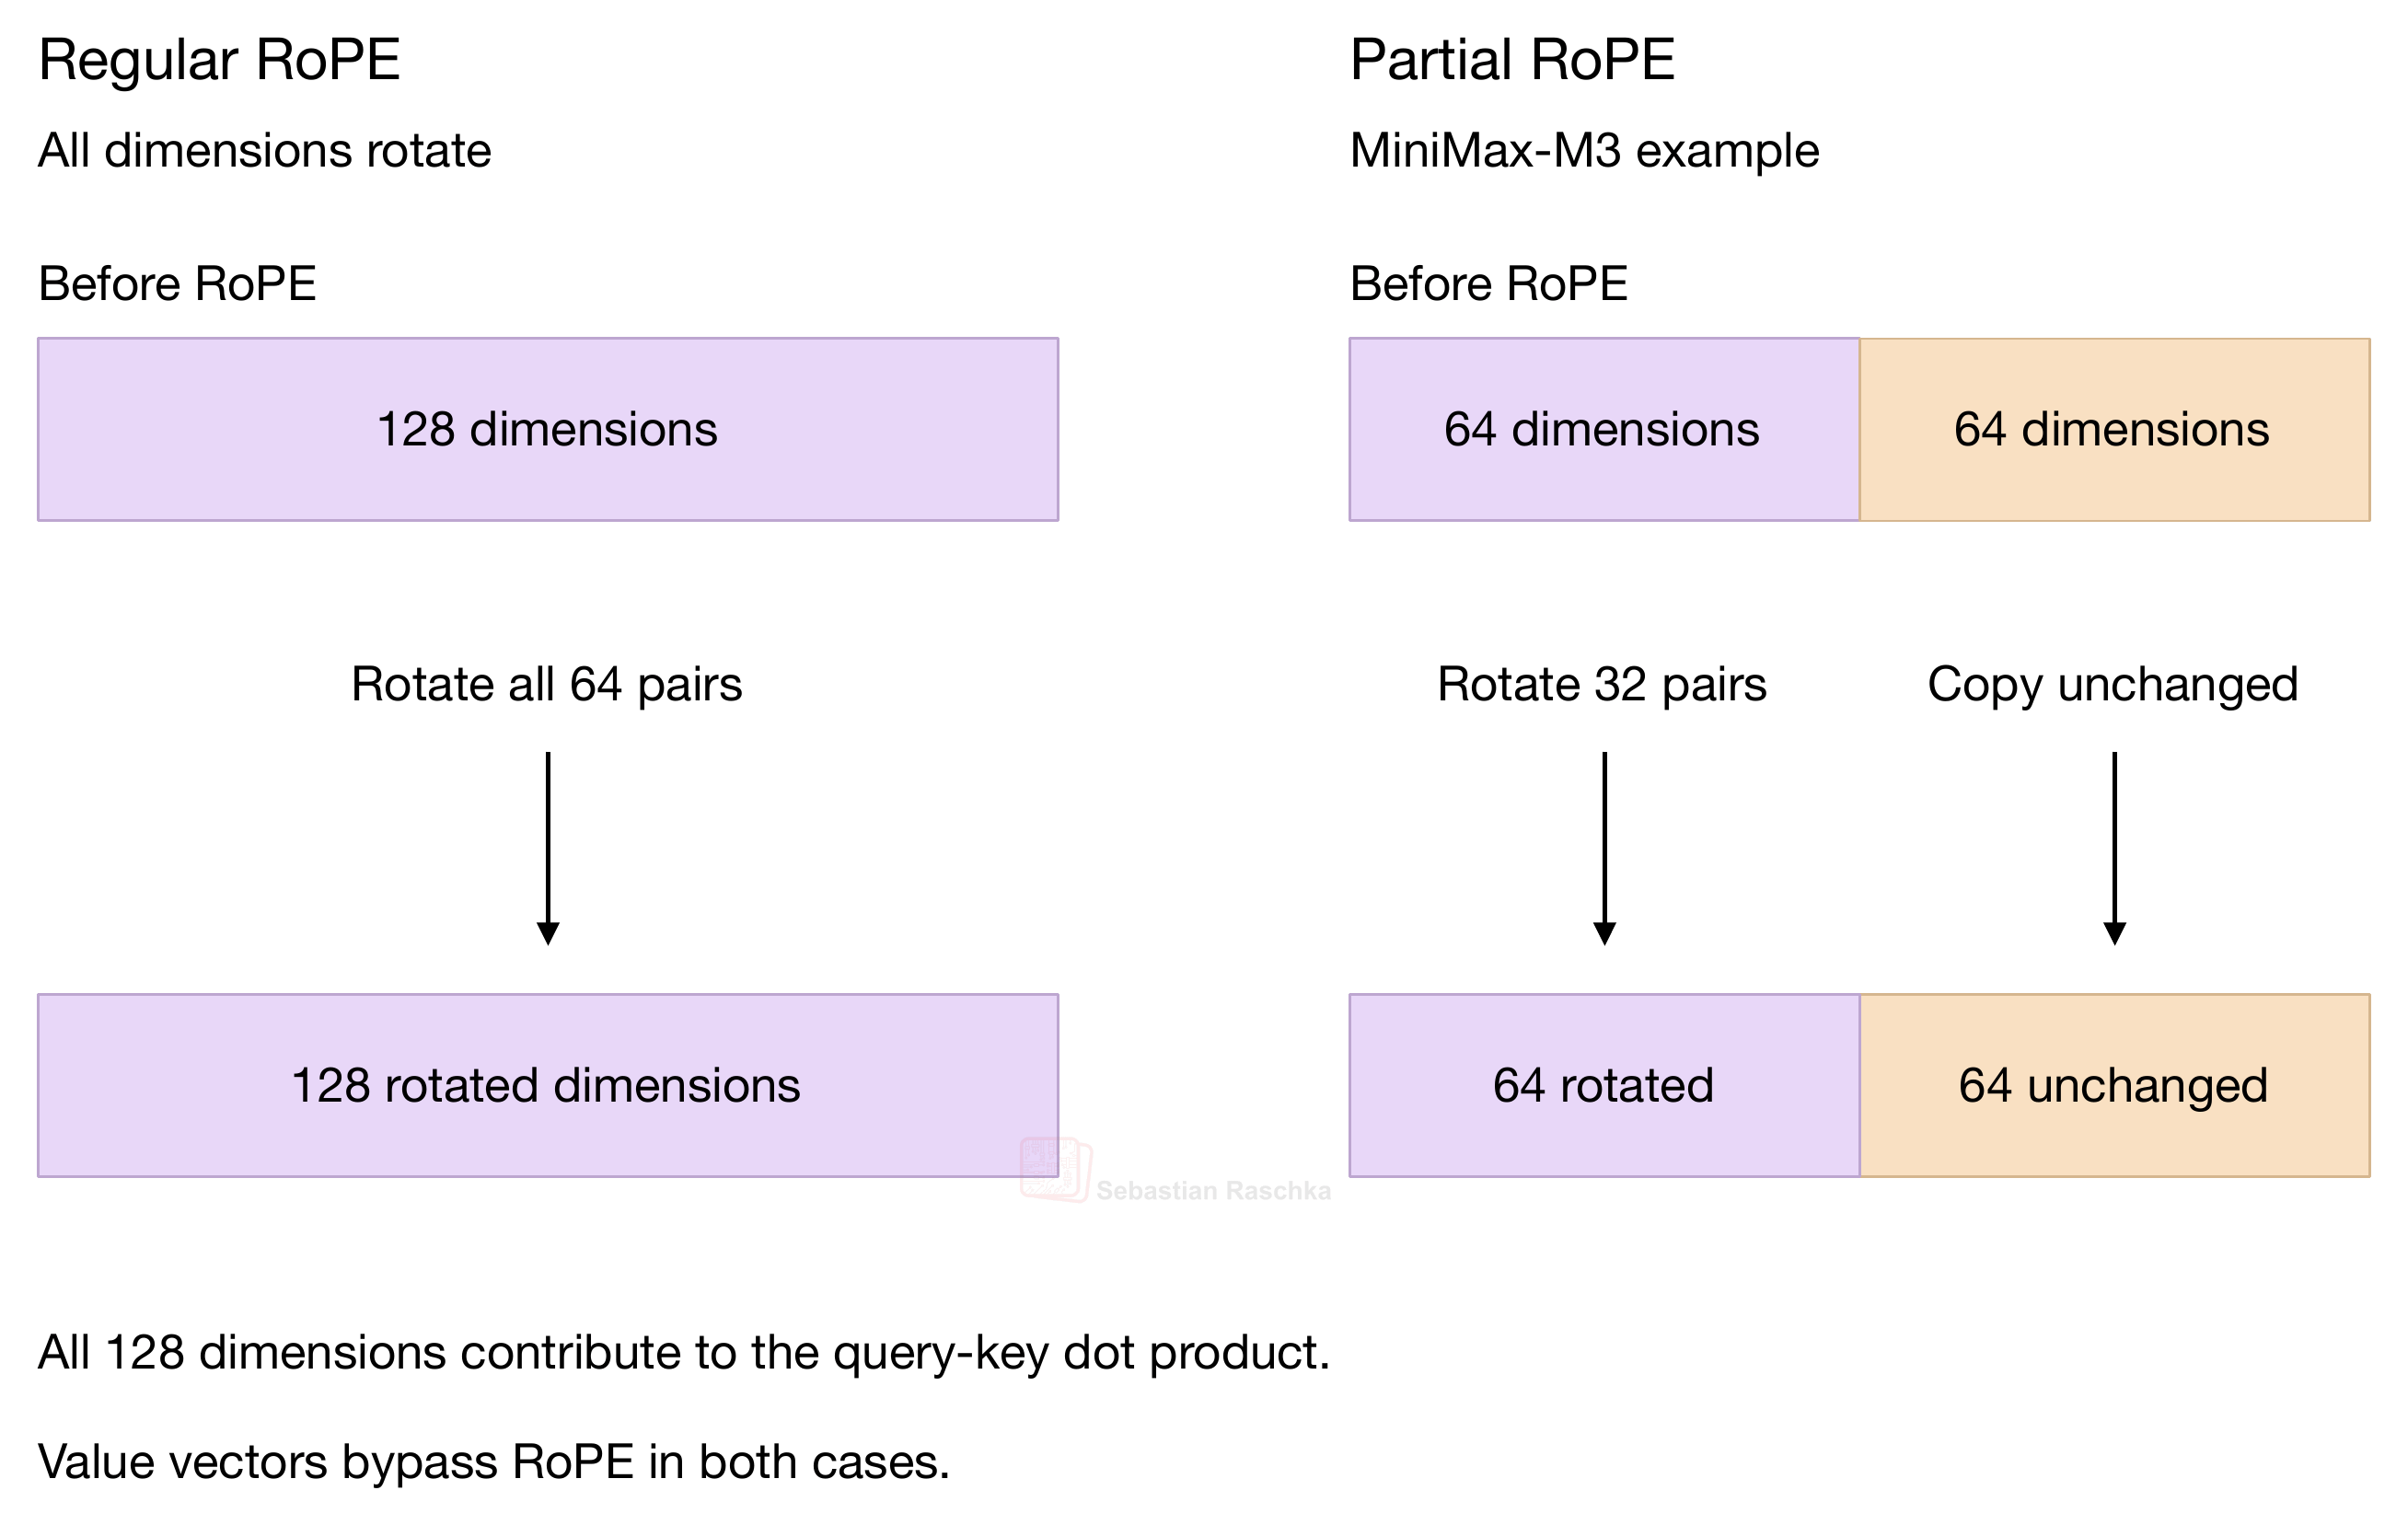
值得注意的是,如果越过第一个 Transformer 块往后看,那些未被旋转的特征依然可能包含从前面 Transformer 块继承而来的位置信息。
话说回来,Partial RoPE 究竟有什么意义?答案是能节省一部分显存。举例来说,在上面的 MiniMax-M3 中,只旋转一半特征让预计算的余弦和正弦表体积也缩减了一半。采用 Partial RoPE 后,每个查找表不再需要 64 列,而只需 32 列。不过需要注意,KV 缓存为每个缓存 token 存储的依然是完整的 Key 和 Value 向量。
在 MiniMax-M3 的 100 万 token 上下文中,将 128 个特征中的 64 个进行旋转,能让预计算的余弦和正弦表体积缩减一半;如果表格以 BF16 格式存储,可节省 0.134 GB(128 MiB)。若表格本身以 NVFP4 格式存储(包含 block scale),则可节省 0.038 GB(36 MiB)。
需要指出的是,论文Fractional Rotation, Full Potential?在 1B 到 8B 模型的实验中发现,哪怕只旋转每个头约 10% 的特征,其训练损失和基准测试准确率往往也与全量 RoPE 相当。不过在某些评测中,全量 RoPE 的表现仍然更好。
因此在我看来,Partial RoPE 带来的收益微乎其微,并不值得大费周章。
6.2 NoPE 层
NoPE 一词最早出自论文《The Impact of Positional Encoding on Length Generalization in Transformers》,代表无显式位置编码(no explicit positional encoding)。其核心思路在于:即使注意力层没有采用任何显式的位置编码方法,因果掩码依然存在,每个 Query 只能关注自身以及前面的 token。而这种因果掩码本身就已经隐式地提供了位置信息。
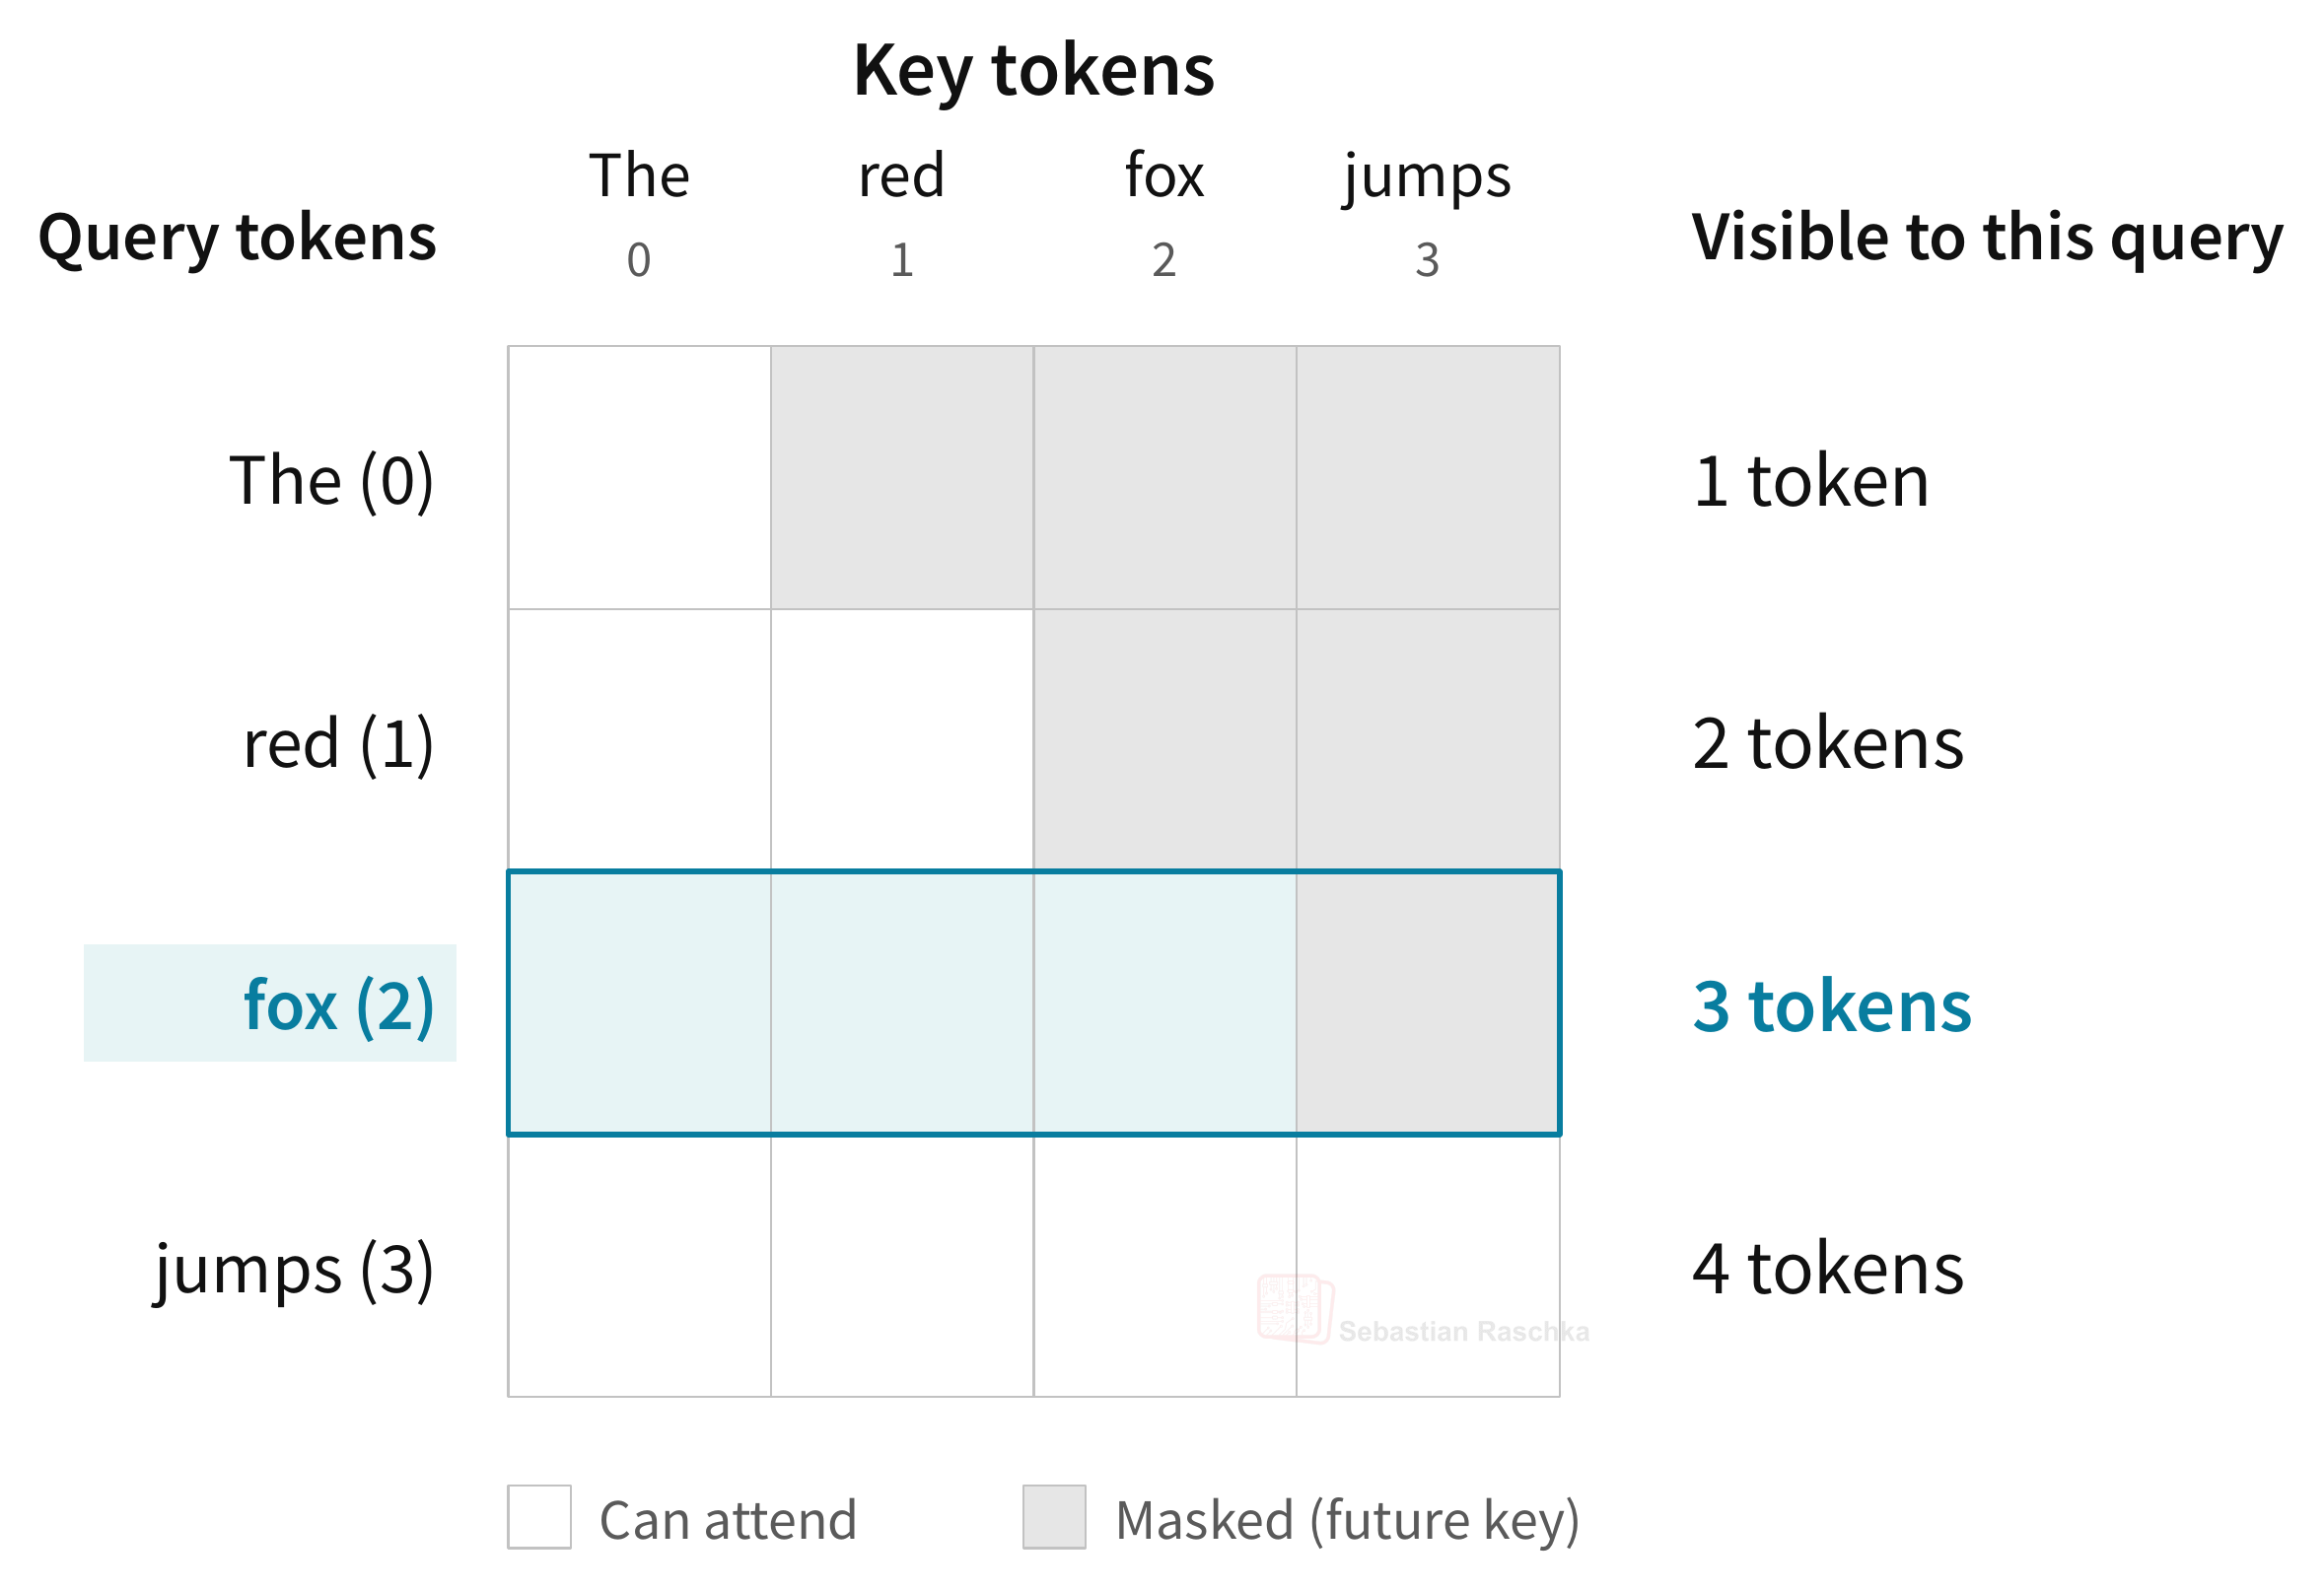
我们以之前例子中的前四个 token The red fox jumps 为例。如图 30 所示,位于位置 2 的 fox 对应的 Query 可以关注到 The、red 以及自身;位于位置 1 的 red 对应的 Query 则可以关注到 The 和自身。
那么接下来的问题是:模型该如何将因果掩码用作位置信号?下面是根据原论文改编的一个简化示例。
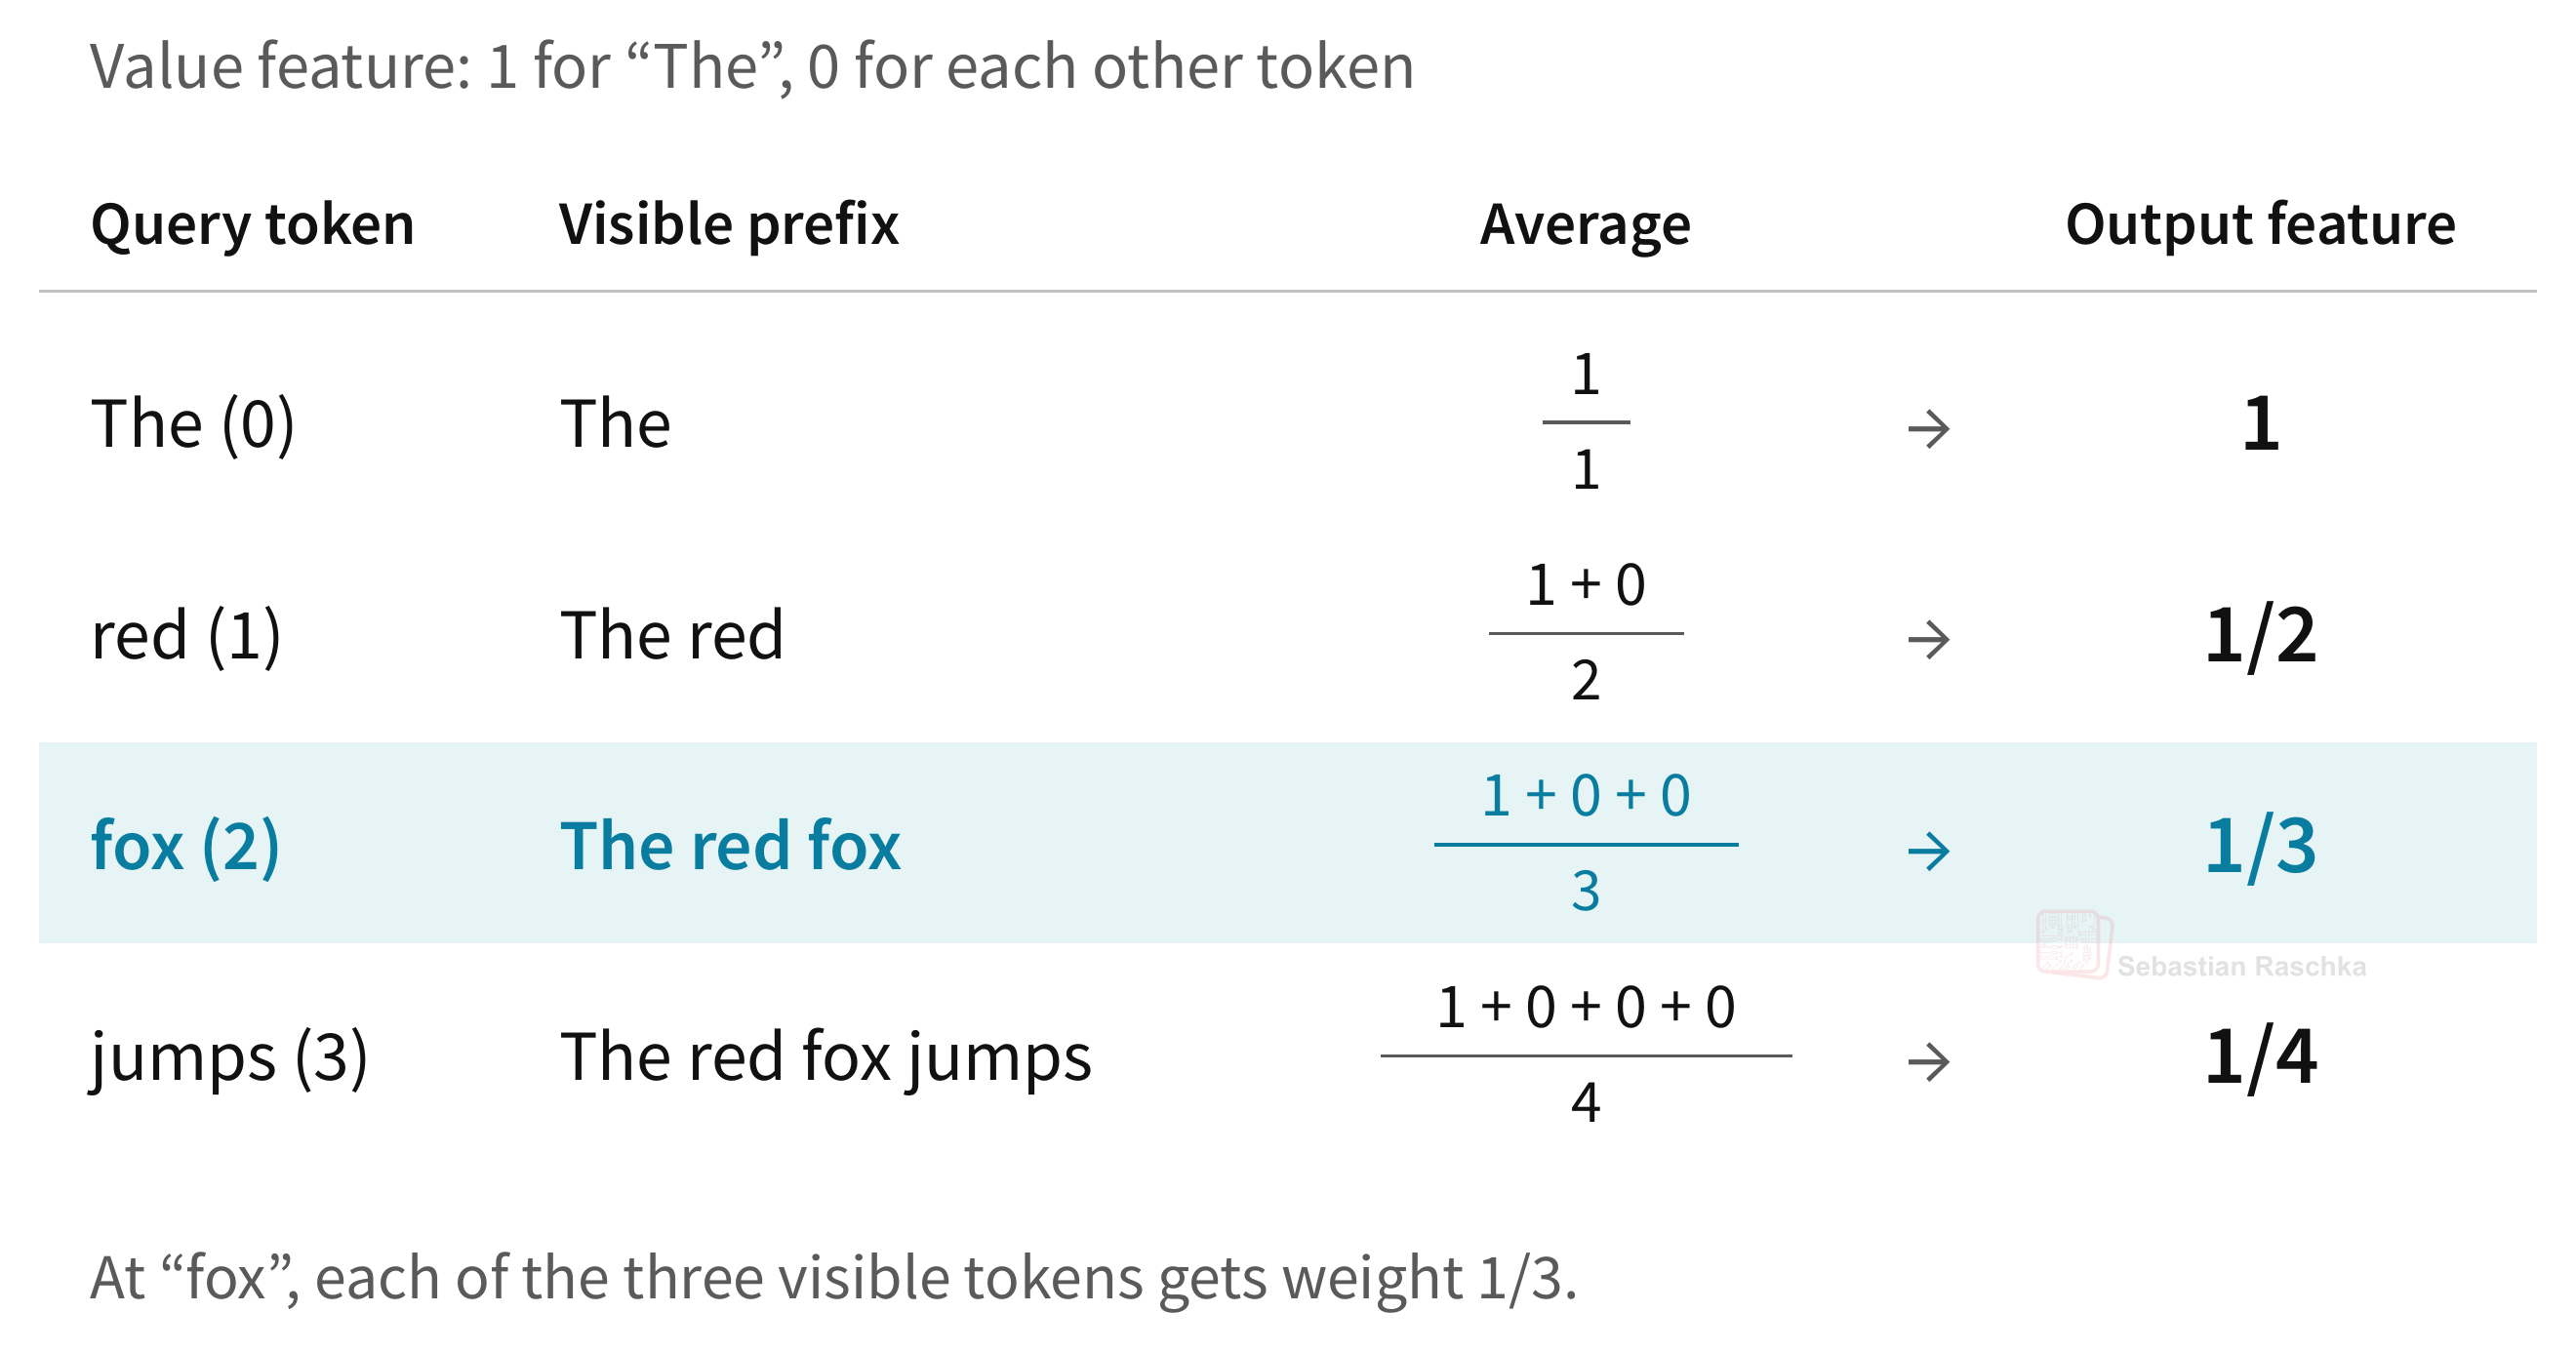
假设 Value 向量中某一维特征对于 The 为 1,对其余三个 token 均为 0。由于输入中只包含一个 The,因此每个可见的前缀都恰好包含一个 1。若所有未被掩码遮蔽的 Key 获得相同的注意力分数,Softmax 就会给每个可见 token 分配相同的权重。
这样一来,在 fox 处,注意力对 1、0、0 取平均,得到 1/3;在 jumps 处,它对四个值取平均,得到 1/4。换言之,该输出特征的值等于前缀长度的倒数,后续网络层便可以将这个值用作位置信号。
NoPE 在实际应用中表现如何?为了进行消融实验,NoPE 论文的研究人员从零开始训练了一个 107M 参数的小型纯解码器 Transformer,任务涵盖复制、排序和加法等。
当他们用超出训练长度的样本测试这个小模型时,有趣的事情发生了:在全部十项任务中,NoPE 的综合表现拔得头筹,甚至超过了 RoPE。NoPE 论文的研究团队还开展了另一组实验,用代码数据训练了一个更大的 1.3B 参数模型。在面对超出训练长度的上下文时,NoPE 同样能处理,但在测试的最长长度下,其下一个词元(next-token)的预测表现出现了下滑。
如今甚至有一些开源权重的大语言模型走得更远,在所有层中都采用了 NoPE。不过目前更常见的做法,是至少在部分层中省略 RoPE——这里所说的“层”指的是 Transformer 块(Transformer block)。
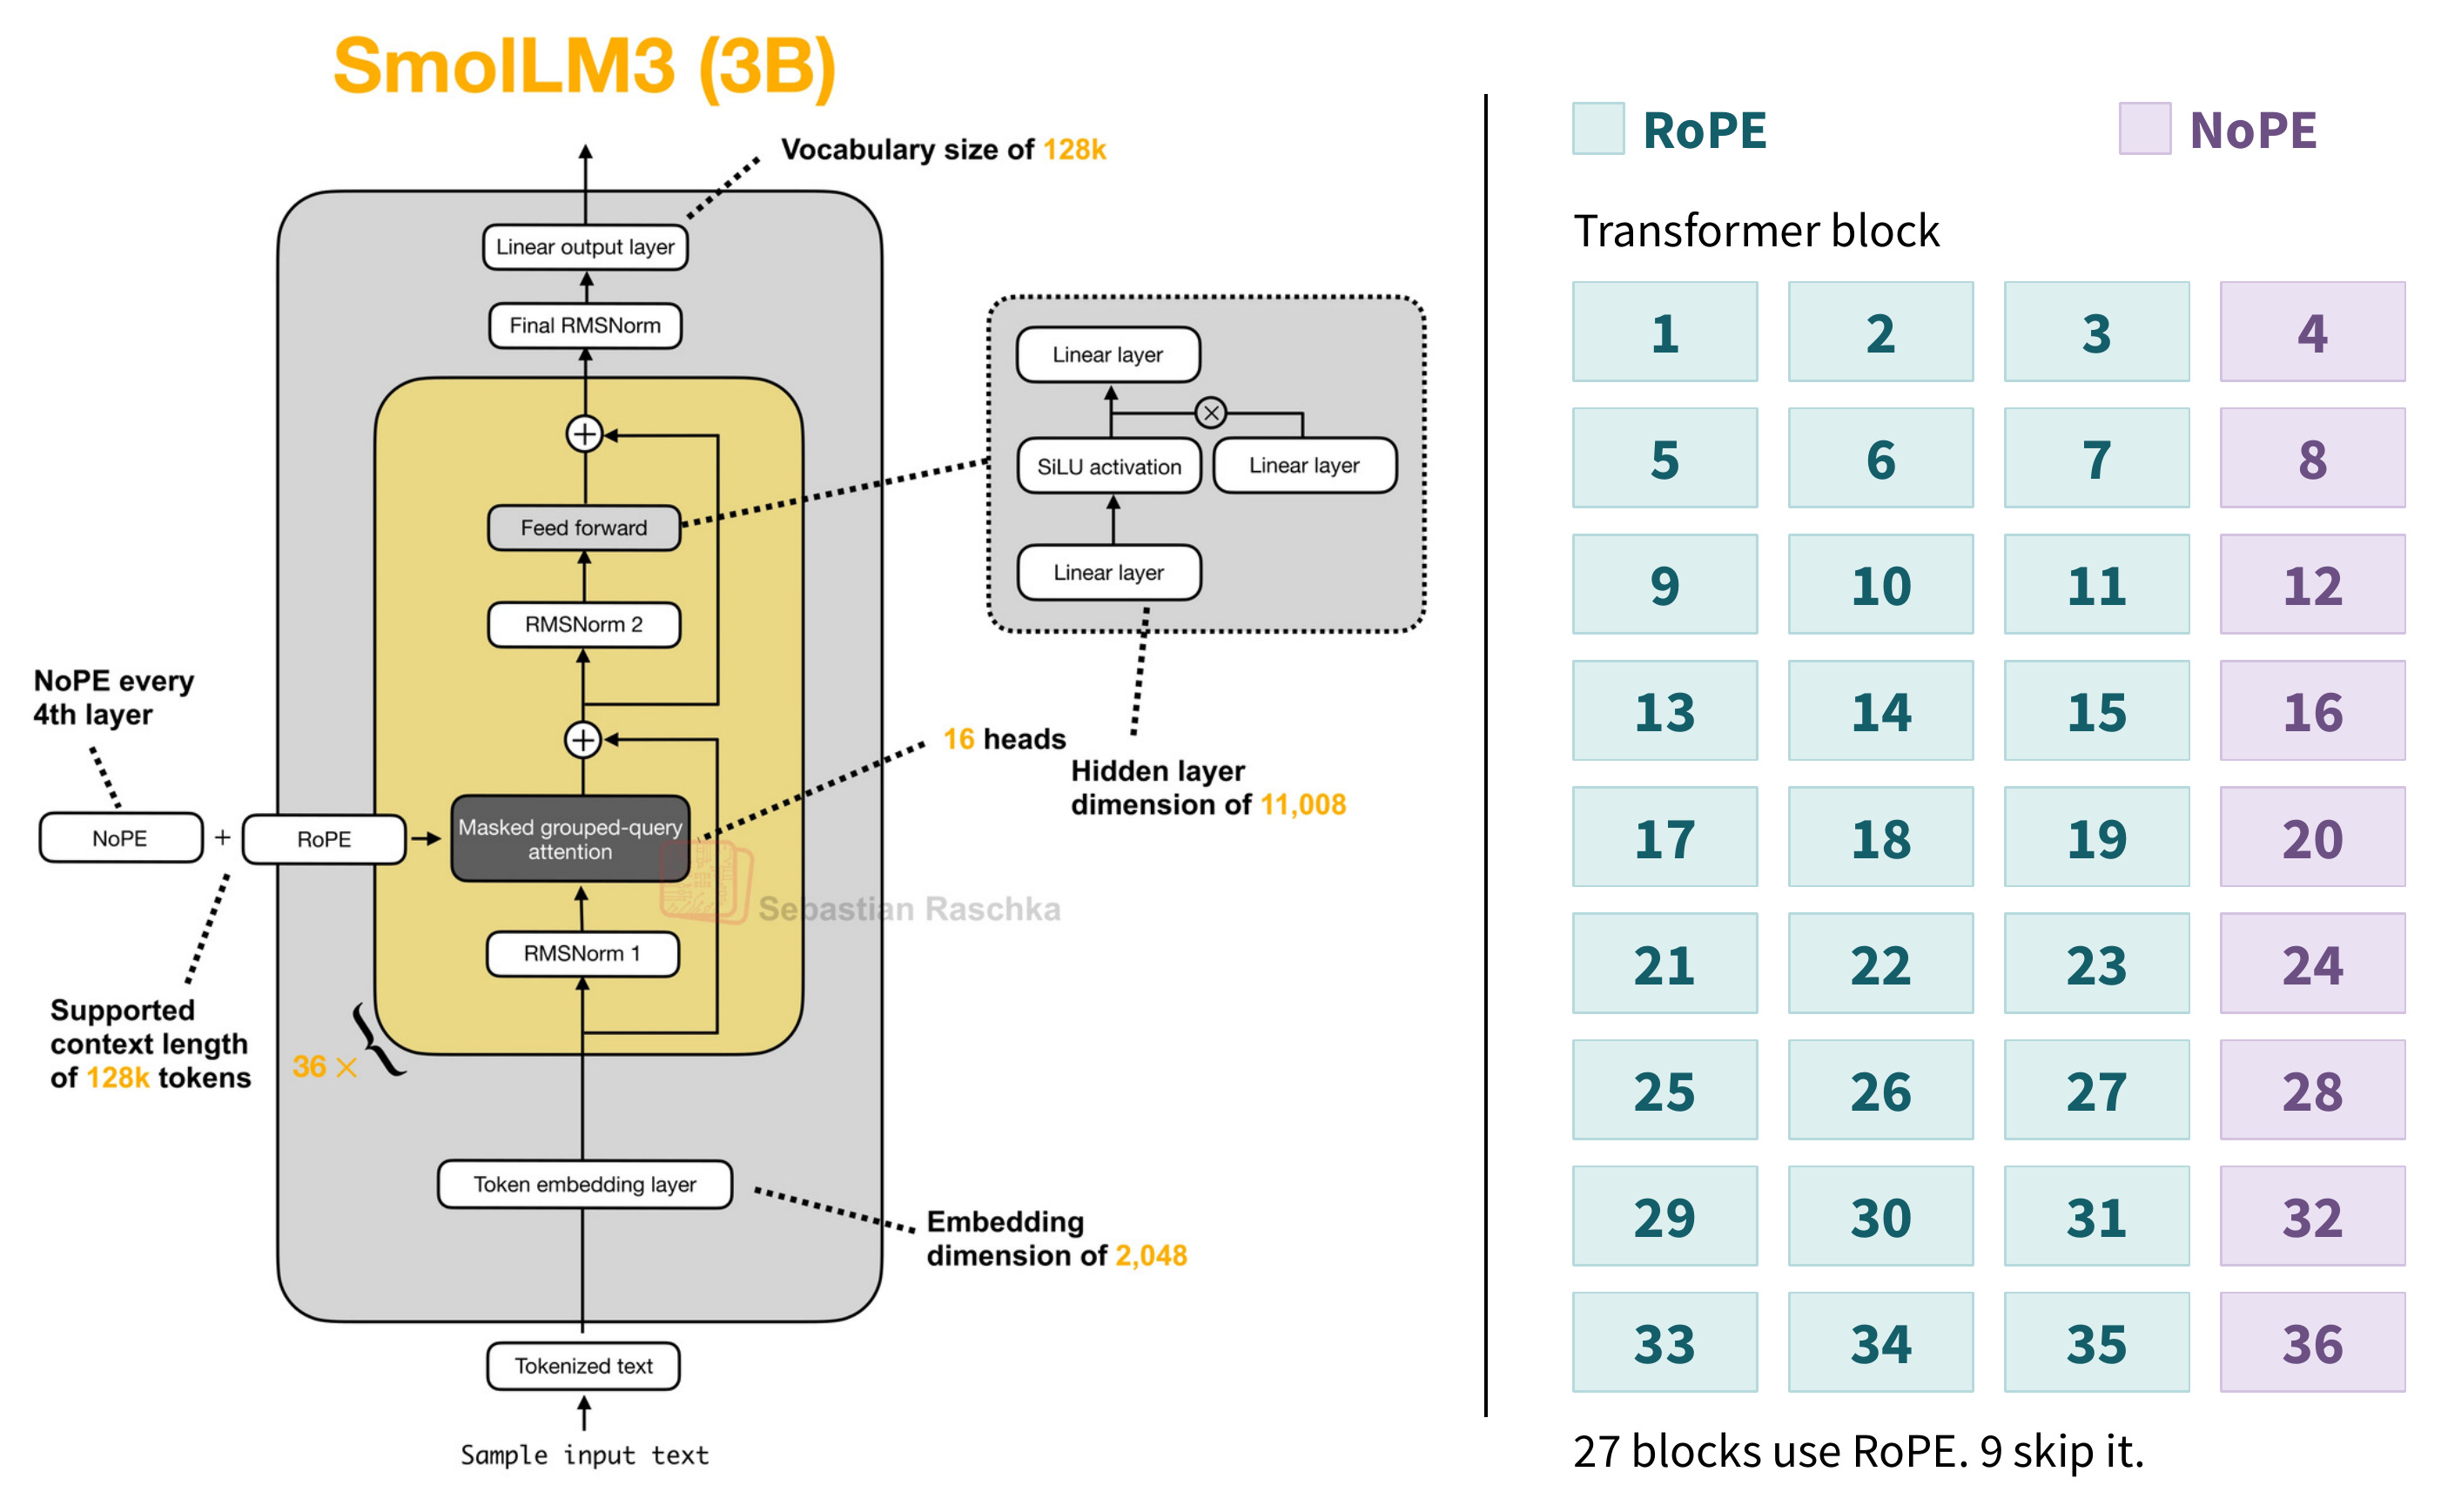
举个具体的例子:参数量为 3B 的 SmolLM3 采取了“每三层应用 RoPE、第四层跳过”的模式,并在全部 36 层中循环重复这一结构。有趣的是,SmolLM3 的作者提到,这种分层模式提升了长上下文的性能表现。
(另外需要注意的是,第一层之后的任何后续层,哪怕跳过了旋转编码,也依然会接收来自前面 Transformer 块的输入,因此它的查询和键其实仍然带有一部分来自浅层的显式或隐式位置信息。)
6.3 可学习相对位置偏置
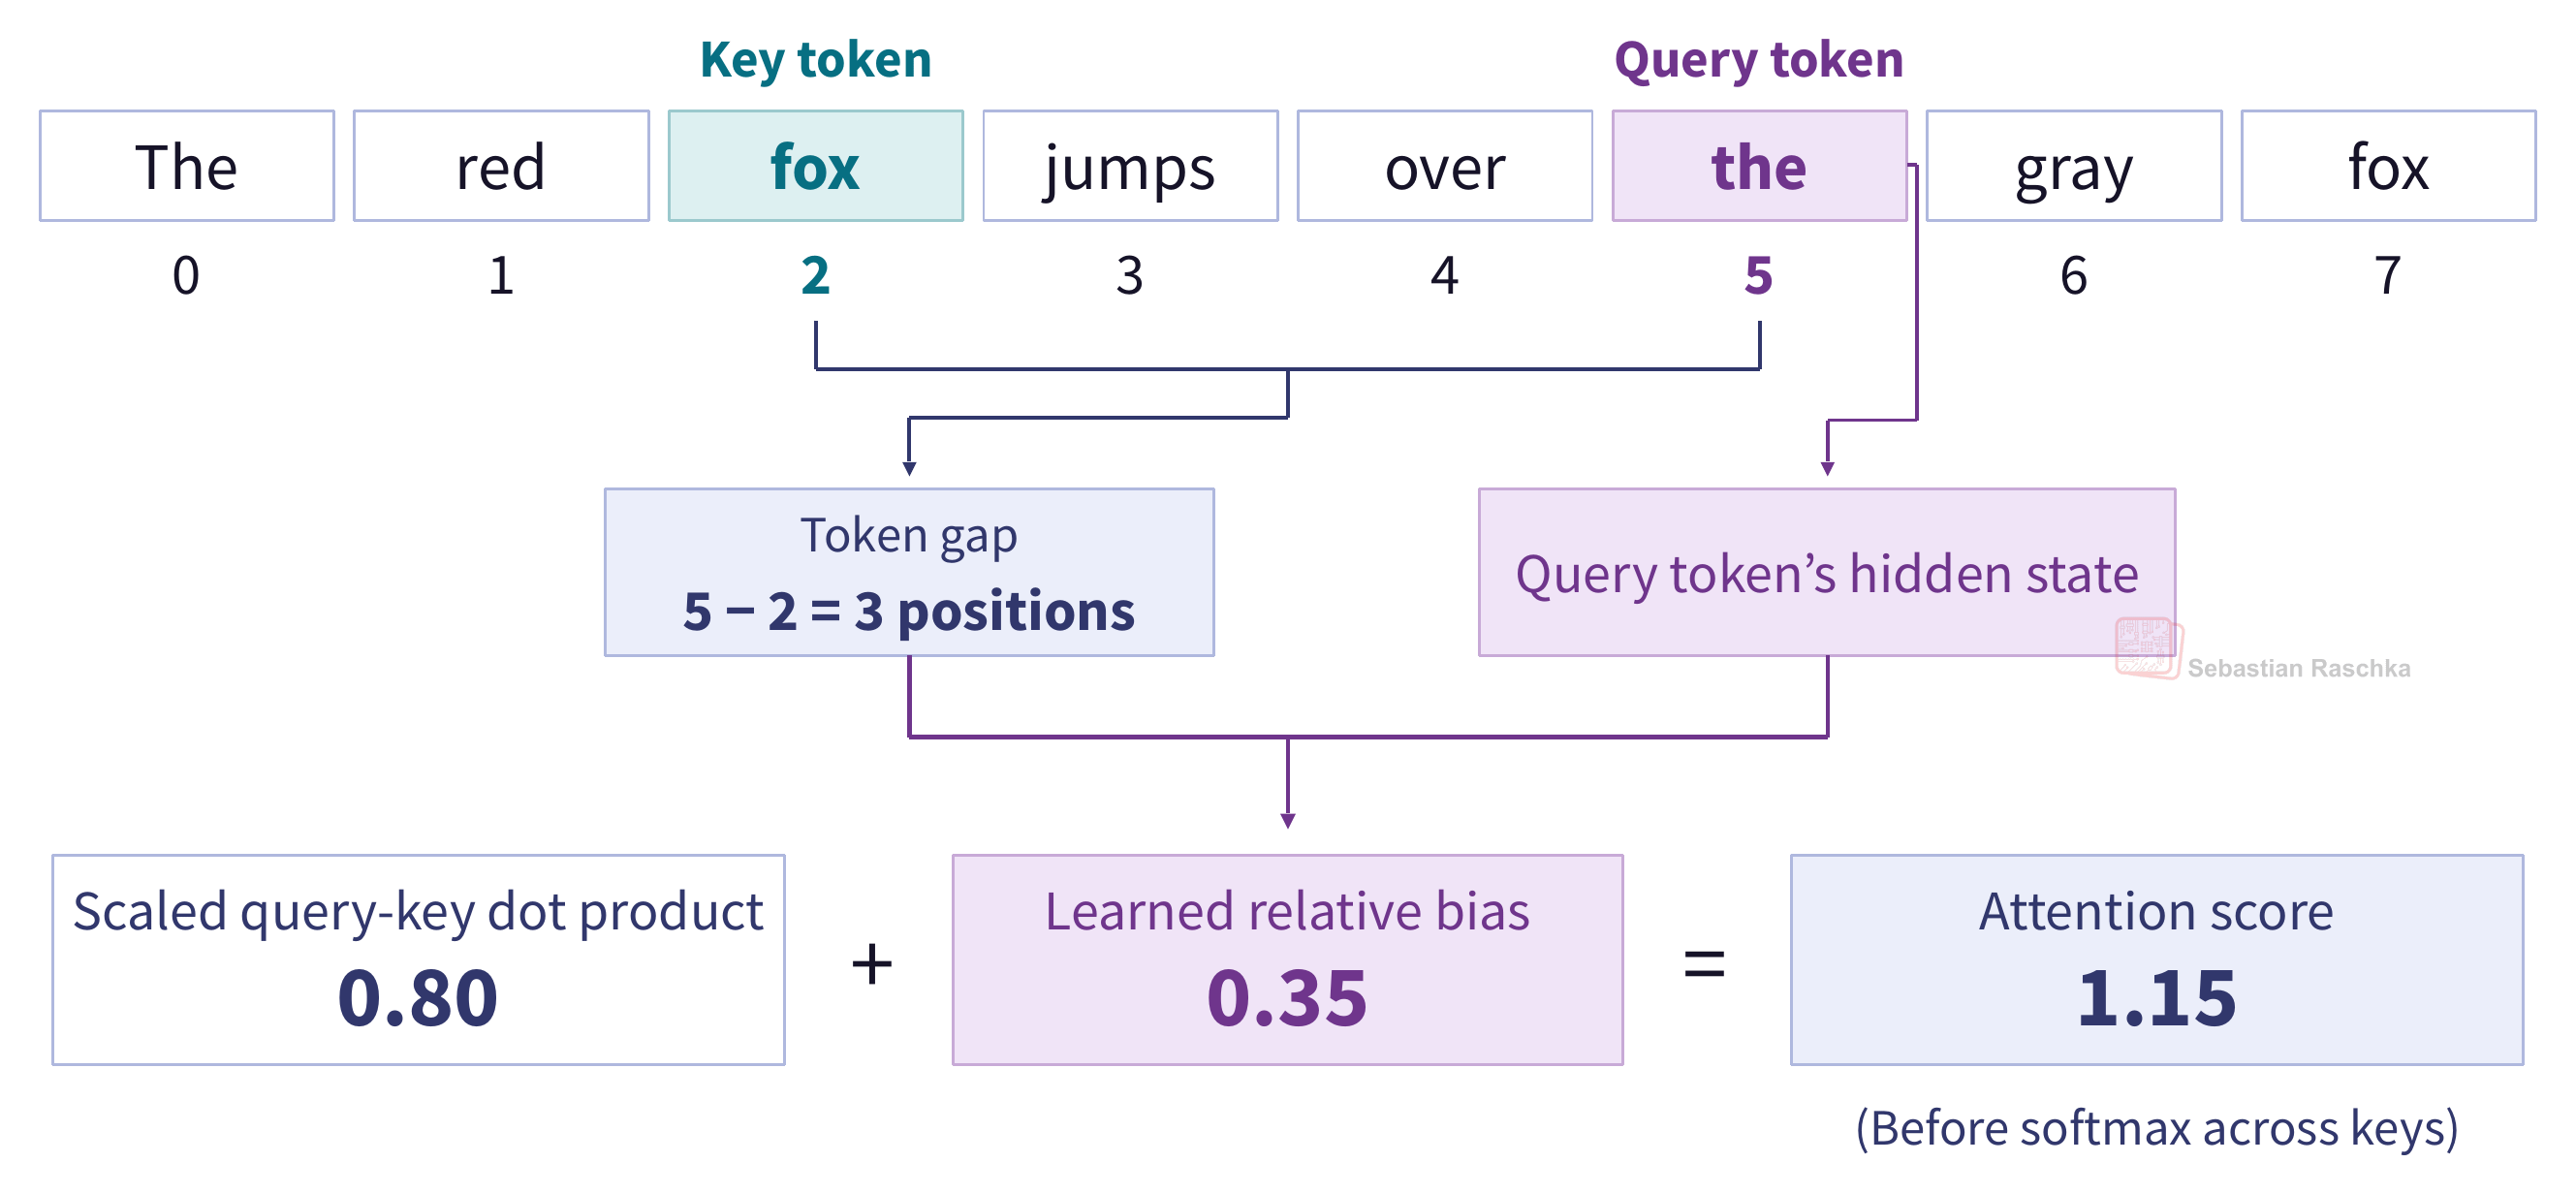
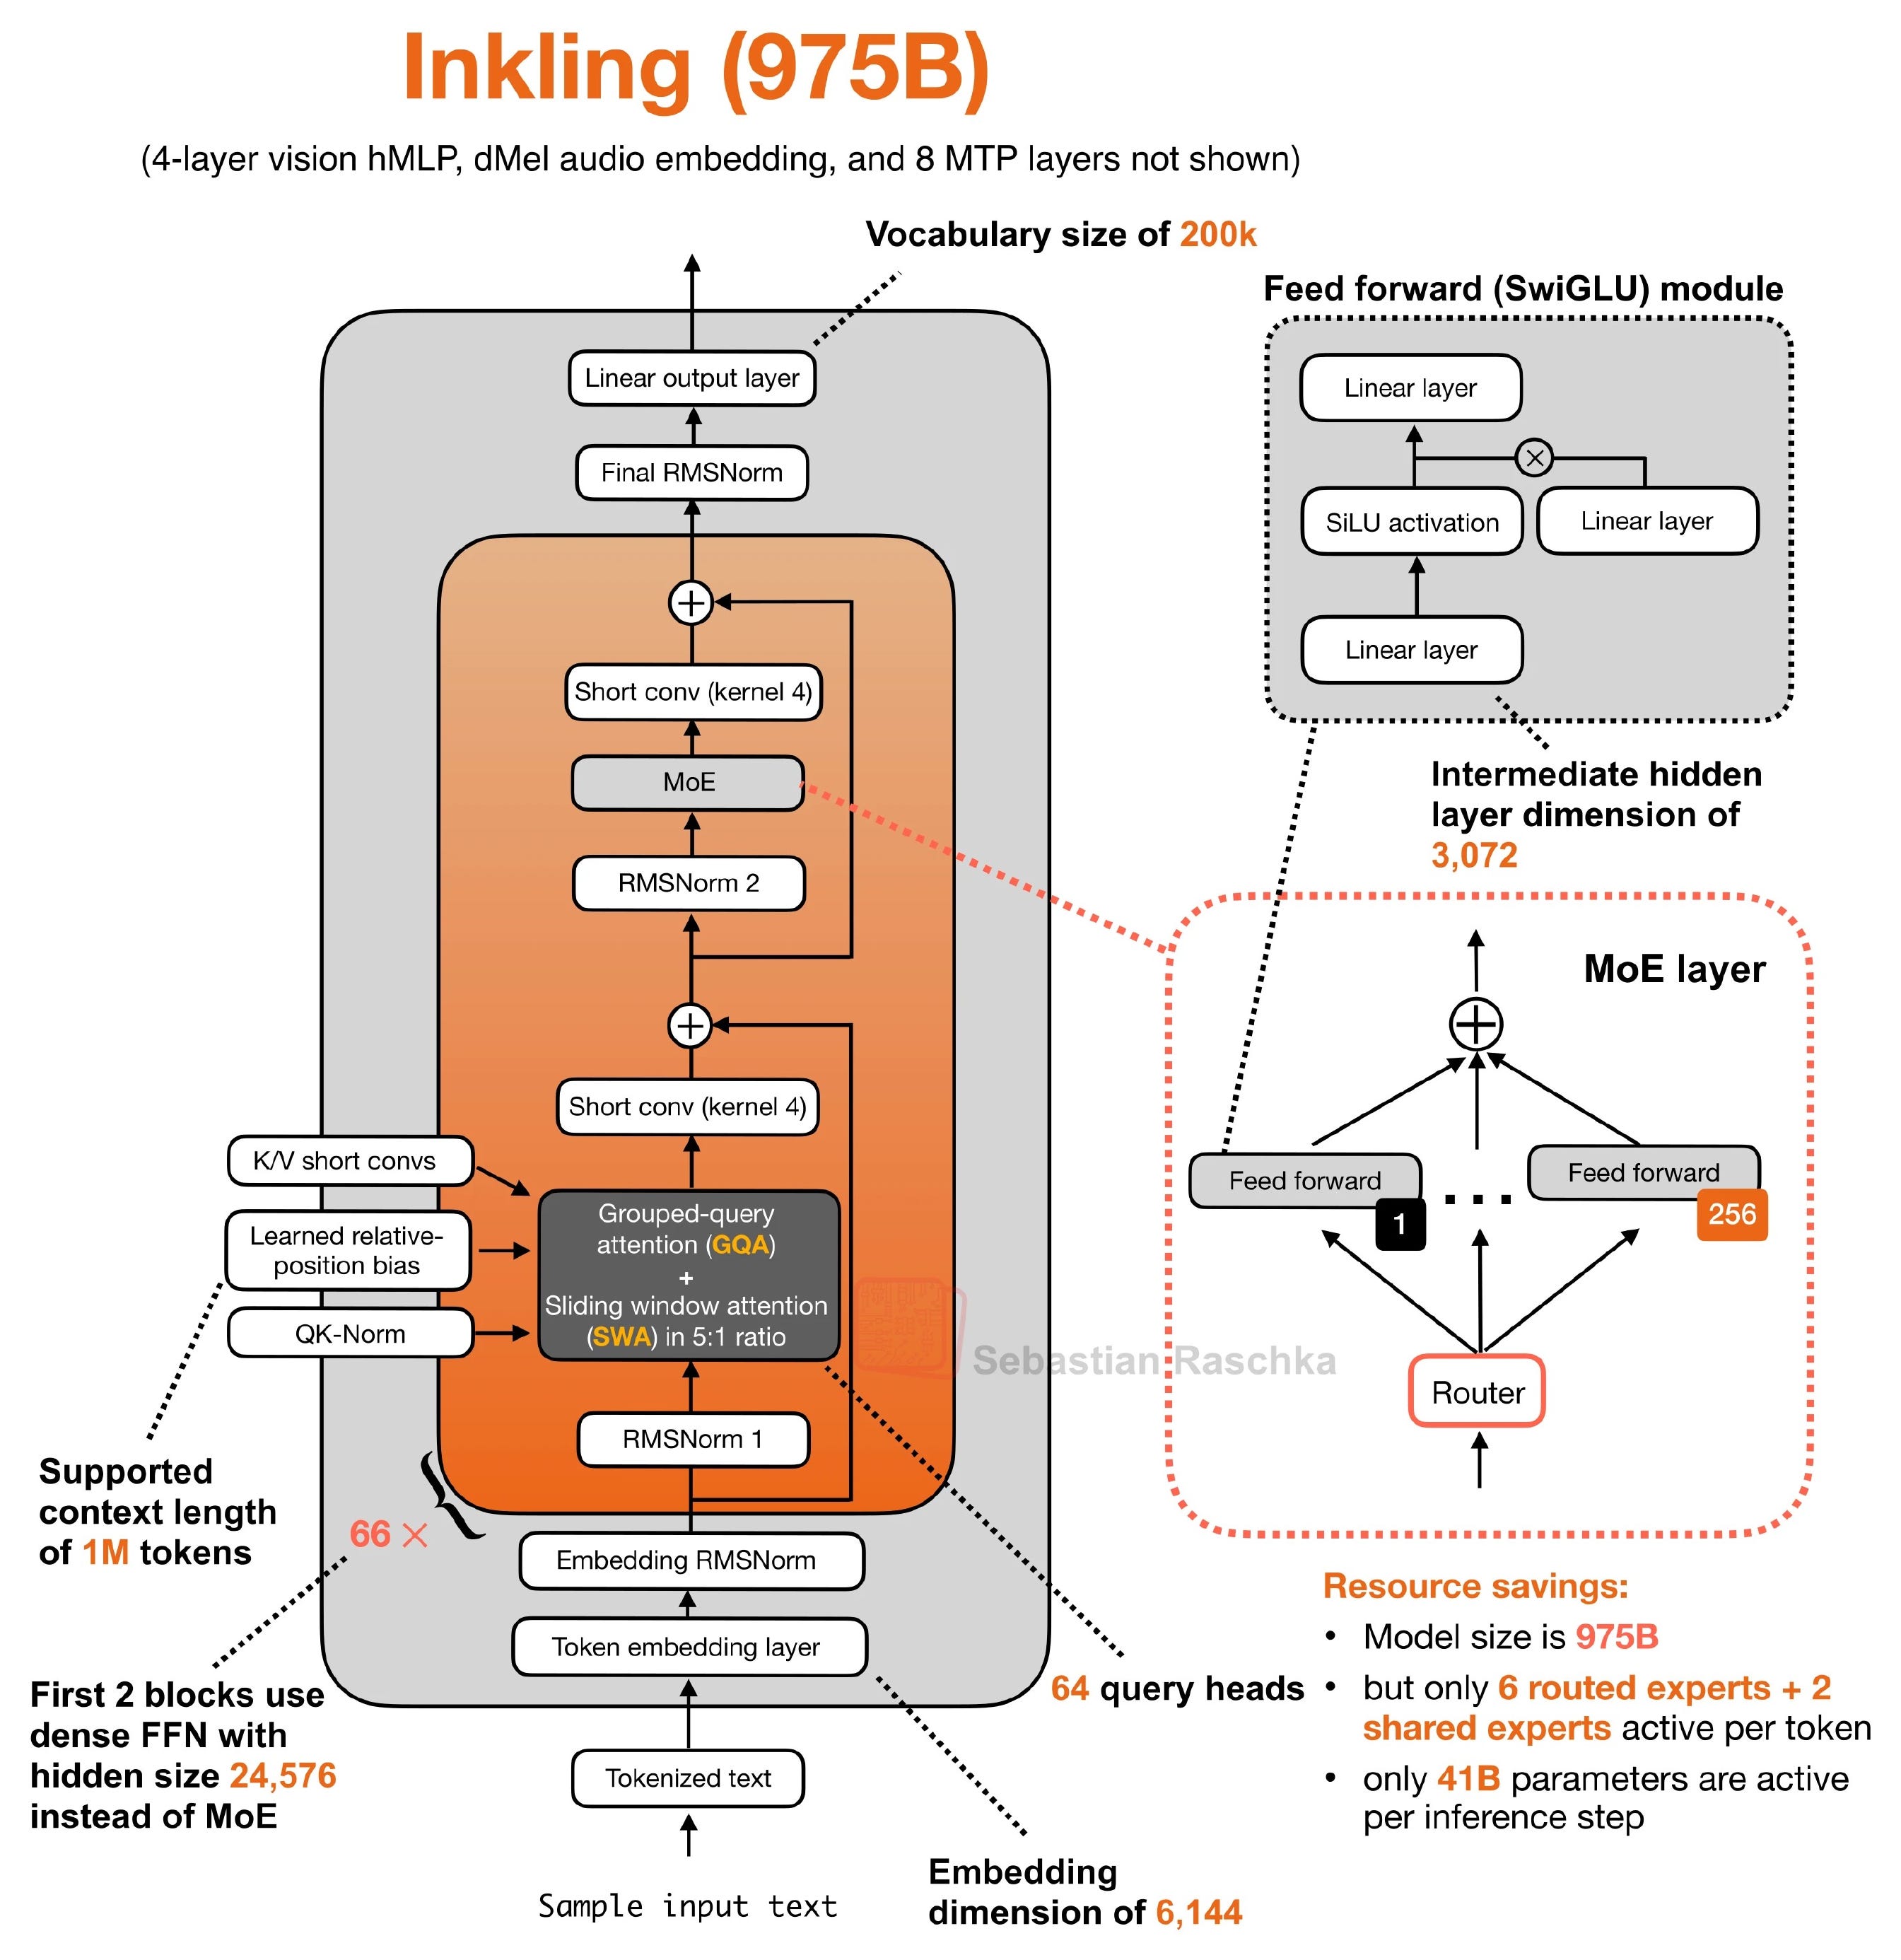
在总结当前主流架构的具体用法之前,还有一个方法需要介绍。例如,Thinky 的 Inkling 在滑动窗口注意力和全局注意力层中,都采用了可学习的相对位置偏置(learned relative position bias)。它先正常计算查询与键的缩放点积,随后在计算注意力分数的 Softmax 之前,往得分里加上一个特定数值。这个数值取决于当前查询词元的隐藏状态,以及键相对于查询落后了几个位置。
我们再来看前面那个例句:“The red fox jumps over the gray fox.”(我保证这是最后一次用了!)在下图中,位置 5 的“the”作为查询,位置 2 的“fox”作为键。Inkling 利用两者之间相差的 3 个位置距离,结合“the”的隐藏状态计算出偏置值,再把它加到缩放点积上。
这个思路并不算全新。可能有人还记得 Google 在 2019 年推出的热门模型 T5(Text-to-Text Transfer Transformer),当时就采用过类似、但更为简化的方案。
6.4 这些方案在近期模型中的应用情况
铺垫了这么多,最关键的问题来了:各大架构到底都选用了哪些方案?近期的技术趋势又是怎样的?
为了弄清楚这一点,我按发布日期对“大模型架构图鉴”中的条目进行了分组,把 2025 年发布的模型与 2026 年快照中上半年和下半年的模型做了对比。图鉴中的每张卡片只计算一次,因此同一种架构的多个变体都会计入统计结果。大模型架构图鉴
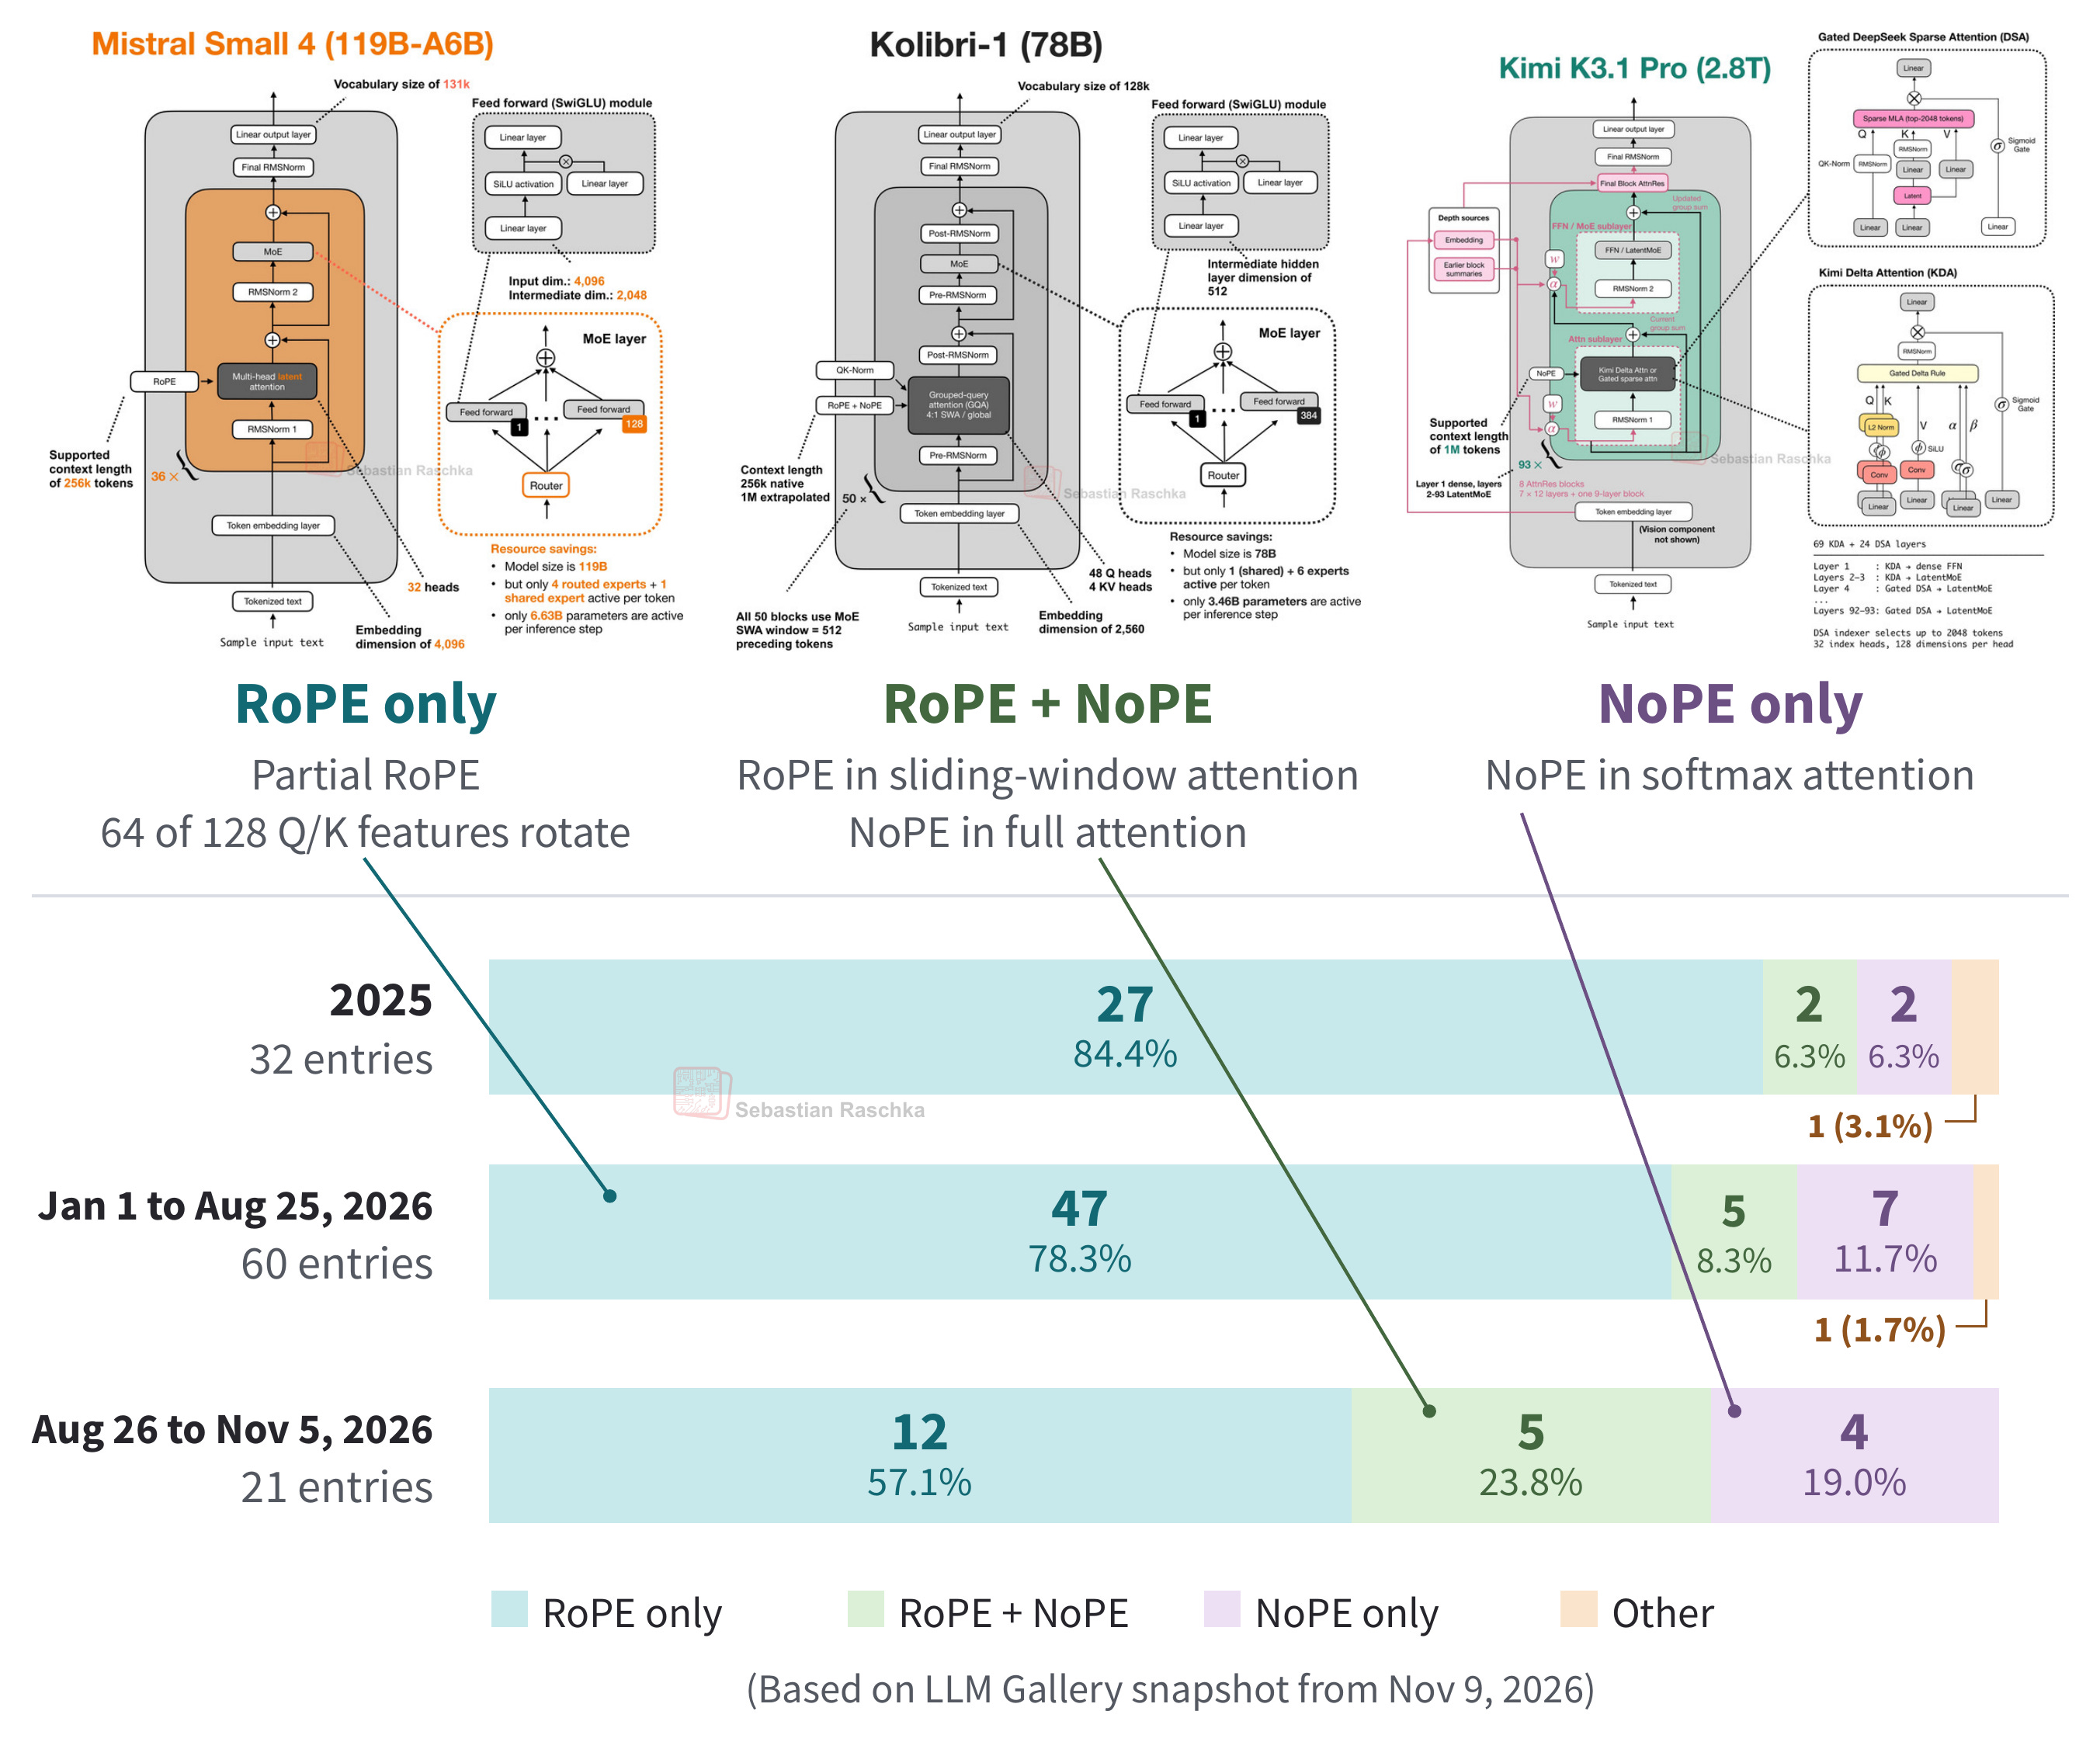
从上面的图 35 可以看出,在每一个 softmax 注意力层中都使用 RoPE 仍然是最普遍的选择。不过,从 2025 年到 2026 年,再到 2026 年下半年,这种做法的占比一直在下降,这或许预示着一种新趋势。
相应地,混合使用 RoPE 和 NoPE 的模型数量开始增多。不过目前样本量还比较小,这类趋势能否延续仍有待观察。
仅使用 NoPE 的条目全部属于循环混合架构(recurrent hybrid),其 softmax 注意力层没有采用任何显式的位置编码。这里的“其他”(Other)类别指的是 xLSTM 7B(2025)和 Inkling(2026):xLSTM 没有任何 softmax 注意力层;而正如我们在 6.3 节中所见,Inkling 是在 softmax 之前给注意力分数加上了可学习的偏置。
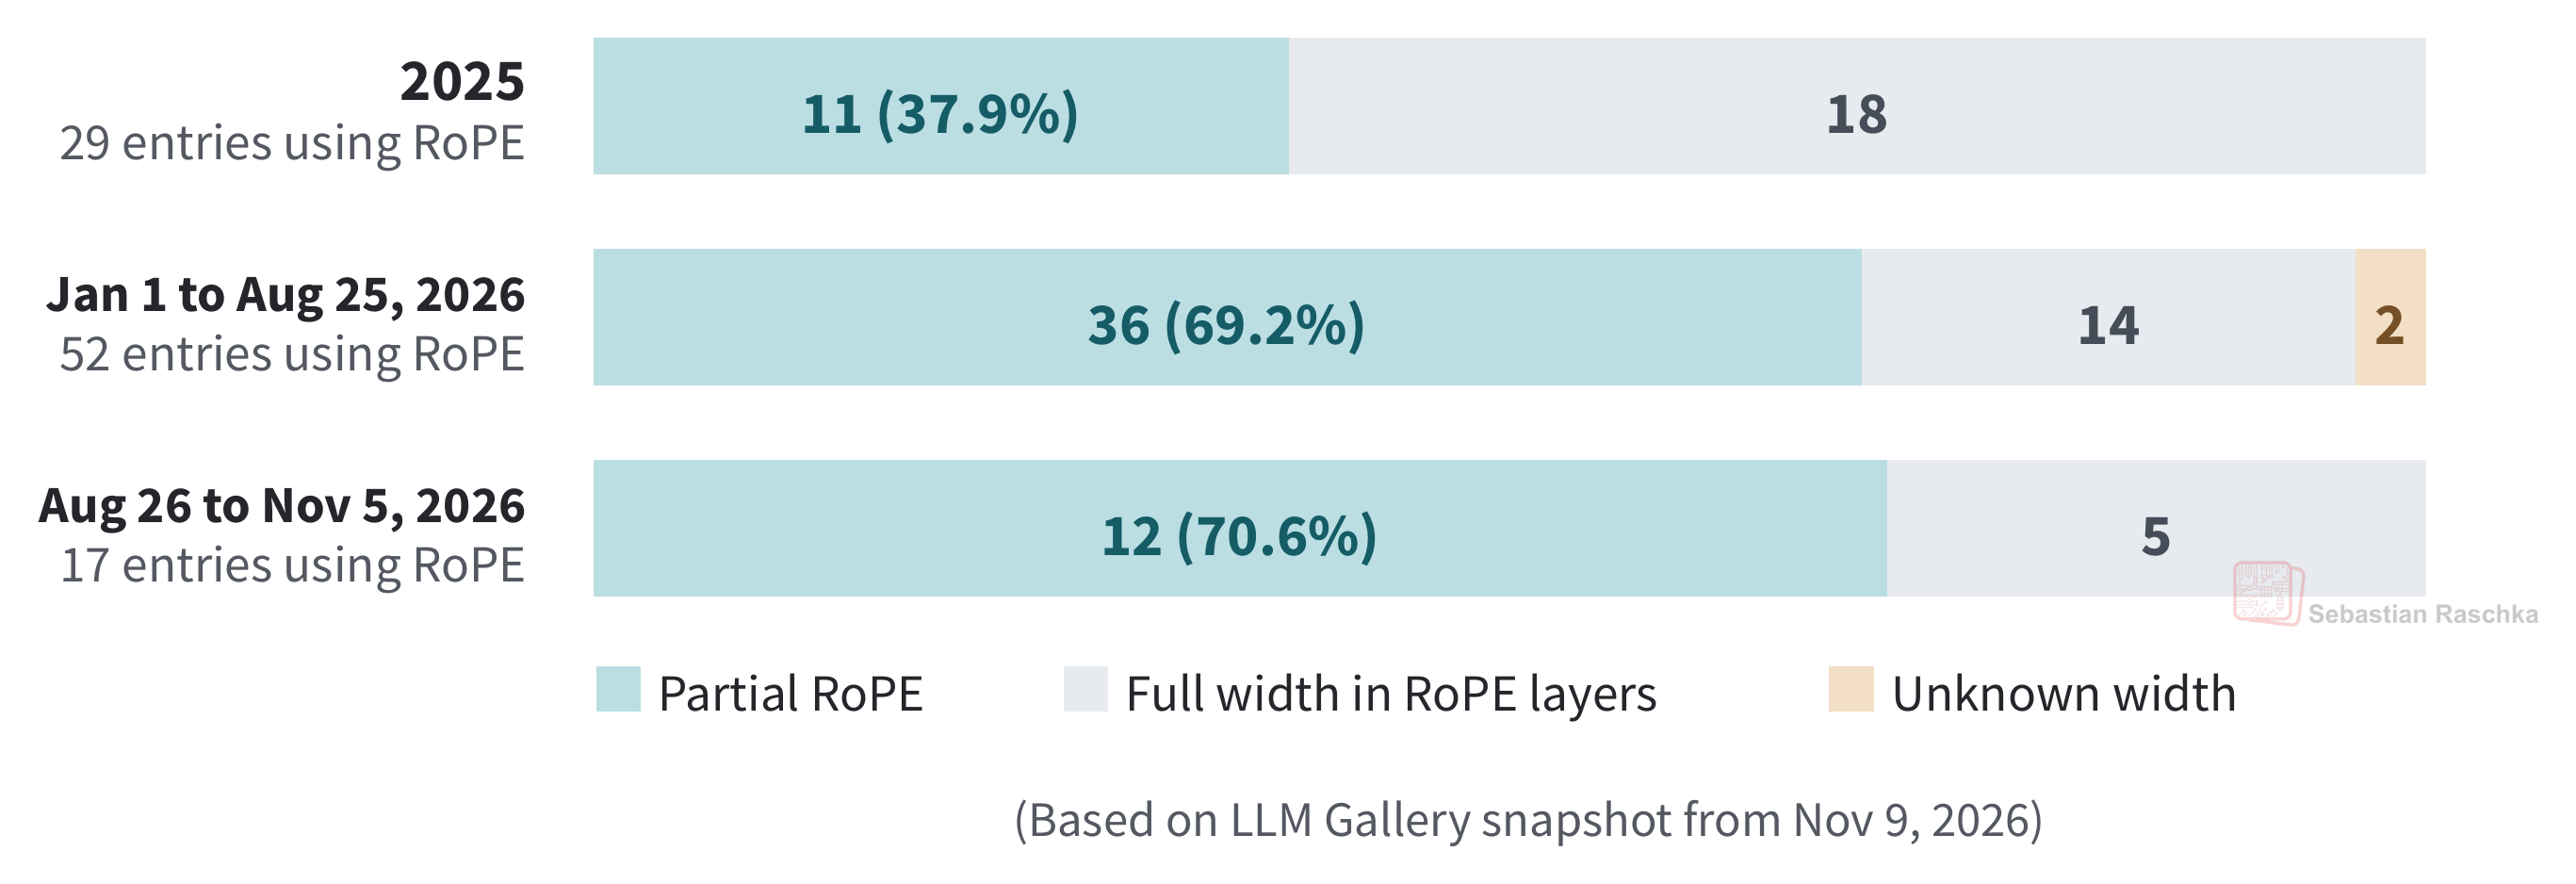
在使用 RoPE 的模型中,部分应用 RoPE(partial RoPE)的做法在 2025 到 2026 年间越来越普遍。如图 36 所示,它从 2025 年 RoPE 模型中的少数派,变成了 2026 年两个时期里的绝对主流。
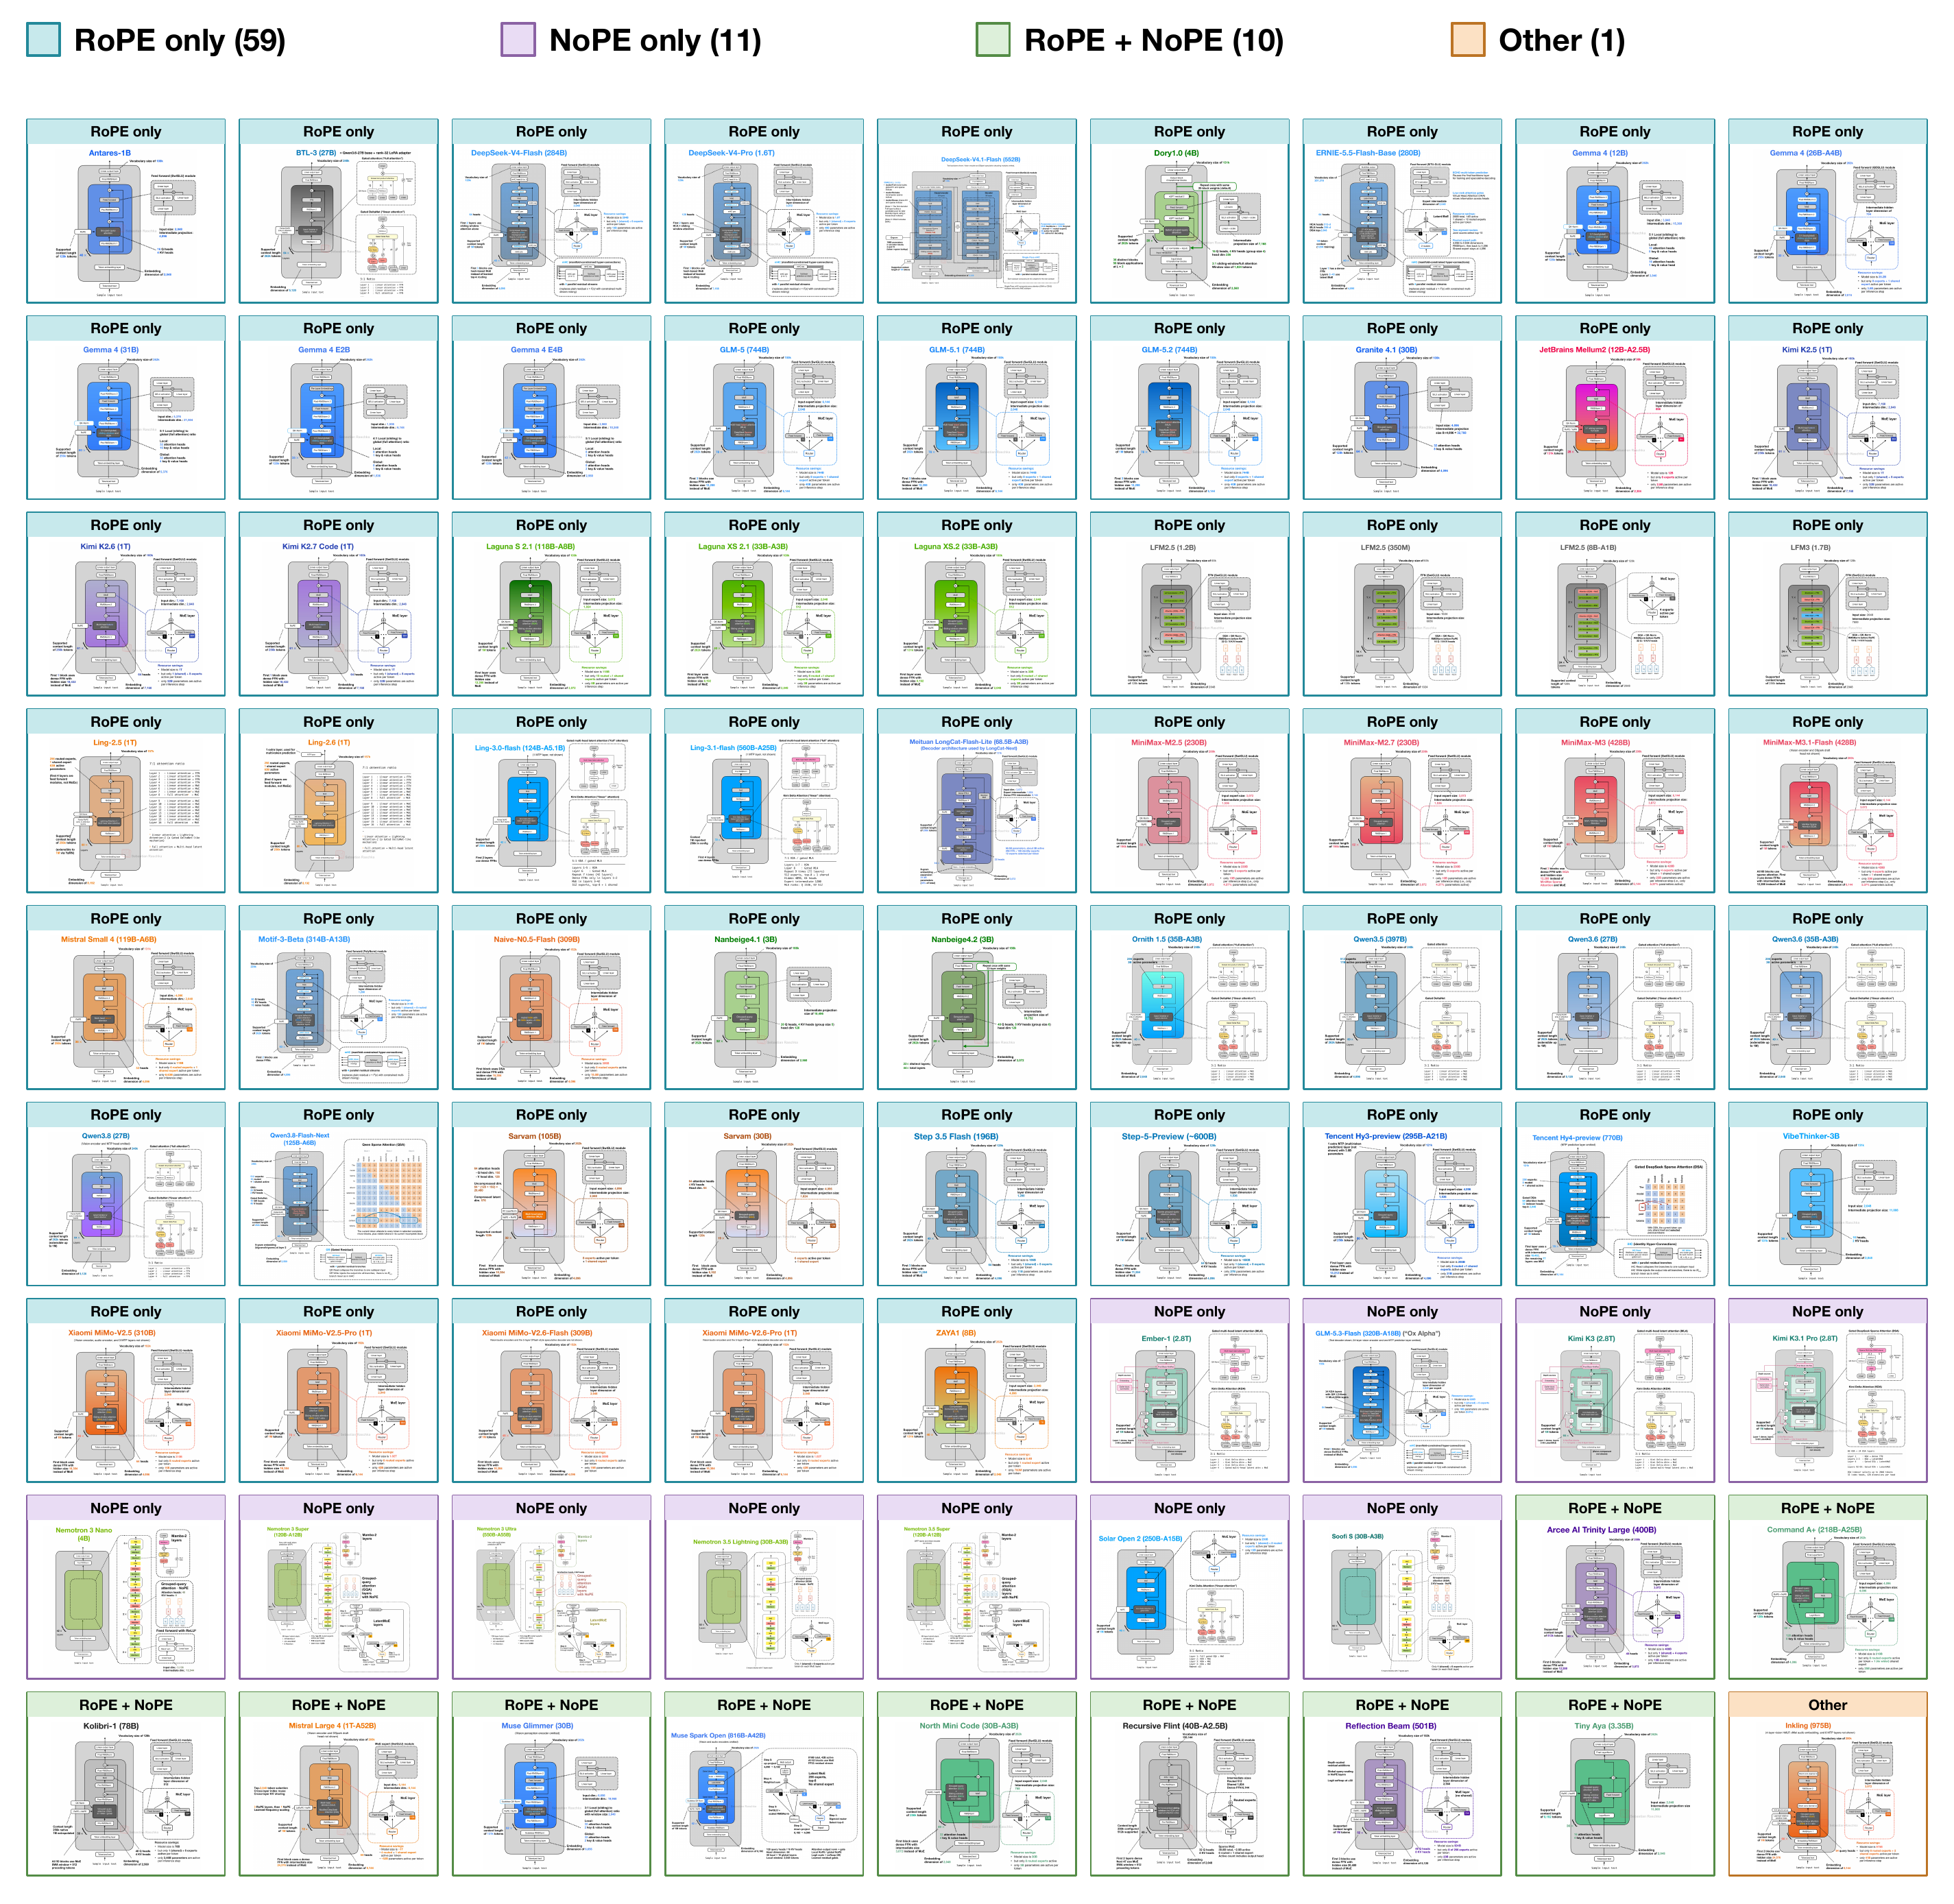
如果你想查阅 2026 年各组中的具体模型,下方的图 37 提供了 2026 年图鉴总览,并按位置编码类型标注了各个架构。你也可以在这里通过交互式界面浏览整个图鉴。
7. 结语
简单回顾一下:我们首先探讨了 GPT-2 和初代 Transformer,它们是在进入第一个 Transformer 模块前,直接在每个 token 嵌入上叠加位置向量;随后,现代大模型转向了 RoPE,通过旋转 query 和 key 在注意力机制内部对相对位置进行编码。令人称奇的是,RoPE 至今依然是最主流的位置嵌入方案。
不过近来也出现了一些新尝试:Inkling 借鉴了 T5 的思路,在 softmax 之前向注意力分数添加可学习的相对位置偏置;此外还涌现出了 NoPE-RoPE 混合架构,选择在部分层中省去 RoPE。
结论听起来或许缺少惊喜:如前所述,RoPE 依然稳坐位置嵌入领域的头把交椅,而且我相信这一地位绝对会延续到 2027 年。不过,到了 2027 年,我们或许会看到更多类似 Inkling 设计的架构崭露头角。
尽管这个结论看似“波澜不惊”,但时隔多年,我总算把这篇关于 RoPE(及其他位置信息方法)的文章写了出来,并将其收录到我的大语言模型“基础原理解析”系列中,对此我还是感到非常欣慰。
如果你对大模型的其他架构组件感兴趣,我依然强烈建议从 GPT-2 风格的模型入手,这能让你以最低的理解成本吃透核心构件;在此基础之上,再去逐步叠加 RoPE 等更多进阶方法。
如果你想亲手搭建这种 GPT-2 风格的模型,我的第一本书《从零开始构建大语言模型》详细拆解了下图所示的所有基础构件。
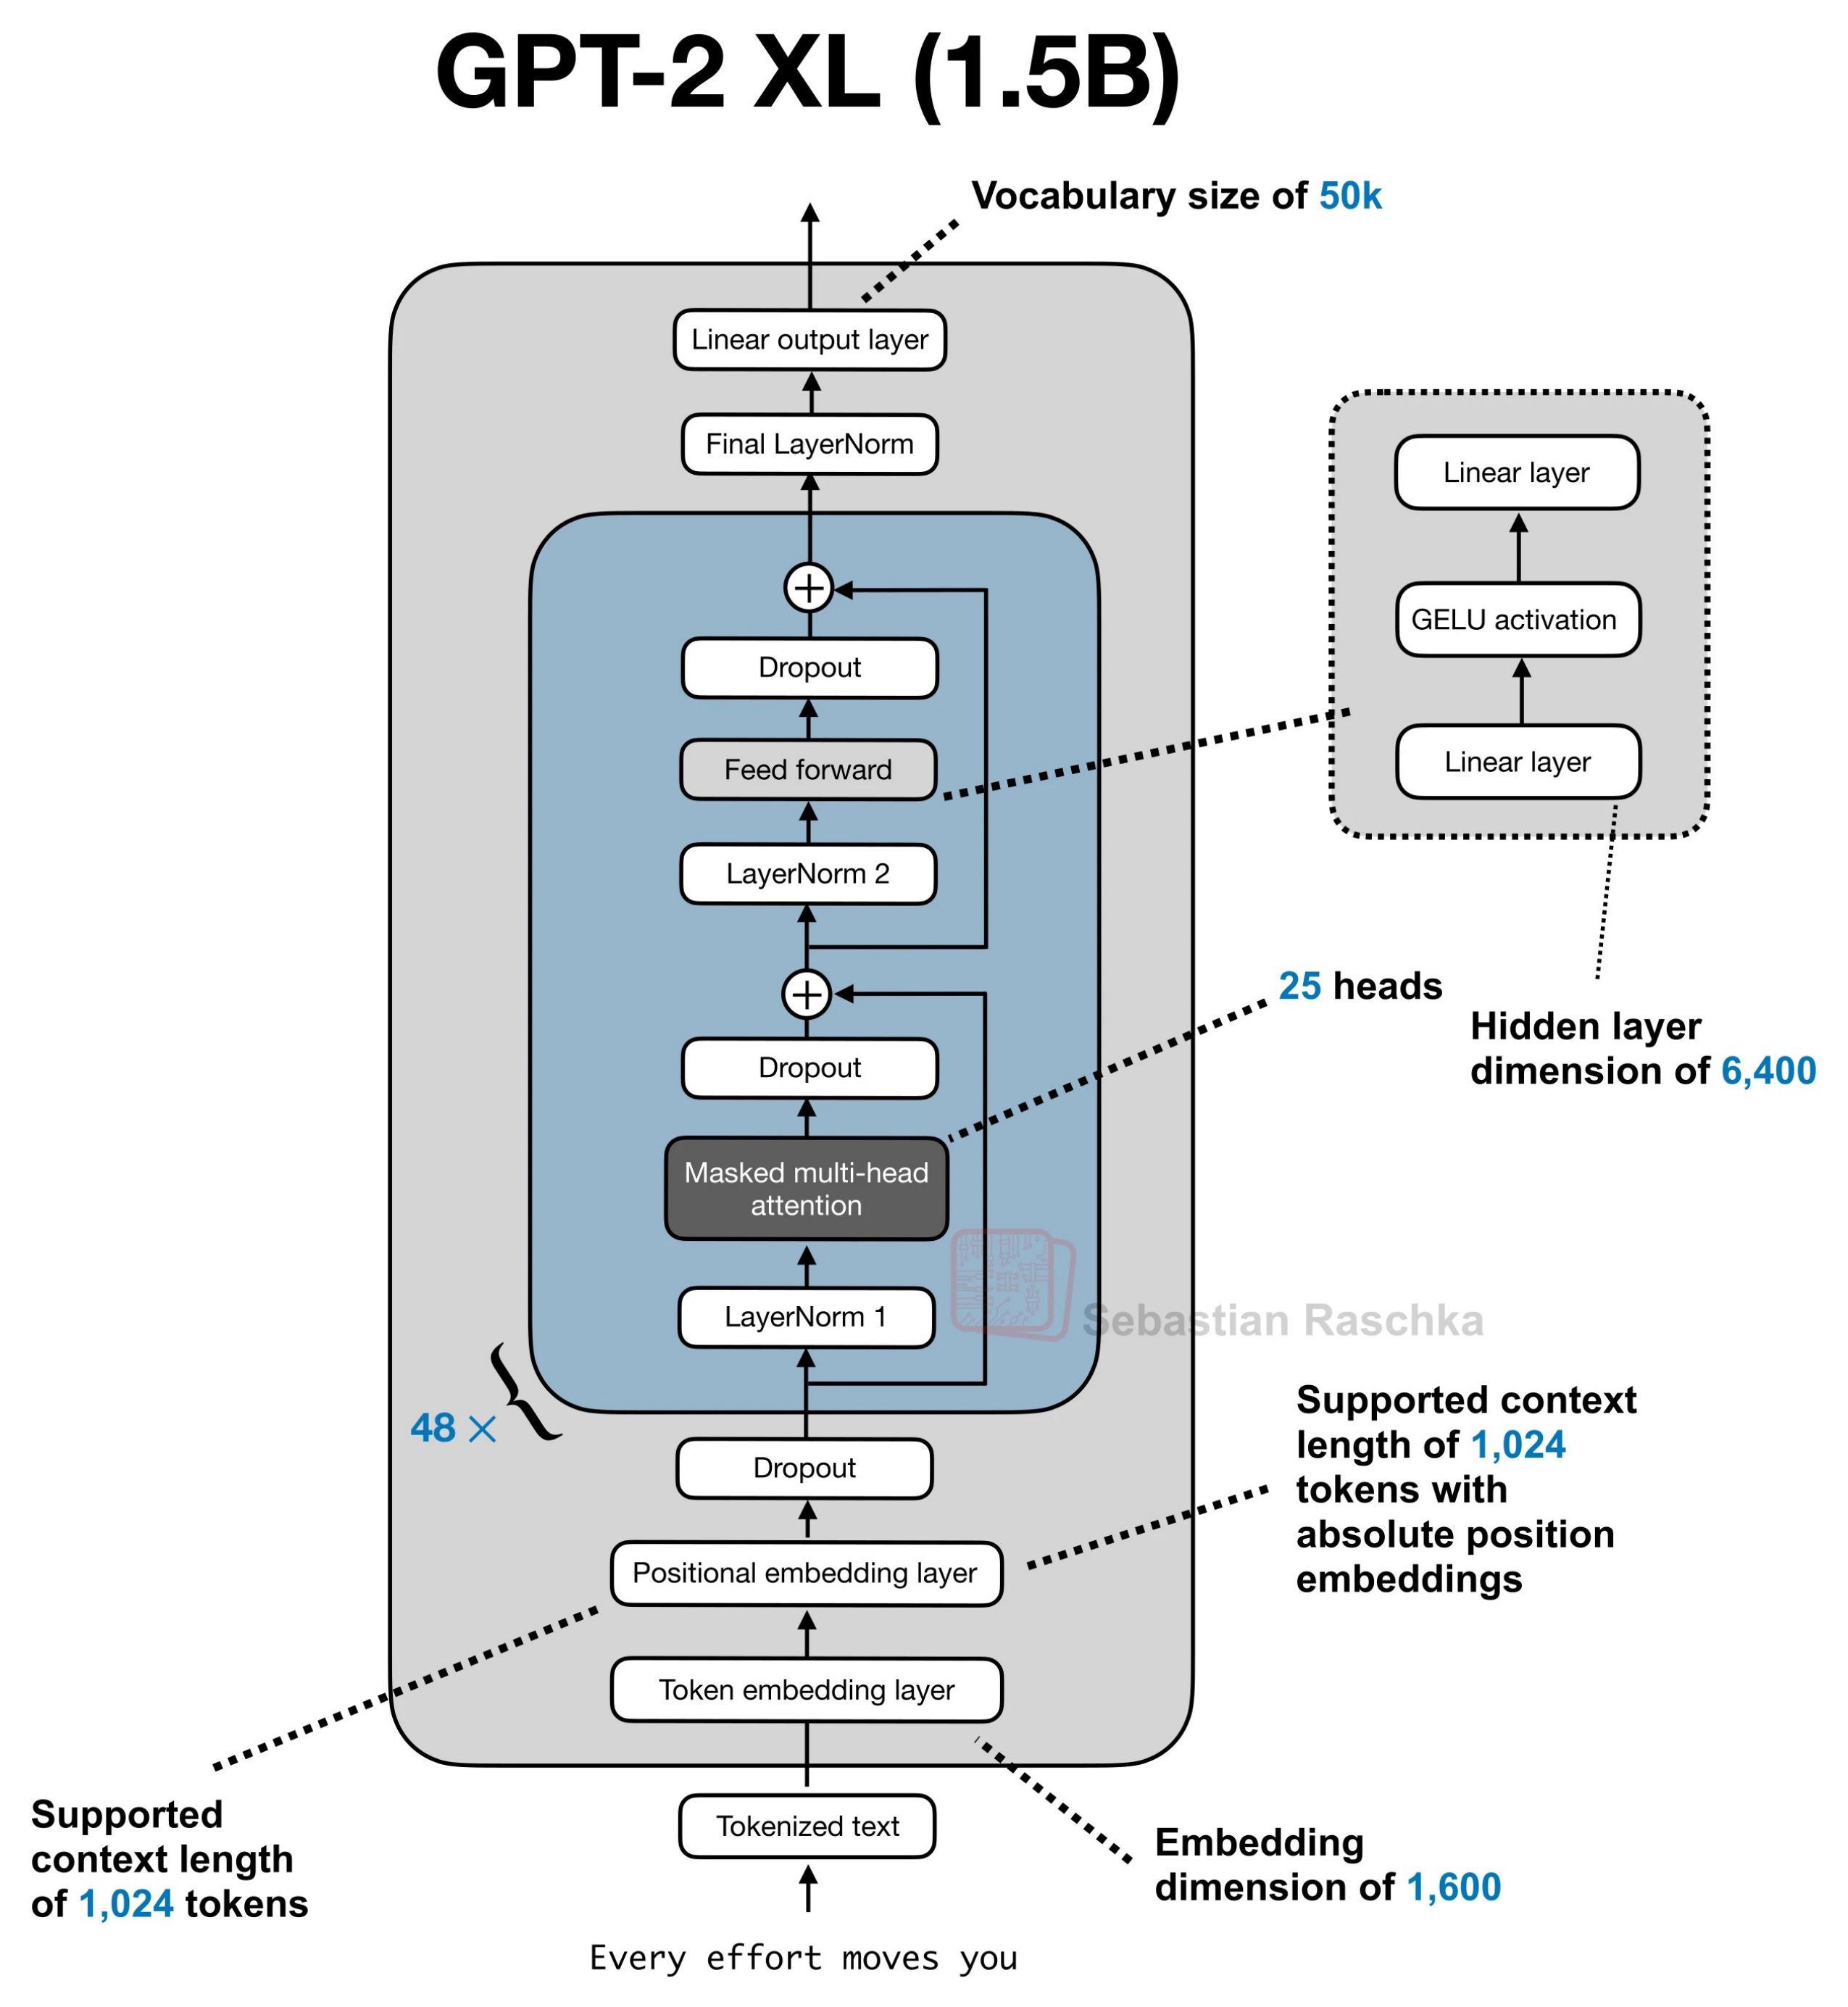
针对从 GPT-2 基准衍生出的各项技术,我整理了以下相关博文,首先从复习自注意力机制开始:
自注意力、因果掩码与多头注意力:深入理解并代码实现 LLM 中的自注意力、多头注意力、因果注意力与交叉注意力
现代注意力变体(GQA、MLA、滑动窗口注意力、稀疏注意力及混合模式):现代大语言模型注意力变体图解指南
KV 缓存:从零理解并实现大语言模型中的 KV 缓存
SwiGLU 前馈层与归一化(LayerNorm 和 RMSNorm):从 GPT-2 到 gpt-oss:解析架构演进
混合专家层与专家路由:大语言模型架构全景对比
残差连接与 DeepSeek 的流形受限超连接(mHC):LLM 架构最新进展:KV 共享、mHC 与压缩注意力
以 Qwen3 为例融会贯通:《从零开始理解并实现 Qwen3》详细讲解了如何在 PyTorch 中实现稠密版与混合专家版。
感谢阅读与支持!
附:我最近开始试用 Substack 新推出的“福利(perks)”功能。为感谢大家的支持,我补充提供了架构图录的高清导出图片与元数据,供大家在自己的分析中按需取用。
来源:Sebastian Raschka (Ahead of AI) · magazine.sebastianraschka.com