RadixArk 发布 DaisyRose-27B 开源长程智能体模型
DaisyRose-27B: Pushing the Frontier of Post-Training Efficiency
RadixArk 正式发布首个开源模型 DaisyRose-27B,基于 Qwen3.8-27B 并采用 Miles 强化学习框架在 1,200 个精选长程智能体任务上完成训练。
展示了通过千条精选长程任务与异步强化学习后训练基座模型,可大幅降低长程智能体训练算力并提升任务表现。
今天,我们正式发布 RadixArk 的首个模型 DaisyRose-27B。该模型基于 Qwen3.8-27B 打造,并使用 Miles 进行强化学习训练。我们在 144 块 H200 GPU 上仅耗时 18 天,使用精选的 1200 个任务进行了长程智能体任务训练,单会话长度最高达 100 万 token。DaisyRose-27B 将 Terminal-Bench 4.1 的 pass@1 从 5.6% 提升至 12.0%。除 Terminal-Bench 4.1 之外,它在多项推理、指令遵循以及代码基准测试中也均有提升。
模型权重基于 Apache 2.0 协议开源:
该模型保留了 Qwen3.8-27B 的架构、分词器、对话模板、图像理解能力以及 256K token 的上下文窗口。对于更长的训练会话,模型利用框架总结(harness summarization)来跨越多条执行轨迹。有关模型属性和推理设置,请参阅模型卡片。
运行 DaisyRose-27B
我们推荐结合 SGLang 与 DSpark 投机解码来部署 DaisyRose-27B。SGLang 指南提供了适用于不同 GPU 及权重格式的启动配置。
使用服务模型名称 DaisyRose-27B 在端口 30000 启动服务后,即可通过 OpenAI Python 客户端发送请求:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:30000/v1",
    api_key="none",
)

response = client.chat.completions.create(
    model="DaisyRose-27B",
    messages=[
        {
            "role": "user",
            "content": "How many positive divisors does 360 have?",
        }
    ],
    temperature=1.0,
    top_p=0.95,
    extra_body={"top_k": 20, "min_p": 0.0},
)

print(response.choices[0].message.reasoning_content)
print(response.choices[0].message.content)
模型默认会“先思考再回答”。其推理过程在 reasoning_content 中返回,最终答案在 content 中返回。这些设置与模型卡片的快速入门保持一致。
基准测试结果
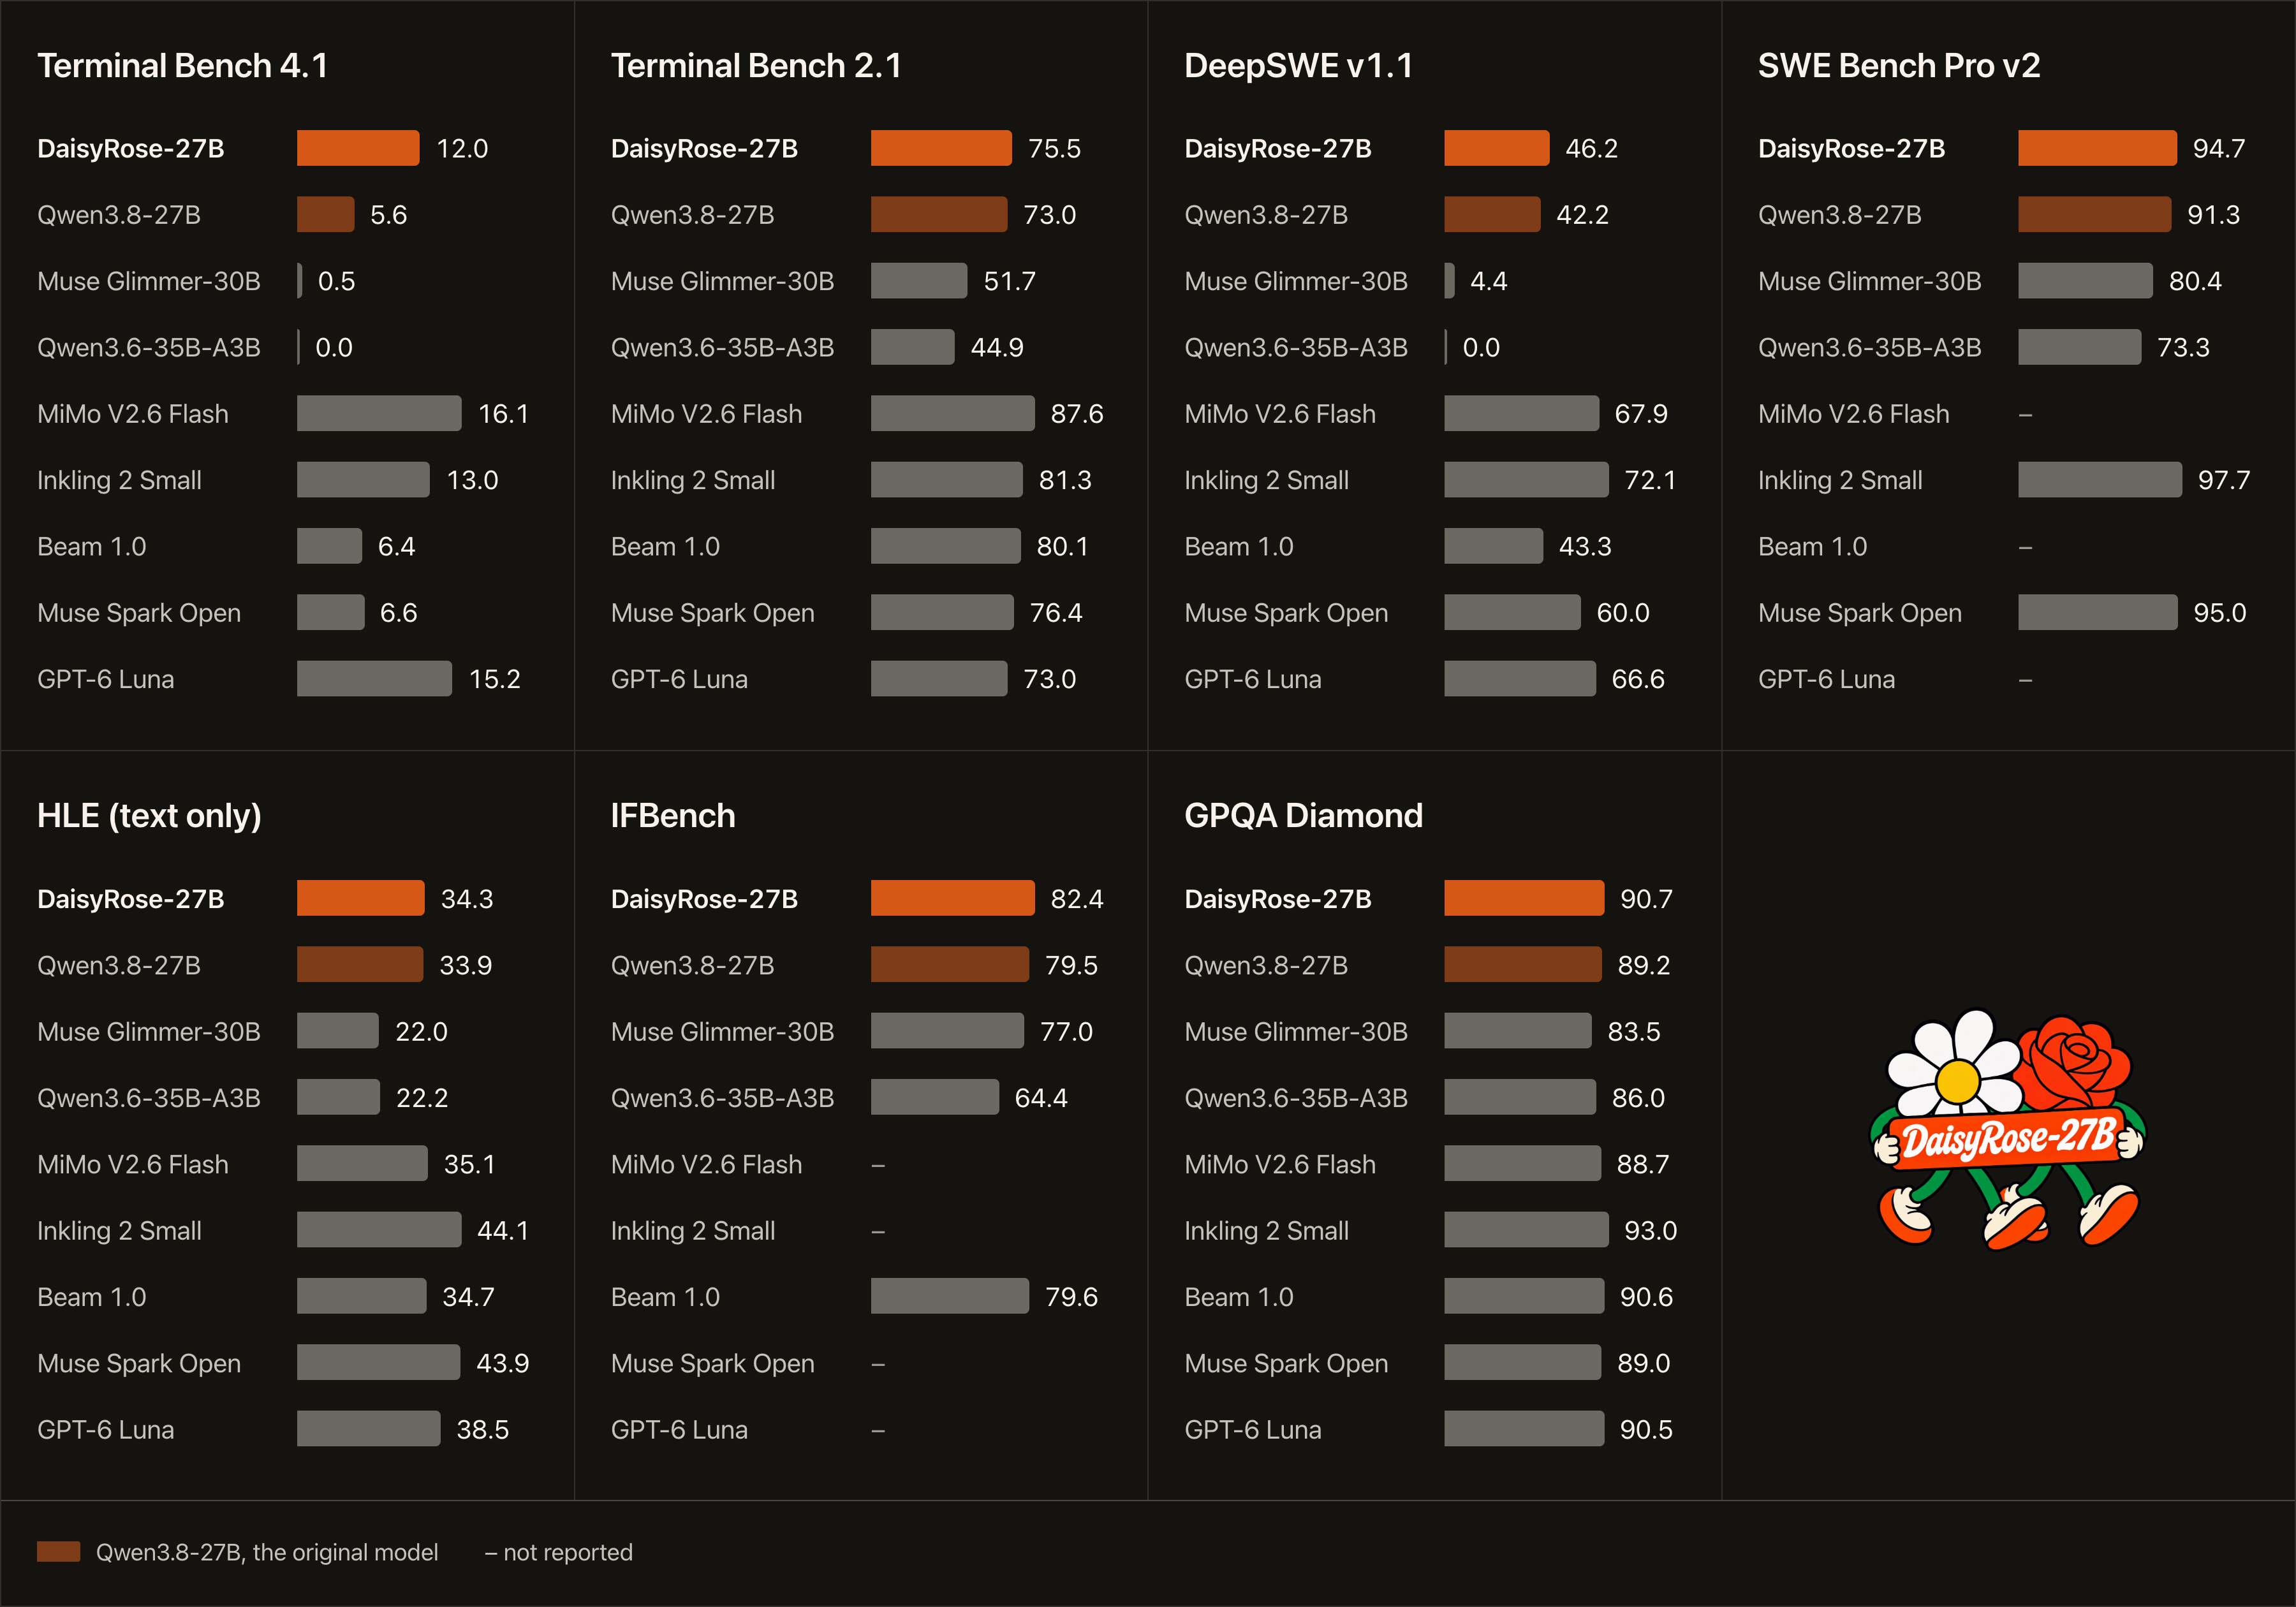
| 基准测试 | Qwen3.8-27B | DaisyRose-27B |
|---|---|---|
| Terminal Bench 4.1 | 5.6 | 12.0 |
| Terminal Bench 2.1 | 73.0 | 75.5 |
| DeepSWE v1.1 | 42.2 | 46.2 |
| SWE Bench Pro v2 | 91.3 | 94.7 |
| HLE(纯文本) | 33.9 | 34.3 |
| IFBench | 79.5 | 82.4 |
| GPQA Diamond | 89.2 | 90.7 |
在上述所有基准测试中,DaisyRose-27B 的得分均高于原版 Qwen3.8-27B 模型。提升最显著的是 Terminal Bench 4.1,pass@1 从 5.6% 跃升至 12.0%。
各基准测试成绩均取 BF16 与 FP8 运行结果中的较高者;在两项均有评测的任务中,两者分差均小于 1 分。对比数据来源和评测设置详见模型卡片。
本次发布能够成真,得益于训练环节的三大支柱:精心设计的任务、高效的训练后端以及可靠的沙箱环境。
高质量训练数据
我们与 Eigent AI 合作构建了这些任务,以其在机器学习、软件工程、科学等领域的庞大任务池为基础,共同打造了数千个候选任务,最终约有 1200 个任务入选最终的训练集。
我们依据以下三项标准来筛选任务:
- 针对原版模型常犯的错误设计任务。我们让 Qwen3.8-27B 在每个任务上运行,并针对我们希望模型纠正的错误重新设计了任务,随后调节难度,直到解答率落入对学习最有帮助的区间。
- 任务需包含多个环环相扣的步骤。智能体必须在较长的任务流程中完成推理、规划与执行。模型在沙箱中的单次尝试最长可达 1.5 小时,包含 100 多次工具调用并输出超过 256K 个 token。
- 任务必须真正解决问题才能给予奖励。我们结合模型的尝试过程对每个任务进行了复审。凡是未能解决目标问题却能蒙混过关的任务,或是本身存在设计缺陷的任务,均被修正或移除。
高效训练后端
RadixArk 使用我们自研的开源大规模模型后训练强化学习框架 Miles,以完全异步模式训练了 DaisyRose-27B:智能体执行任务与模型训练同时进行,两者互不等待。其中 128 块 H200 负责运行智能体任务的推理,另外 16 块运行训练器并从生成的轨迹中学习。每完成一步训练,更新后的模型就会分发给负责运行智能体的 128 块 GPU。训练依托于我们专为智能体训练打造的内部后端运行:每一步都从少数极长的会话(部分长达 100 万 token)中学习,并通过测试框架摘要折叠成多条轨迹。
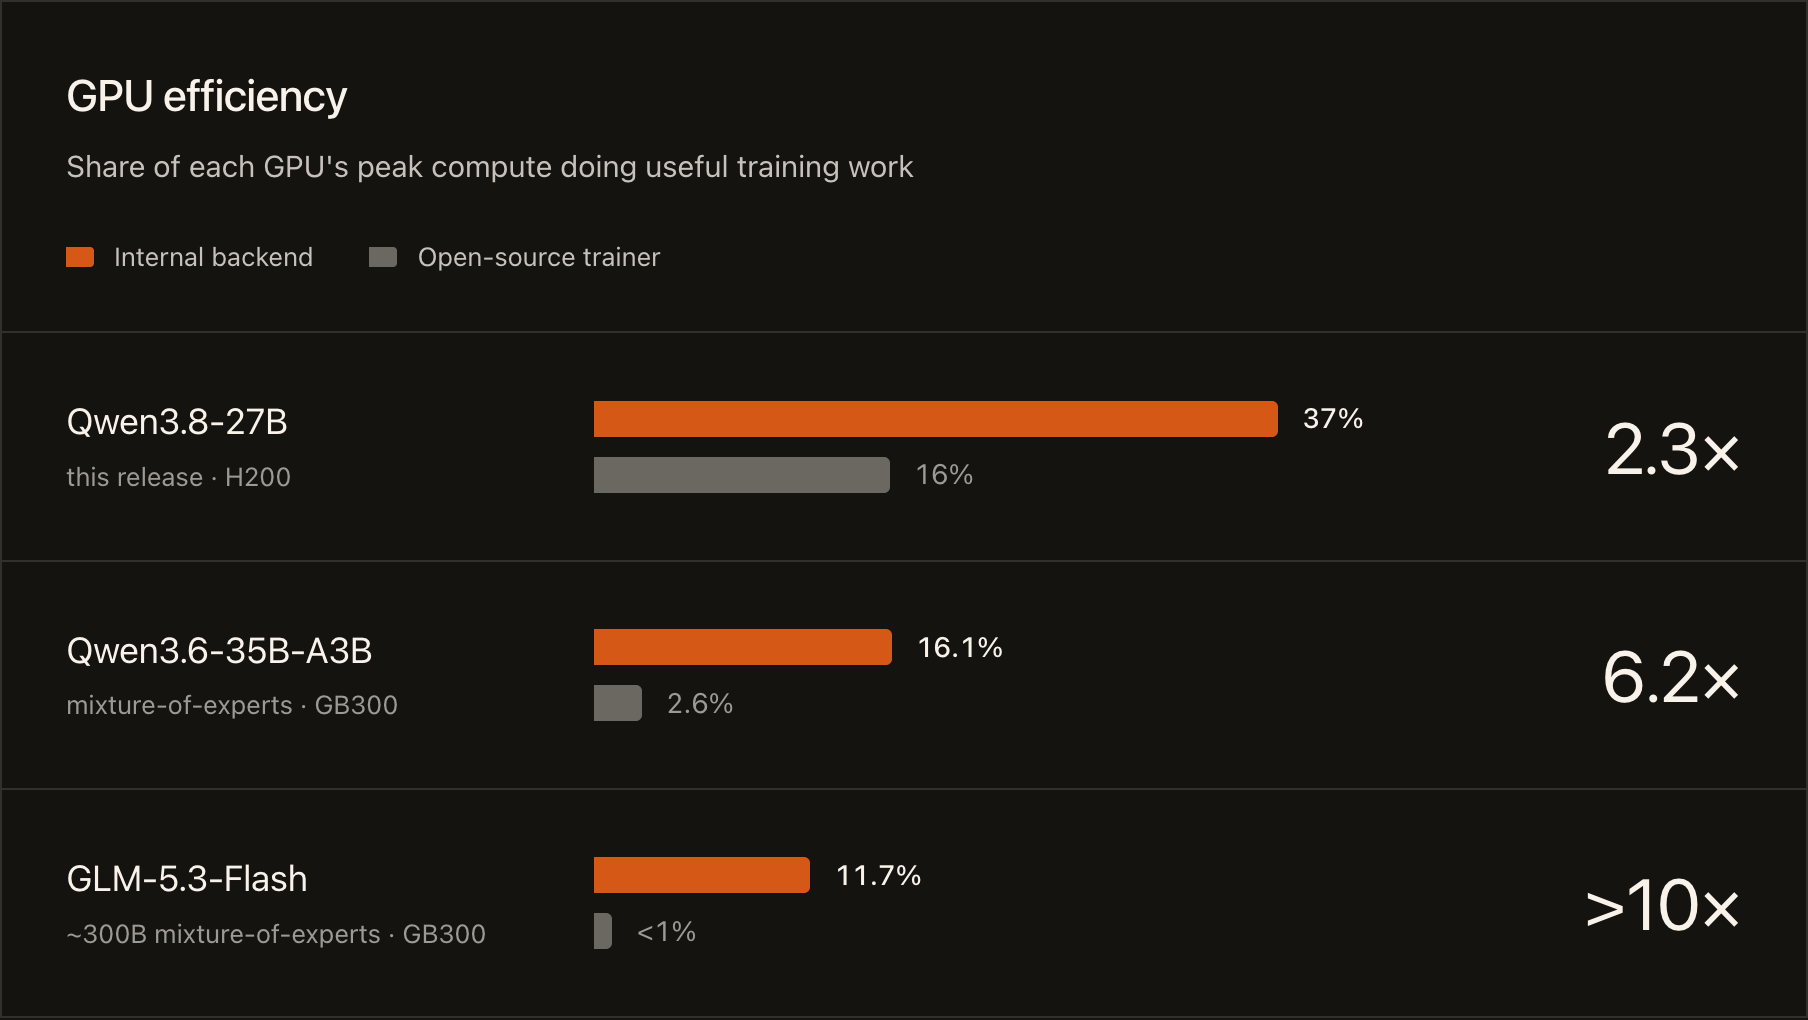
训练成本降低 57%。在本次发布的版本中,使用我们的后端时,每块 GPU 峰值算力中转化为有效训练工作的比例(模型 FLOPs 利用率,简称 MFU)达到了 37%。相比之下,基于 Megatron 构建的开源训练器在类似运行中仅达到 16%。这意味着完成相同的训练任务可减少 57% 的 GPU 耗时。在混合专家(MoE)模型上,这一提升更为显著:在 Qwen3.6-35B-A3B 上提升了 6.2 倍,在参数量约 3000 亿的 GLM-5.3-Flash 上更是提升了 10 倍以上。
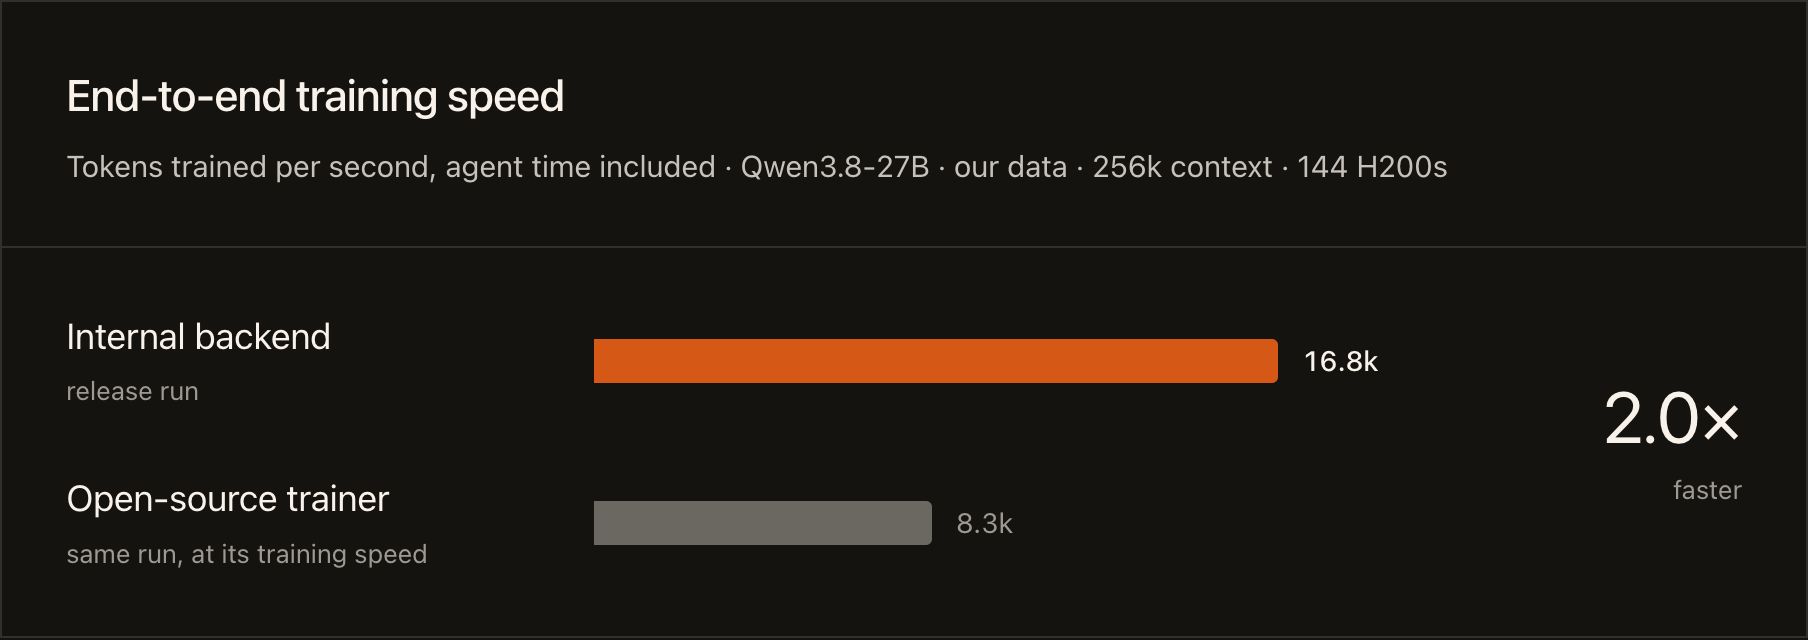
端到端速度提升 2 倍。如果算上智能体执行任务的时间,本次发布所用的 144 块 GPU 每秒总计可训练约 16,800 个 token;而开源训练器在相同 GPU 配置下仅达到约 8,300 个 token/s。
数周运行持续稳定。本次发布在 144 块 H200 上连续训练了数周,累计达 63,000 GPU 小时。从第一步到最后一步,训练速度与效率始终保持稳定。
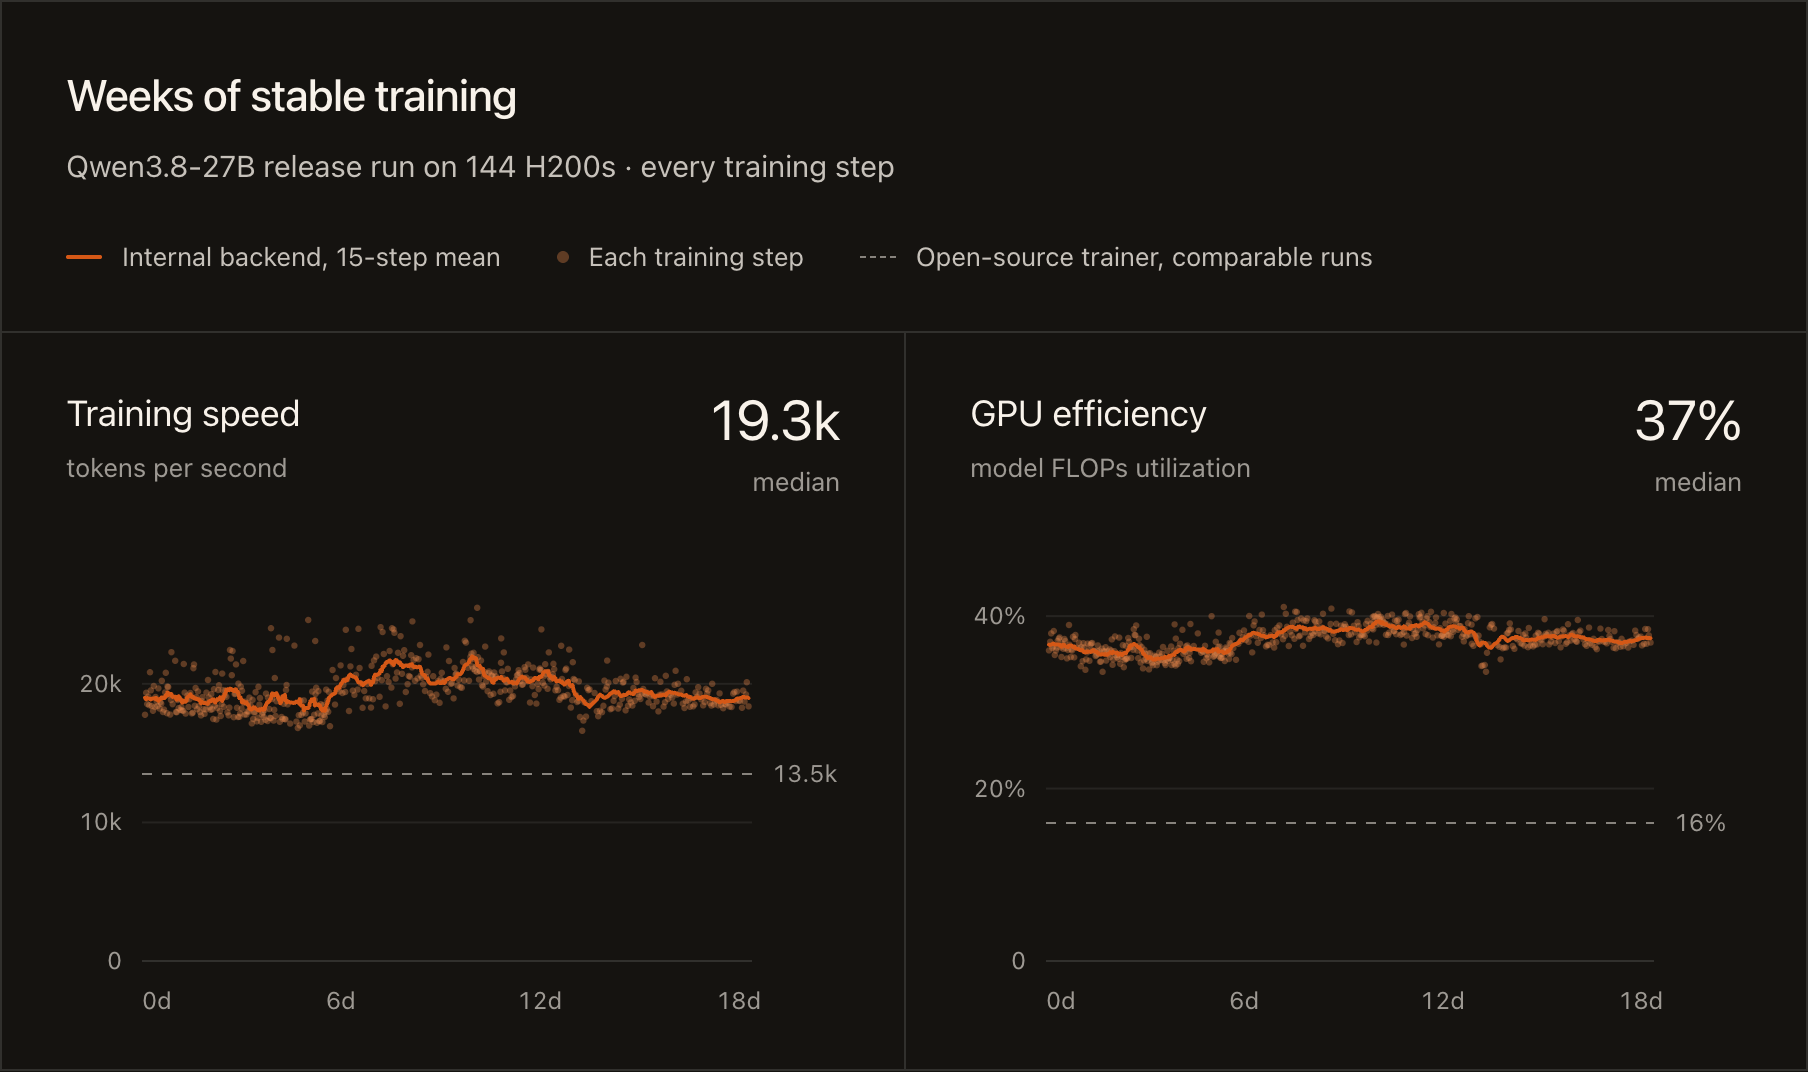
图为在 144 块 H200 上运行 DaisyRose-27B 发布版本的每一步训练情况,横轴为总训练时间。虚线代表开源训练器在类似运行中的表现。
高可靠沙盒服务
每一次训练尝试都在沙盒中运行:这是任务环境的一个全新副本,智能体在其中执行命令、修改文件,随后接受评分。
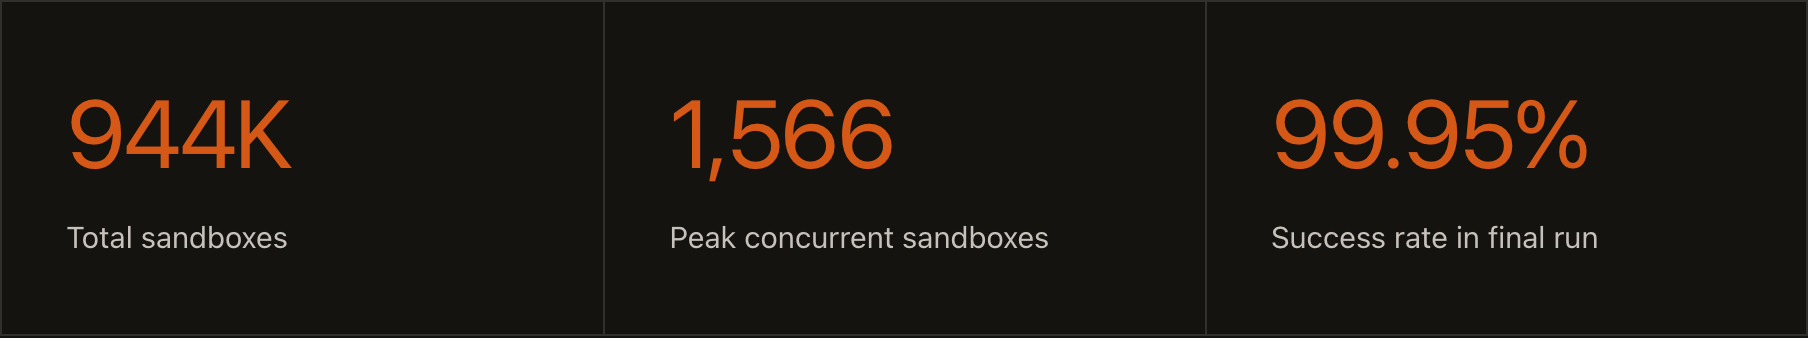
我们的服务基于开源项目 AgentENV 构建,我们也一直在向该项目回馈修复代码。9 月中旬至 11 月中旬期间,该服务为本项目运行了约 944,000 个沙盒,峰值并发运行达 1,566 个。
该服务所用的服务器也从 1 台扩展到了最多 12 台。期间我们完成了 10 次系统升级,且几乎全部在训练进行时无缝完成。在整整 9 周的时间里,沙盒创建成功率达 99%;自 10 月下旬以来,这一数字更是超过了 99.95%。
相比使用主流云沙盒服务商运行相同沙盒,本项目的云基础设施成本降低了约 80%。我们降低成本的秘诀之一,是让每个沙盒的内存分配根据实际使用动态伸缩,从而让单台机器能够容纳更多沙盒共享资源。
上手体验或自行训练
欢迎下载 DaisyRose-27B,参考 SGLang 部署指南,或使用 Miles 训练属于你自己的智能体。
我们非常期待了解 DaisyRose-27B 在你具体任务中的表现,也欢迎指出它的不足之处。欢迎在模型的 Community 页面分享你的配置和测试结果。
感谢 Eigent AI 在训练数据方面与我们的紧密合作,感谢 Qwen 团队打造了 Qwen3.8-27B。同时感谢 Miles 和 SGLang 社区,以及 slime、AgentENV 和 Harbor 等开源项目的大力支持。
本文根据 RadixArk 原文编译。
来源:Hugging Face Blog · huggingface.co